1.1. 简介
1.1.1. 图形处理器
图形处理器(GPU)最初作为 3D 图形的专用处理器而诞生,起初是用于加速实时 3D 渲染中并行操作的固定功能硬件。经过连续多代的发展,GPU 的可编程性不断增强。到 2003 年,图形流水线中的一些阶段已变得完全可编程,能够针对 3D 场景或图像的每个组成部分并行运行自定义代码。
2006 年,NVIDIA 推出了统一计算设备架构(CUDA),使任何计算工作负载都能独立于图形 API 利用 GPU 的吞吐能力。
此后,CUDA 和 GPU 计算被用于加速几乎所有类型的计算工作负载,从流体动力学或能量传输等科学仿真,到数据库和分析等商业应用。此外,GPU 的能力和可编程性一直是推动新算法和新技术发展的基础,这些算法和技术涵盖从图像分类到扩散模型或大语言模型等生成式人工智能的广泛领域。
1.1.2. 使用 GPU 的优势
在相近的价格和功耗范围内,GPU 可提供远高于 CPU 的指令吞吐量和内存带宽。许多应用利用这些能力,在 GPU 上的运行速度显著快于在 CPU 上的运行速度(参见GPU 应用)。其他计算设备,例如 FPGA,也具有很高的能效,但其编程灵活性远不及 GPU。
GPU 与 CPU 的设计目标不同。CPU 的设计侧重于尽可能快地执行串行操作序列(称为线程),并且能够并行执行几十个这样的线程;GPU 的设计则侧重于并行执行数千个线程,以较低的单线程性能为代价,换取大得多的总吞吐量。
GPU 专为高度并行的计算而设计,将更多晶体管用于数据处理单元,而 CPU 则将更多晶体管用于数据缓存和流程控制。图 1展示了 CPU 与 GPU 芯片资源分配的对比示例。
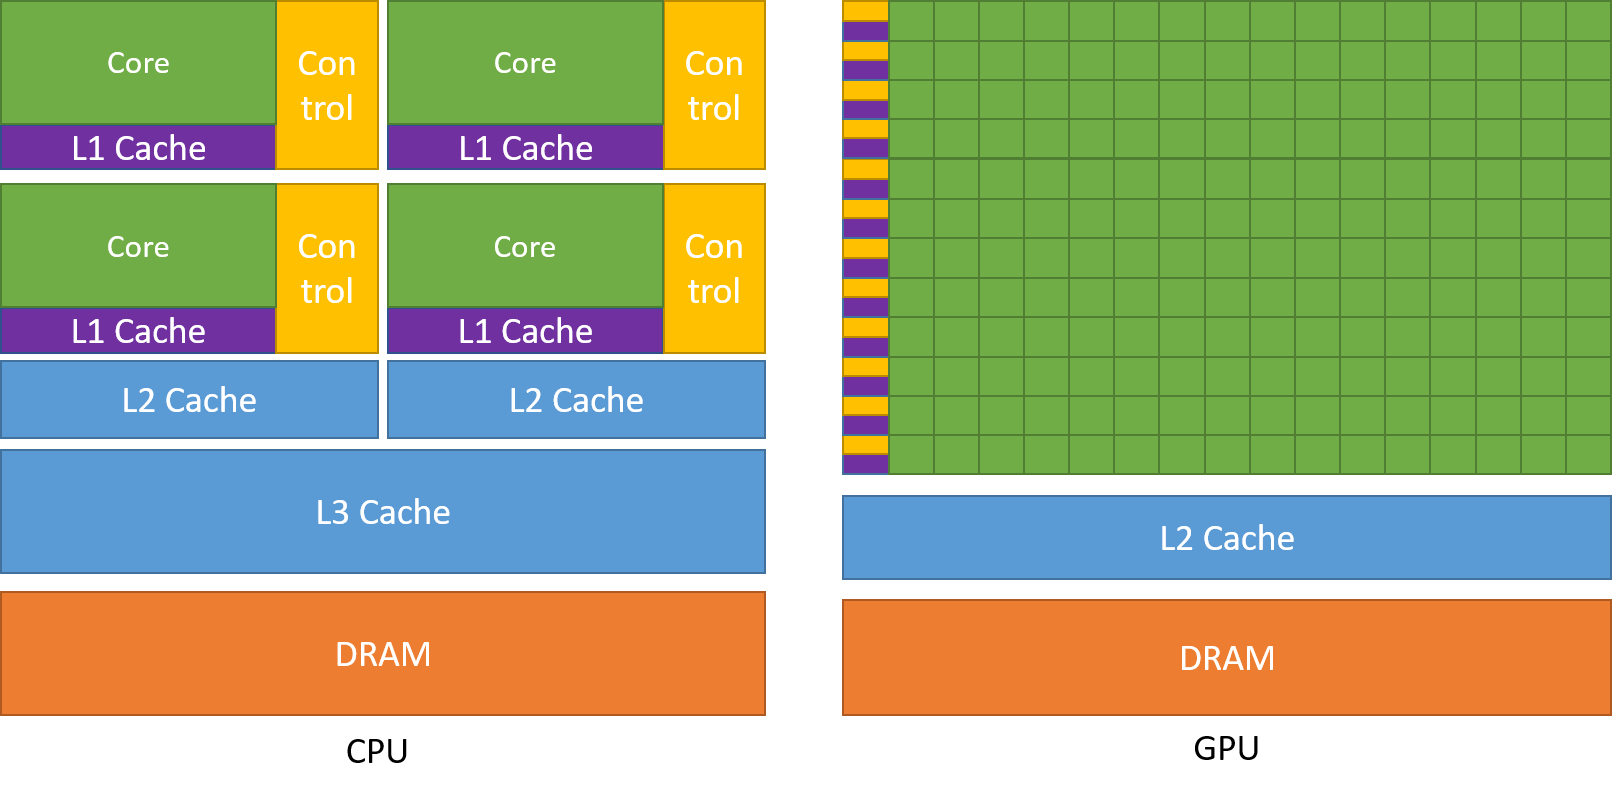
图 1 GPU 将更多晶体管用于数据处理
图内文字中文对照
Core- 核心
L1 Cache- L1 缓存
L2 Cache- L2 缓存
L3 Cache- L3 缓存
Control- 控制
1.1.3. 快速入门
利用 GPU 所提供计算能力的方式有很多。本指南介绍如何使用 C++ 等高级语言面向 CUDA GPU 平台进行编程。不过,在应用中利用 GPU 还有许多不需要直接编写 GPU 代码的方式。
通过专用库,可以使用来自各种领域且不断增加的算法和例程。如果某个库已经实现,尤其是 NVIDIA 提供的库,使用它通常比从头重新实现算法具有更高的开发效率和更好的性能。cuBLAS、cuFFT、cuDNN 和 CUTLASS 等只是其中的几个例子,这些库可帮助开发者避免重新实现成熟算法。这些库还有一个额外的优势,即针对每种 GPU 架构进行了优化,实现了开发效率、性能和可移植性的理想结合。
还有一些框架,尤其是用于人工智能的框架,提供了 GPU 加速的基础构件。其中许多框架通过利用上述 GPU 加速库来实现加速。
此外,NVIDIA 的 Warp 或 OpenAI 的 Triton 等领域专用语言(DSL)经过编译后可直接在 CUDA 平台上运行。与本指南涵盖的高级语言相比,这提供了一种抽象层次更高的 GPU 编程方式。
NVIDIA 加速计算中心包含用于教授 GPU 和 CUDA 计算的资源、示例和教程。