4.13. 使用簇启动控制进行工作窃取
开发 CUDA 应用程序时,处理数据规模和计算规模可变的问题至关重要。传统上,CUDA 开发者使用两种主要方法来确定要启动的核函数线程块数量:每个线程块的工作量固定和线程块数量固定。这两种方法各有优缺点。
每个线程块的工作量固定:在这种方法中,线程块数量由问题规模决定,而每个线程块执行的工作量保持不变。
这种方法的主要优点:
SM 之间的负载均衡
当线程块的运行时间存在差异,并且/或者线程块数量远大于 GPU 能够同时执行的数量(产生较小的尾部效应)时,这种方法允许 GPU 调度器在某些 SM 上运行比其他 SM 更多的线程块。
抢占
即使较高优先级的核函数是在较低优先级的核函数已经开始执行之后才启动的,GPU 调度器也可以在较低优先级核函数的线程块完成时调度较高优先级核函数的线程块,从而开始执行较高优先级的核函数。随后,一旦较高优先级的核函数执行完毕,就可以恢复执行较低优先级的核函数。
线程块数量固定:在这种方法中,线程块数量不依赖于问题规模,通常以块步长循环或网格步长循环实现。相反,每个线程块执行的工作量是问题规模的函数。通常,线程块数量取决于执行核函数的 GPU 上的 SM 数量以及期望的占用率。
这种方法的主要优点:
降低线程块开销
这种方法不仅降低了摊销后的线程块启动延迟,还尽量减少了与所有线程块共同执行的操作相关的计算开销。这些开销可能显著高于启动延迟开销。
例如,在卷积核函数中,由于线程块数量固定,用于计算卷积系数且与线程块索引无关的前导计算可以执行更少的次数,从而减少冗余计算。
簇启动控制是 NVIDIA Blackwell GPU 架构(计算能力 10.0)引入的一项功能,旨在结合前述两种方法的优点。它允许开发者取消线程块或线程块簇,从而对线程块调度拥有更多控制权。这一机制支持工作窃取。工作窃取是并行计算中的一种动态负载均衡技术,空闲处理器主动从繁忙处理器的工作队列中“窃取”任务,而不是等待被分配工作。
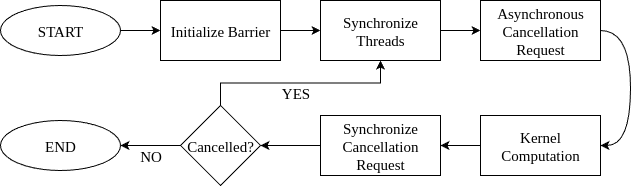
图 54 簇启动控制流程
图内文字中文对照
START- 开始
Initialize Barrier- 初始化屏障
Synchronize Threads- 同步线程
Asynchronous Cancellation Request- 异步取消请求
Kernel Computation- 核函数计算
Synchronize Cancellation Request- 同步取消请求
Cancelled?- 是否已取消?
YES- 是
NO- 否
END- 结束
借助簇启动控制,一个线程块会尝试取消另一个尚未开始执行的线程块的启动。如果取消请求成功,它就会使用另一个线程块的索引来执行任务,从而“窃取”其工作。如果没有更多可用的线程块索引,或者由于其他原因,例如正在调度较高优先级的核函数,取消操作就会失败。在后一种情况下,如果线程块在取消失败后退出,调度器就可以开始执行较高优先级的核函数,之后将继续调度当前核函数剩余的线程块执行。上图展示了这一过程的执行流程。
下表总结了这三种方法的优缺点:
每个线程块的工作量固定 |
线程块数量固定 |
簇启动控制 |
|
|---|---|---|---|
降低开销 |
|
|
|
抢占 |
|
|
|
负载均衡 |
|
|
|
4.13.1. API 细节
通过簇启动控制 API 取消线程块是异步执行的,并使用共享内存屏障进行同步,遵循与异步数据复制类似的编程模式。
该 API 通过libcu++提供,包含:
一条请求指令,用于将编码后的取消结果写入
__shared__变量。用于提取成功/失败状态和被取消线程块索引的解码指令。
注意,簇启动控制操作被建模为异步代理操作(参见异步线程和异步代理)。
4.13.1.1. 线程块取消
使用簇启动控制的首选方式是由单个线程发起,即一次一个请求。
取消过程包含五个步骤:
设置阶段(步骤 1-2):声明并初始化取消结果变量和同步变量。
工作窃取循环(步骤 3-5):重复执行,以请求、同步并处理取消结果。
声明用于线程块取消的变量:
__shared__ uint4 result; // Request result.
__shared__ uint64_t bar; // Synchronization barrier.
int phase = 0;           // Synchronization barrier phase.
将共享内存屏障的到达计数初始化为 1:
if (cg::thread_block::thread_rank() == 0)
    ptx::mbarrier_init(&bar, 1);
__syncthreads();
由单个线程提交异步取消请求,并设置事务计数:
if (cg::thread_block::thread_rank() == 0) {
    cg::invoke_one(cg::coalesced_threads(), [&](){ptx::clusterlaunchcontrol_try_cancel(&result, &bar);});
    ptx::mbarrier_arrive_expect_tx(ptx::sem_relaxed, ptx::scope_cta, ptx::space_shared, &bar, sizeof(uint4));
}
注意
由于线程块取消是一条一致指令,建议在invoke_one线程选择器内提交它。这使编译器能够优化掉剥离循环。
同步(完成)异步取消请求:
while (!ptx::mbarrier_try_wait_parity(&bar, phase))
{}
phase ^= 1;
获取取消状态和被取消线程块的索引:
bool success = ptx::clusterlaunchcontrol_query_cancel_is_canceled(result);
if (success) {
    // Don't need all three for 1D/2D thread blocks:
    int bx = ptx::clusterlaunchcontrol_query_cancel_get_first_ctaid_x(result);
    int by = ptx::clusterlaunchcontrol_query_cancel_get_first_ctaid_y(result);
    int bz = ptx::clusterlaunchcontrol_query_cancel_get_first_ctaid_z(result);
}
确保异步和通用代理之间共享内存操作的可见性,并防止工作窃取循环各次迭代之间发生数据竞争。
4.13.1.2. 线程块取消的约束
这些约束与失败的取消请求有关:
在观察到先前的请求失败后再提交另一个取消请求属于未定义行为。
在下面的两个代码示例中,假设第一个取消请求失败,则只有第一个示例表现出未定义行为。第二个示例是正确的,因为在两个取消请求之间没有进行观察:
无效代码:
// First request:
ptx::clusterlaunchcontrol_try_cancel(&result0, &bar0);

// First request query:
[Synchronize bar0 code here.]
bool success0 = ptx::clusterlaunchcontrol_query_cancel_is_canceled(result0);
assert(!success0); // Observed failure; second cancellation will be invalid.

// Second request - next line is Undefined Behavior:
ptx::clusterlaunchcontrol_try_cancel(&result1, &bar1);
有效代码:
// First request:
ptx::clusterlaunchcontrol_try_cancel(&result0, &bar0);

// Second request:
ptx::clusterlaunchcontrol_try_cancel(&result1, &bar1);

// First request query:
[Synchronize bar0 code here.]
bool success0 = ptx::clusterlaunchcontrol_query_cancel_is_canceled(result0);
assert(!success0); // Observed failure; second cancellation was valid.
获取失败的取消请求所对应的线程块索引属于未定义行为。
不建议由多个线程提交取消请求。这会导致多个线程块被取消,需要谨慎处理,例如:
每个提交请求的线程都必须提供唯一的
__shared__结果指针,以避免数据竞争。如果使用同一个屏障进行同步,则必须相应调整到达计数和事务计数。
4.13.2. 示例:向量与标量乘法
在以下小节中,我们通过一个向量与标量乘法核函数,演示如何通过簇启动控制进行工作窃取。我们展示同一问题的两种变体:一种使用线程块,另一种使用线程块簇。
4.13.2.1. 用例:线程块
下面的三个核函数演示了用于向量与标量乘法的每个线程块的工作量固定、线程块数量固定和簇启动控制方法。
每个线程块的工作量固定:
__global__
void kernel_fixed_work (float* data, int n)
{
    // Prologue:
    float alpha = compute_scalar();

    // Computation:
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n)
        data[i] *= alpha;
}

// Launch: kernel_fixed_work<<<(n + 1023) / 1024, 1024>>>(data, n);
线程块数量固定:
__global__
void kernel_fixed_blocks (float* data, int n)
{
    // Prologue:
    float alpha = compute_scalar();

    // Computation:
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    while (i < n) {
        data[i] *= alpha;
        i += gridDim.x * blockDim.x;
    }
}

// Launch: kernel_fixed_blocks<<<SM_COUNT, 1024>>>(data, n);
簇启动控制:
#include <cooperative_groups.h>
#include <cuda/ptx>

namespace cg = cooperative_groups;
namespace ptx = cuda::ptx;

__global__
void kernel_cluster_launch_control (float* data, int n)
{
    // Cluster launch control initialization:
    __shared__ uint4 result;
    __shared__ uint64_t bar;
    int phase = 0;

    if (cg::thread_block::thread_rank() == 0)
        ptx::mbarrier_init(&bar, 1);

    // Prologue:
    float alpha = compute_scalar(); // Device function not shown in this code snippet.

    // Work-stealing loop:
    int bx = blockIdx.x; // Assuming 1D x-axis thread blocks.

    while (true) {
        // Protect result from overwrite in the next iteration,
        // (also ensure barrier initialization at 1st iteration):
        __syncthreads();

        // Cancellation request:
        if (cg::thread_block::thread_rank() == 0) {
            // Acquire write of result in the async proxy:
            ptx::fence_proxy_async_generic_sync_restrict(ptx::sem_acquire, ptx::space_cluster, ptx::scope_cluster);

            cg::invoke_one(cg::coalesced_threads(), [&](){ptx::clusterlaunchcontrol_try_cancel(&result, &bar);});
            ptx::mbarrier_arrive_expect_tx(ptx::sem_relaxed, ptx::scope_cta, ptx::space_shared, &bar, sizeof(uint4));
        }

        // Computation:
        int i = bx * blockDim.x + threadIdx.x;
        if (i < n)
            data[i] *= alpha;

        // Cancellation request synchronization:
        while (!ptx::mbarrier_try_wait_parity(ptx::sem_acquire, ptx::scope_cta, &bar, phase))
        {}
        phase ^= 1;

        // Cancellation request decoding:
        bool success = ptx::clusterlaunchcontrol_query_cancel_is_canceled(result);
        if (!success)
            break;

        bx = ptx::clusterlaunchcontrol_query_cancel_get_first_ctaid_x<int>(result);

        // Release read of result to the async proxy:
        ptx::fence_proxy_async_generic_sync_restrict(ptx::sem_release, ptx::space_shared, ptx::scope_cluster);
    }
}

// Launch: kernel_cluster_launch_control<<<(n + 1023) / 1024, 1024>>>(data, n);
4.13.2.2. 用例:线程块簇
对于线程块簇,线程块取消的步骤与非簇情形相同,仅需略作调整。与非簇情形一样,不建议由簇内多个线程提交取消请求,因为这将尝试取消多个簇。
取消请求由簇中的单个线程提交。
每个簇的各线程块的共享内存结果都会接收到相同的已取消线程块索引的(编码后的)值(即,结果值通过多播发送)。所有线程块接收到的结果都对应于簇内的局部块索引
{0, 0, 0}。因此,簇内的线程块需要加上局部块索引。同步由每个簇的各线程块使用局部
__shared__内存屏障来执行。屏障操作必须在ptx::scope_cluster作用域内执行。在簇的情况下,取消操作要求所有线程块都存在。用户可以通过使用sync API 中的
cg::cluster_group::sync()来保证所有线程块都在运行。
下面的核函数演示了使用线程块簇的簇启动控制方法。
#include <cooperative_groups.h>
#include <cuda/ptx>

namespace cg = cooperative_groups;
namespace ptx = cuda::ptx;

__global__ __cluster_dims__(2, 1, 1)
void kernel_cluster_launch_control (float* data, int n)
{
    // Cluster launch control initialization:
    __shared__ uint4 result;
    __shared__ uint64_t bar;
    int phase = 0;

    if (cg::thread_block::thread_rank() == 0) {
        ptx::mbarrier_init(&bar, 1);
        ptx::fence_mbarrier_init(ptx::sem_release, ptx::scope_cluster); // CGA-level fence.
    }

    // Prologue:
    float alpha = compute_scalar(); // Device function not shown in this code snippet.

    // Work-stealing loop:
    int bx = blockIdx.x; // Assuming 1D x-axis thread blocks.

    while (true) {
        // Protect result from overwrite in the next iteration,
        // (also ensure all thread blocks have started at 1st iteration):
        cg::cluster_group::sync();

        // Cancellation request by a single cluster thread:
        if (cg::cluster_group::thread_rank() == 0) {
            // Acquire write of result in the async proxy:
            ptx::fence_proxy_async_generic_sync_restrict(ptx::sem_acquire, ptx::space_cluster, ptx::scope_cluster);

            cg::invoke_one(cg::coalesced_threads(), [&](){ptx::clusterlaunchcontrol_try_cancel_multicast(&result, &bar);});
        }

        // Cancellation completion tracked by each thread block:
        if (cg::thread_block::thread_rank() == 0)
            ptx::mbarrier_arrive_expect_tx(ptx::sem_relaxed, ptx::scope_cluster, ptx::space_shared, &bar, sizeof(uint4));

        // Computation:
        int i = bx * blockDim.x + threadIdx.x;
        if (i < n)
            data[i] *= alpha;

        // Cancellation request synchronization:
        while (!ptx::mbarrier_try_wait_parity(ptx::sem_acquire, ptx::scope_cluster, &bar, phase))
        {}
        phase ^= 1;

        // Cancellation request decoding:
        bool success = ptx::clusterlaunchcontrol_query_cancel_is_canceled(result);
        if (!success)
            break;

        bx = ptx::clusterlaunchcontrol_query_cancel_get_first_ctaid_x<int>(result);
        bx += cg::cluster_group::block_index().x; // Add local offset.

        // Release read of result to the async proxy:
        ptx::fence_proxy_async_generic_sync_restrict(ptx::sem_release, ptx::space_shared, ptx::scope_cluster);
    }
}

// Launch: kernel_cluster_launch_control<<<(n + 1023) / 1024, 1024>>>(data, n);