4.2. CUDA 图
CUDA 图提供了 CUDA 中用于提交工作的另一种模型。图是一系列通过依赖关系连接的操作,例如核函数启动、数据移动等。图的定义与其执行彼此分离。这使得图可以只定义一次,然后重复启动。将图的定义与其执行分离,可以实现多项优化:首先,与流相比,CPU 启动开销降低,因为大部分设置工作都是提前完成的;其次,将整个工作流呈现给 CUDA,可实现流的逐项工作提交机制可能无法实现的优化。
要了解图所能实现的优化,请考虑流中发生的情况:当你将一个核函数放入流中时,主机驱动程序会执行一系列操作,为该核函数在 GPU 上执行做好准备。这些操作是设置和启动核函数所必需的,是每个发出的核函数都必须承担的额外开销。对于执行时间较短的 GPU 核函数,这种额外开销可能占总体端到端执行时间的很大一部分。通过创建一个包含将被多次启动的工作流的 CUDA 图,可以在实例化期间为整个图一次性承担这些额外开销,随后就能以很小的额外开销重复启动图本身。
4.2.1. 图结构
一个操作构成图中的一个节点。操作之间的依赖关系就是边。这些依赖关系约束着操作的执行顺序。
一旦某个操作所依赖的节点完成,该操作就可以在任何时候被调度。调度由 CUDA 系统决定。
4.2.1.1. 节点类型
图节点可以是以下类型之一:
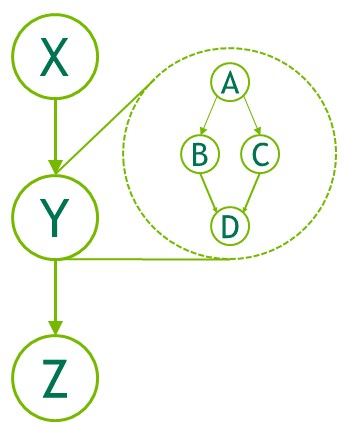
图 24 子图示例
4.2.1.2. 边数据
CUDA 12.3 在 CUDA 图中引入了边数据。目前,非默认边数据的唯一用途是启用程序化依赖启动。
一般而言,边数据会修改一条边所指定的依赖关系,并由三部分组成:输出端口、输入端口和类型。输出端口指定关联的边何时被触发。输入端口指定节点的哪一部分依赖于关联的边。类型会修改端点之间的关系。
端口值取决于节点类型和方向,而边类型可能仅限于特定的节点类型。在所有情况下,零初始化的边数据都表示默认行为。输出端口 0 等待整个任务,输入端口 0 阻塞整个任务,而边类型 0 与具有内存同步行为的完全依赖关系相关联。
在各种图 API 中,可以通过与关联节点一一对应的数组来选择性地指定边数据。如果将其作为输入参数省略,则使用零初始化的数据。如果将其作为输出(查询)参数省略,那么当被忽略的边数据全部为零初始化时,API 会接受这种做法;如果该调用会丢失信息,则返回cudaErrorLossyQuery。
某些流捕获 API 也支持边数据:cudaStreamBeginCaptureToGraph()、cudaStreamGetCaptureInfo()和cudaStreamUpdateCaptureDependencies()。在这些情况下,下游节点尚不存在。数据与一条悬空边(半边)关联,该边将连接到今后捕获的节点,或者在流捕获终止时被丢弃。请注意,某些边类型不会等待上游节点完全完成。在判断流捕获是否已完全重新汇入原始流时,这些边会被忽略,并且不能在捕获结束时被丢弃。请参阅流捕获。
没有任何节点类型定义额外的输入端口,只有核函数节点定义额外的输出端口。有一种非默认依赖类型cudaGraphDependencyTypeProgrammatic,用于在两个核函数节点之间启用程序化依赖启动。
4.2.2. 构建和运行图
使用图提交工作分为三个不同的阶段:定义、实例化和执行。
在定义或创建阶段,程序会创建对图中操作以及它们之间依赖关系的描述。
实例化会获取图模板的快照,对其进行验证,并完成大量工作的设置和初始化,目的是尽可能减少启动时需要执行的操作。由此得到的实例称为可执行图。
与任何其他 CUDA 工作类似,可执行图可以启动到流中。它可以启动任意多次,而无需重复实例化。
4.2.2.1. 图的创建
可以通过两种机制创建图:使用显式图 API,以及通过流捕获。
4.2.2.1.1. 图 API
以下示例展示了如何创建下图(省略了声明及其他样板代码)。请注意,示例使用cudaGraphCreate()创建图,使用cudaGraphAddNode()添加核函数节点及其依赖项。CUDA Runtime API 文档列出了可用于添加节点和依赖项的所有函数。
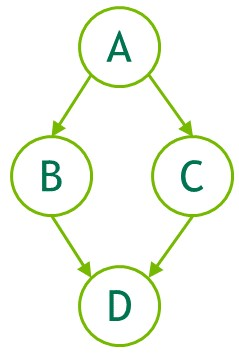
图 25 使用图 API 创建图的示例
// Create the graph - it starts out empty
cudaGraphCreate(&graph, 0);

// Create the nodes and their dependencies
cudaGraphNode_t nodes[4];
cudaGraphNodeParams kParams = { cudaGraphNodeTypeKernel };
kParams.kernel.func         = (void *)kernelName;
kParams.kernel.gridDim.x    = kParams.kernel.gridDim.y  = kParams.kernel.gridDim.z  = 1;
kParams.kernel.blockDim.x   = kParams.kernel.blockDim.y = kParams.kernel.blockDim.z = 1;

cudaGraphAddNode(&nodes[0], graph, NULL, NULL, 0, &kParams);
cudaGraphAddNode(&nodes[1], graph, &nodes[0], NULL, 1, &kParams);
cudaGraphAddNode(&nodes[2], graph, &nodes[0], NULL, 1, &kParams);
cudaGraphAddNode(&nodes[3], graph, &nodes[1], NULL, 2, &kParams);
上面的示例展示了四个核函数节点及它们之间的依赖关系,以说明如何创建一个非常简单的图。典型的应用程序还会包含为内存操作(如 memcpy 和 memset)添加的节点。有关用于添加节点的所有图 API 函数的完整参考信息,请参阅CUDA Runtime API 文档。
注意
CUDA 图 API 最初使用单独的 API 函数来添加每种不同类型的节点。例如,cudaGraphAddKernelNode()或cudaGraphAddMemcpyNode()。这些 API 已被单一的多态 APIcudaGraphAddNode()取代,后者使用节点参数的.type字段来确定所添加节点的类型。非多态 API 将在未来弃用。使用 CUDA 图 API 向图中添加节点时,推荐使用cudaGraphAddNode()。
4.2.2.1.2. 流捕获
流捕获提供了一种利用现有的基于流的 API 创建图的机制。对于一段将工作启动到流中的代码(包括现有代码),可以在其前后分别调用cudaStreamBeginCapture()和cudaStreamEndCapture()。如下所示。
cudaGraph_t graph;

cudaStreamBeginCapture(stream);

kernel_A<<< ..., stream >>>(...);
kernel_B<<< ..., stream >>>(...);
libraryCall(stream);
kernel_C<<< ..., stream >>>(...);

cudaStreamEndCapture(stream, &graph);
调用cudaStreamBeginCapture()会使流进入捕获模式。当流正在被捕获时,启动到该流中的工作不会入队执行,而是会追加到一个正在逐步构建的内部图中。随后,调用cudaStreamEndCapture()会返回此图,同时结束该流的捕获模式。正在通过流捕获构建的图称为捕获图。
除cudaStreamLegacy(“NULL 流”)外,任何 CUDA 流都可以使用流捕获。请注意,它可以用于cudaStreamPerThread。如果程序正在使用传统流,则可能可以将流 0 重新定义为每线程流,而不改变任何功能。请参阅阻塞流、非阻塞流与默认流。
可以使用cudaStreamIsCapturing()查询流是否正在被捕获。
可以使用cudaStreamBeginCaptureToGraph()将工作捕获到现有图中。此时,工作不是捕获到内部图中,而是捕获到用户提供的图中。
4.2.2.1.2.1. 跨流依赖关系与事件
流捕获可以处理使用cudaEventRecord()和cudaStreamWaitEvent()表达的跨流依赖关系,前提是所等待的事件记录在同一个捕获图中。
在处于捕获模式的流中记录事件时,会产生一个已捕获事件。已捕获事件代表捕获图中的一组节点。
当流等待一个已捕获事件时,如果该流尚未处于捕获模式,就会使其进入捕获模式,并且流中的下一个工作项将额外依赖于已捕获事件中的节点。此时,这两个流就会被捕获到同一个捕获图中。
当流捕获中存在跨流依赖关系时,仍必须在调用cudaStreamBeginCapture()的同一个流中调用cudaStreamEndCapture();该流称为起始流。由于基于事件的依赖关系而被捕获到同一捕获图中的其他所有流,也必须重新汇合到起始流。下文对此进行了说明。调用cudaStreamEndCapture()后,被捕获到同一捕获图中的所有流都会退出捕获模式。未能重新汇合到起始流将导致整个捕获操作失败。
// stream1 is the origin stream
cudaStreamBeginCapture(stream1);

kernel_A<<< ..., stream1 >>>(...);

// Fork into stream2
cudaEventRecord(event1, stream1);
cudaStreamWaitEvent(stream2, event1);

kernel_B<<< ..., stream1 >>>(...);
kernel_C<<< ..., stream2 >>>(...);

// Join stream2 back to origin stream (stream1)
cudaEventRecord(event2, stream2);
cudaStreamWaitEvent(stream1, event2);

kernel_D<<< ..., stream1 >>>(...);

// End capture in the origin stream
cudaStreamEndCapture(stream1, &graph);

// stream1 and stream2 no longer in capture mode
上述代码返回的图如图 25所示。
注意
当流退出捕获模式时,即使中间的工作项已被移除,流中的下一个未捕获工作项(如果有)仍然会依赖于之前最近的未捕获工作项。
4.2.2.1.2.2. 禁止的操作与未处理的操作
对正在被捕获的流或已捕获事件执行同步或查询其执行状态是无效的,因为它们不代表已调度执行的工作项。对于涵盖正在进行的流捕获的更大范围句柄,查询其执行状态或对其执行同步同样无效,例如,当任意关联流处于捕获模式时的设备句柄或上下文句柄。
当同一上下文中的任意流正在被捕获,且该流并非使用cudaStreamNonBlocking创建时,任何尝试使用传统流的操作都是无效的。这是因为传统流句柄始终涵盖这些其他流;向传统流中入队工作会创建对正在被捕获的流的依赖关系,而查询传统流或对其执行同步,则会查询正在被捕获的流或对其执行同步。
因此,在这种情况下调用同步 API 也无效。同步 API 的一个例子是cudaMemcpy(),它会将工作入队到传统流中,并在返回之前对该流执行同步。
注意
一般而言,当某个依赖关系会将已捕获的工作与未被捕获而是入队执行的工作连接起来时,CUDA 更倾向于返回错误,而不是忽略该依赖关系。使流进入或退出捕获模式是一个例外;这会切断紧邻模式转换前后添加到流中的工作项之间的依赖关系。
如果一个正在被捕获的流与已捕获事件关联于不同的捕获图,那么通过在该流中等待该事件来合并两个独立的捕获图是无效的。在未指定cudaEventWaitExternal标志的情况下,在正在被捕获的流中等待未捕获事件也是无效的。
少数将异步操作入队到流中的 API 目前尚不受图支持,如果使用正在被捕获的流调用这些 API,就会返回错误,例如cudaStreamAttachMemAsync()。
4.2.2.1.2.3. 失效
在流捕获期间尝试执行无效操作时,任何关联的捕获图都会失效。捕获图失效后,在使用cudaStreamEndCapture()结束流捕获之前,进一步使用与该图关联的任何正在被捕获的流或已捕获事件都是无效的,并且会返回错误。此调用会使关联的流退出捕获模式,但也会返回一个错误值和一个 NULL 图。
4.2.2.1.2.4. 捕获内省
可以使用cudaStreamGetCaptureInfo()检查正在进行的流捕获操作。这使用户能够获取捕获的状态、捕获的唯一(在每个进程内唯一)ID、底层图对象,以及该流中下一个要捕获的节点的依赖项/边数据。可以利用这些依赖关系信息,获取流中最后捕获的一个或多个节点的句柄。
4.2.2.1.3. 综合运用
图 25中的示例是一个简化示例,旨在从概念上展示一个小型图。在使用 CUDA 图的应用程序中,无论使用图 API 还是流捕获,情况都会更加复杂。以下代码片段并列比较了使用图 API 和流捕获来创建 CUDA 图,以执行一个简单的两阶段归约算法。
图 26展示了这个 CUDA 图。它是通过对以下代码应用cudaGraphDebugDotPrint函数生成的,经过少量调整以提高可读性后,再使用Graphviz渲染而成。
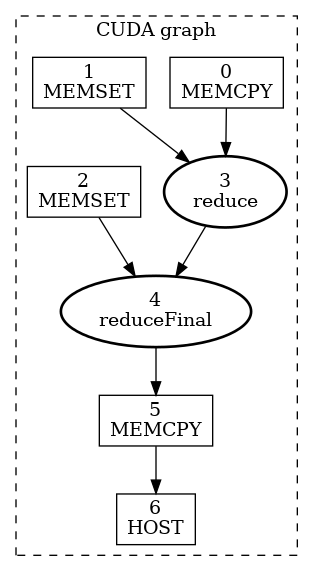
图 26 使用两阶段归约核函数的 CUDA 图示例
图内文字中文对照
CUDA graph- CUDA 图
MEMSET- 内存设置
MEMCPY- 内存复制
HOST- 主机
void cudaGraphsManual(float  *inputVec_h,
                      float  *inputVec_d,
                      double *outputVec_d,
                      double *result_d,
                      size_t  inputSize,
                      size_t  numOfBlocks)
{
    cudaStream_t                 streamForGraph;
    cudaGraph_t                  graph;
    std::vector<cudaGraphNode_t> nodeDependencies;
    cudaGraphNode_t              memcpyNode, kernelNode;
    double                       result_h = 0.0;

    cudaStreamCreate(&streamForGraph);

    // cudaGraphAddNode is the unified node-creation API: one call for every node type,
    // driven by a cudaGraphNodeParams struct (a .type tag + a union of per-type params).
    // It replaces the previously used cudaGraphAddMemcpyNode/cudaGraphAddKernelNode calls. The struct
    // has reserved fields that must be zero, so it is re-zeroed with "= {}" before each node below.
    cudaGraphNodeParams nodeParams   = {};
    cudaMemcpy3DParms   memcpyParams = {0};

    memcpyParams.srcArray = NULL;
    memcpyParams.srcPos   = make_cudaPos(0, 0, 0);
    memcpyParams.srcPtr   = make_cudaPitchedPtr(inputVec_h, sizeof(float) * inputSize, inputSize, 1);
    memcpyParams.dstArray = NULL;
    memcpyParams.dstPos   = make_cudaPos(0, 0, 0);
    memcpyParams.dstPtr   = make_cudaPitchedPtr(inputVec_d, sizeof(float) * inputSize, inputSize, 1);
    memcpyParams.extent   = make_cudaExtent(sizeof(float) * inputSize, 1, 1);
    memcpyParams.kind     = cudaMemcpyHostToDevice;

    // Create an empty graph; nodes and edges will be added below.
    cudaGraphCreate(&graph, 0);

    // Node 1: H2D memcpy — no dependencies (NULL, 0), so it can start immediately.
    // For a memcpy node the cudaMemcpy3DParms goes into nodeParams.memcpy.copyParams
    // (the .memcpy union member is a wrapper struct, so the copy descriptor nests one level deeper).
    nodeParams                   = {};
    nodeParams.type              = cudaGraphNodeTypeMemcpy;
    nodeParams.memcpy.copyParams = memcpyParams;
    cudaGraphAddNode(&memcpyNode, graph, NULL, /*dependencyData=*/NULL, 0, &nodeParams);

    // Make the next node wait for this memcpy to finish before starting.
    nodeDependencies.push_back(memcpyNode);

    void *kernelArgs[4] = {(void *)&inputVec_d, (void *)&outputVec_d, &inputSize, &numOfBlocks};

    // Node 2: first reduction kernel — depends on the H2D memcpy completing.
    // Kernel params are set directly on the .kernel union member.
    nodeParams                       = {};
    nodeParams.type                  = cudaGraphNodeTypeKernel;
    nodeParams.kernel.func           = (void *)reduce;
    nodeParams.kernel.gridDim        = dim3(numOfBlocks, 1, 1);
    nodeParams.kernel.blockDim       = dim3(THREADS_PER_BLOCK, 1, 1);
    nodeParams.kernel.sharedMemBytes = 0;
    nodeParams.kernel.kernelParams   = (void **)kernelArgs;
    nodeParams.kernel.extra          = NULL;
    cudaGraphAddNode(
        &kernelNode, graph, nodeDependencies.data(), /*dependencyData=*/NULL, nodeDependencies.size(), &nodeParams);

    // Move dependency forward: the next node waits for this kernel.
    nodeDependencies.clear();
    nodeDependencies.push_back(kernelNode);

    void *kernelArgs2[3] = {(void *)&outputVec_d, (void *)&result_d, &numOfBlocks};

    // Node 3: final reduction kernel — depends on Node 2.
    nodeParams                       = {};
    nodeParams.type                  = cudaGraphNodeTypeKernel;
    nodeParams.kernel.func           = (void *)reduceFinal;
    nodeParams.kernel.gridDim        = dim3(1, 1, 1);
    nodeParams.kernel.blockDim       = dim3(THREADS_PER_BLOCK, 1, 1);
    nodeParams.kernel.sharedMemBytes = 0;
    nodeParams.kernel.kernelParams   = kernelArgs2;
    nodeParams.kernel.extra          = NULL;
    cudaGraphAddNode(
        &kernelNode, graph, nodeDependencies.data(), /*dependencyData=*/NULL, nodeDependencies.size(), &nodeParams);
    nodeDependencies.clear();
    nodeDependencies.push_back(kernelNode);

    memset(&memcpyParams, 0, sizeof(memcpyParams));

    memcpyParams.srcArray = NULL;
    memcpyParams.srcPos   = make_cudaPos(0, 0, 0);
    memcpyParams.srcPtr   = make_cudaPitchedPtr(result_d, sizeof(double), 1, 1);
    memcpyParams.dstArray = NULL;
    memcpyParams.dstPos   = make_cudaPos(0, 0, 0);
    memcpyParams.dstPtr   = make_cudaPitchedPtr(&result_h, sizeof(double), 1, 1);
    memcpyParams.extent   = make_cudaExtent(sizeof(double), 1, 1);
    memcpyParams.kind     = cudaMemcpyDeviceToHost;

    // Node 4: D2H memcpy — copies the scalar result back to the host.
    // Again the copy descriptor nests in nodeParams.memcpy.copyParams.
    nodeParams                   = {};
    nodeParams.type              = cudaGraphNodeTypeMemcpy;
    nodeParams.memcpy.copyParams = memcpyParams;
    cudaGraphAddNode(&memcpyNode, graph, nodeDependencies.data(), /*dependencyData=*/NULL, nodeDependencies.size(), &nodeParams);
    nodeDependencies.clear();
    nodeDependencies.push_back(memcpyNode);

    cudaGraphNode_t hostNode;
    callBackData_t  hostFnData;
    hostFnData.data    = &result_h;
    hostFnData.fn_name = "cudaGraphsManual";

    // Node 5: host callback — runs on the CPU after the D2H copy completes.
    // The .host member is cudaHostNodeParamsV2 (fn + userData, plus a syncMode field
    // left at 0 by the zero-init above).
    nodeParams               = {};
    nodeParams.type          = cudaGraphNodeTypeHost;
    nodeParams.host.fn       = myHostNodeCallback;
    nodeParams.host.userData = &hostFnData;
    cudaGraphAddNode(&hostNode, graph, nodeDependencies.data(), /*dependencyData=*/NULL, nodeDependencies.size(), &nodeParams);

    size_t numNodes = 0;
    cudaGraphGetNodes(graph, NULL, &numNodes);
    printf("Graph node count: %zu\n", numNodes);

    // Instantiate: compile the graph into an executable form (one-time cost).
    // This is where CUDA optimizes the schedule; repeated launches reuse this.
    cudaGraphExec_t graphExec;
    cudaGraphInstantiate(&graphExec, graph, NULL, NULL, 0);

    // Demonstrates cudaGraphClone — in practice, cloning is useful when multiple CPU
    // threads need to launch the same graph concurrently, each with its own independent graphExec.
    cudaGraph_t     clonedGraph;
    cudaGraphExec_t clonedGraphExec;
    cudaGraphClone(&clonedGraph, graph);
    cudaGraphInstantiate(&clonedGraphExec, clonedGraph, NULL, NULL, 0);

    // Refill the host input before each launch so the graph's H2D copy processes
    // new data every time — one instantiated graph reused for different data.
    // The per-iteration sync ensures that copy finishes before we overwrite the buffer.
    for (int i = 0; i < GRAPH_LAUNCH_ITERATIONS; i++) {
        init_input(inputVec_h, inputSize);
        cudaGraphLaunch(graphExec, streamForGraph);
        cudaStreamSynchronize(streamForGraph);
    }

    printf("\nCloned graph:\n");
    for (int i = 0; i < GRAPH_LAUNCH_ITERATIONS; i++) {
        init_input(inputVec_h, inputSize);
        cudaGraphLaunch(clonedGraphExec, streamForGraph);
        cudaStreamSynchronize(streamForGraph);
    }

    cudaGraphExecDestroy(graphExec);
    cudaGraphExecDestroy(clonedGraphExec);
    cudaGraphDestroy(graph);
    cudaGraphDestroy(clonedGraph);
    cudaStreamDestroy(streamForGraph);
}
void cudaGraphsUsingStreamCapture(float  *inputVec_h,
                                  float  *inputVec_d,
                                  double *outputVec_d,
                                  double *result_d,
                                  size_t  inputSize,
                                  size_t  numOfBlocks)
{
    cudaStream_t stream1, streamForGraph;
    cudaGraph_t  graph;
    double       result_h = 0.0;

    cudaStreamCreate(&stream1);
    cudaStreamCreate(&streamForGraph);

    // Begin capture: operations issued to stream1 are recorded, not executed.
    cudaStreamBeginCapture(stream1, cudaStreamCaptureModeGlobal);

    cudaMemcpyAsync(inputVec_d, inputVec_h, sizeof(float) * inputSize, cudaMemcpyDefault, stream1);

    reduce<<<numOfBlocks, THREADS_PER_BLOCK, 0, stream1>>>(inputVec_d, outputVec_d, inputSize, numOfBlocks);

    reduceFinal<<<1, THREADS_PER_BLOCK, 0, stream1>>>(outputVec_d, result_d, numOfBlocks);
    cudaMemcpyAsync(&result_h, result_d, sizeof(double), cudaMemcpyDefault, stream1);

    callBackData_t hostFnData = {0};
    hostFnData.data           = &result_h;
    hostFnData.fn_name        = "cudaGraphsUsingStreamCapture";
    cudaLaunchHostFunc(stream1, myHostNodeCallback, &hostFnData);

    // End capture: the runtime builds a graph from everything recorded above.
    // The resulting graph is structurally identical to the one built manually.
    cudaStreamEndCapture(stream1, &graph);

    size_t numNodes = 0;
    cudaGraphGetNodes(graph, NULL, &numNodes);
    printf("Graph node count: %zu\n", numNodes);

    // Instantiate the captured graph into an executable form.
    cudaGraphExec_t graphExec;
    cudaGraphInstantiate(&graphExec, graph, NULL, NULL, 0);

    // Demonstrates cudaGraphClone — in practice, cloning is useful when multiple CPU
    // threads need to launch the same graph concurrently, each with its own independent graphExec.
    cudaGraph_t     clonedGraph;
    cudaGraphExec_t clonedGraphExec;
    cudaGraphClone(&clonedGraph, graph);
    cudaGraphInstantiate(&clonedGraphExec, clonedGraph, NULL, NULL, 0);

    // Refill the host input before each launch so the graph's H2D copy processes
    // new data every time — one instantiated graph reused for different data.
    // The per-iteration sync ensures that copy finishes before we overwrite the buffer.
    for (int i = 0; i < GRAPH_LAUNCH_ITERATIONS; i++) {
        init_input(inputVec_h, inputSize);
        cudaGraphLaunch(graphExec, streamForGraph);
        cudaStreamSynchronize(streamForGraph);
    }

    printf("\nCloned graph:\n");
    for (int i = 0; i < GRAPH_LAUNCH_ITERATIONS; i++) {
        init_input(inputVec_h, inputSize);
        cudaGraphLaunch(clonedGraphExec, streamForGraph);
        cudaStreamSynchronize(streamForGraph);
    }

    cudaGraphExecDestroy(graphExec);
    cudaGraphExecDestroy(clonedGraphExec);
    cudaGraphDestroy(graph);
    cudaGraphDestroy(clonedGraph);
    cudaStreamDestroy(stream1);
    cudaStreamDestroy(streamForGraph);
}
4.2.2.2. 图的实例化
无论是使用图 API 还是流捕获,创建图后,都必须通过实例化该图来创建可执行图,然后才能启动它。假设已成功创建cudaGraph_t graph,以下代码将实例化该图并创建可执行图cudaGraphExec_t graphExec:
cudaGraphExec_t graphExec;
cudaGraphInstantiate(&graphExec, graph, 0);
4.2.2.3. 图的执行
创建图并将其实例化为可执行图之后,就可以启动它。假设已成功创建cudaGraphExec_t graphExec,以下代码片段会将该图启动到指定的流中:
cudaGraphLaunch(graphExec, stream);
综合以上内容,并使用第 4.2.2.1.2 节中的流捕获示例,以下代码片段将创建一个图,对其实例化,然后启动它:
cudaGraph_t graph;

cudaStreamBeginCapture(stream);

kernel_A<<< ..., stream >>>(...);
kernel_B<<< ..., stream >>>(...);
libraryCall(stream);
kernel_C<<< ..., stream >>>(...);

cudaStreamEndCapture(stream, &graph);

cudaGraphExec_t graphExec;
cudaGraphInstantiate(&graphExec, graph, 0);
cudaGraphLaunch(graphExec, stream);
4.2.3. 更新已实例化的图
当工作流程发生变化时,图就会过时,必须加以修改。对图结构的重大更改(例如拓扑或节点类型的更改)需要重新实例化,因为必须重新应用与拓扑相关的优化。然而,通常只有节点参数(例如核函数参数和内存地址)发生变化,而图拓扑保持不变。针对这种情况,CUDA 提供了一种轻量级的“图更新”机制,允许就地修改某些节点参数,而无需重新构建整个图,这比重新实例化高效得多。
更新会在下一次启动图时生效,因此不会影响此前的图启动,即使更新时这些图启动仍在运行。可以反复更新并重新启动图,因此可以在一个流中将多次更新/启动排队。
CUDA 提供了两种更新已实例化图参数的机制:整图更新和单个节点更新。整图更新允许用户提供一个拓扑相同的cudaGraph_t对象,其节点包含更新后的参数。单个节点更新允许用户显式更新各个节点的参数。当需要更新大量节点,或者调用方不知道图拓扑时(即该图是对库调用进行流捕获的结果),使用更新后的cudaGraph_t更为方便。当更改数量较少,并且用户持有需要更新的节点的句柄时,首选单个节点更新。单个节点更新会跳过对未更改节点的拓扑检查和比较,因此在许多情况下可以更加高效。
CUDA 还提供了一种机制,可以在不影响节点当前参数的情况下启用和禁用单个节点。
以下各节将更详细地说明每种方法。
4.2.3.1. 整图更新
cudaGraphExecUpdate()允许使用一个拓扑相同的图(“更新图”)中的参数来更新已实例化的图(“原始图”)。更新图的拓扑必须与用于实例化cudaGraphExec_t的原始图完全相同。此外,指定依赖项的顺序也必须匹配。最后,CUDA 需要以一致的顺序排列汇节点(没有依赖项的节点)。CUDA 依赖于特定 API 调用的顺序来实现一致的汇节点排序。
更明确地说,遵循以下规则会使cudaGraphExecUpdate()以确定性的方式将原始图与更新图中的节点配对:
对于任何正在捕获的流,对该流进行操作的 API 调用都必须以相同的顺序进行,包括事件等待,以及其他不直接对应于节点创建的 API 调用。
直接操纵给定图节点入边的 API 调用(包括被捕获的流 API、节点添加 API 和边添加/移除 API)必须以相同的顺序进行。此外,当以数组形式向这些 API 指定依赖项时,在这些数组中指定依赖项的顺序也必须匹配。
汇节点的排列顺序必须一致。汇节点是指在调用
cudaGraphExecUpdate()时的最终图中,没有依赖它的节点/出边的节点。以下操作(如果存在)会影响汇节点的排序,并且必须(作为一个组合后的集合)以相同的顺序进行:产生汇节点的节点添加 API。
导致某个节点变为汇节点的边移除操作。
cudaStreamUpdateCaptureDependencies(),如果它从正在捕获的流的依赖项集合中移除了一个汇节点。cudaStreamEndCapture().
以下示例展示了如何使用该 API 更新已实例化的图:
cudaGraphExec_t graphExec = NULL;

for (int i = 0; i < 10; i++) {
    cudaGraph_t graph;
    cudaGraphExecUpdateResult updateResult;
    cudaGraphNode_t errorNode;

    // In this example we use stream capture to create the graph.
    // You can also use the Graph API to produce a graph.
    cudaStreamBeginCapture(stream, cudaStreamCaptureModeGlobal);

    // Call a user-defined, stream based workload, for example
    do_cuda_work(stream);

    cudaStreamEndCapture(stream, &graph);

    // If we've already instantiated the graph, try to update it directly
    // and avoid the instantiation overhead
    if (graphExec != NULL) {
        // If the graph fails to update, errorNode will be set to the
        // node causing the failure and updateResult will be set to a
        // reason code.
        cudaGraphExecUpdate(graphExec, graph, &errorNode, &updateResult);
    }

    // Instantiate during the first iteration or whenever the update
    // fails for any reason
    if (graphExec == NULL || updateResult != cudaGraphExecUpdateSuccess) {

        // If a previous update failed, destroy the cudaGraphExec_t
        // before re-instantiating it
        if (graphExec != NULL) {
            cudaGraphExecDestroy(graphExec);
        }
        // Instantiate graphExec from graph. The error node and
        // error message parameters are unused here.
        cudaGraphInstantiate(&graphExec, graph, 0);
    }

    cudaGraphDestroy(graph);
    cudaGraphLaunch(graphExec, stream);
    cudaStreamSynchronize(stream);
}
典型的工作流程是使用流捕获或图 API 创建初始cudaGraph_t。然后照常对cudaGraph_t进行实例化并启动。在初次启动之后,使用与初始图相同的方法创建新的cudaGraph_t,并调用cudaGraphExecUpdate()。如果图更新成功(由上述示例中的updateResult参数指示),则启动更新后的cudaGraphExec_t。如果更新因任何原因失败,则调用cudaGraphExecDestroy()和cudaGraphInstantiate(),以销毁原始cudaGraphExec_t并实例化一个新的对象。
也可以直接更新cudaGraph_t节点(即使用cudaGraphKernelNodeSetParams()),随后再更新cudaGraphExec_t,但是使用下一节介绍的显式节点更新 API 更加高效。
条件句柄的标志和默认值会作为图更新的一部分进行更新。
有关用法和当前限制的更多信息,请参阅图 API。
4.2.3.2. 单个节点更新
可以直接更新已实例化图的节点参数。这消除了实例化的开销,也消除了创建新cudaGraph_t的开销。如果需要更新的节点数量相对于图中的节点总数较少,则最好逐个更新节点。以下方法可用于更新cudaGraphExec_t节点:
API |
节点类型 |
|---|---|
|
核函数节点 |
|
内存复制节点 |
|
内存设置节点 |
|
主机节点 |
|
子图节点 |
|
事件记录节点 |
|
事件等待节点 |
|
外部信号量发信号节点 |
|
外部信号量等待节点 |
有关用法和当前限制的更多信息,请参阅图 API。
4.2.3.3. 单个节点启用
可以使用cudaGraphNodeSetEnabled() API 启用或禁用已实例化图中的核函数节点、memset 节点和 memcpy 节点。这允许创建一个包含所需功能超集的图,并针对每次启动对其进行定制。可以使用cudaGraphNodeGetEnabled() API 查询节点的启用状态。
已禁用的节点在重新启用之前,在功能上等同于空节点。启用或禁用节点不会影响节点参数。单个节点更新或通过cudaGraphExecUpdate()进行的整个图更新都不会影响启用状态。在节点禁用期间进行的参数更新,将在该节点重新启用时生效。
有关用法和当前限制的更多信息,请参阅图 API。
4.2.3.4. 图更新限制
核函数节点:
函数所属的上下文不能更改。
如果节点的函数原本未使用 CUDA 动态并行,则不能将该节点更新为使用 CUDA 动态并行的函数。
cudaMemset和cudaMemcpy节点:
操作数所分配到或映射到的 CUDA 设备不能更改。
源内存和目标内存必须分别从与原始源内存和目标内存相同的上下文中分配。
只能更改一维
cudaMemset/cudaMemcpy节点。
memcpy 节点的额外限制:
不支持更改源内存或目标内存的类型(即
cudaPitchedPtr、cudaArray_t等),也不支持更改传输类型(即cudaMemcpyKind)。
外部信号量等待节点和记录节点:
不支持更改信号量的数量。
条件节点:
各图之间句柄的创建和指派顺序必须匹配。
不支持更改节点参数(即条件节点中的图数量、节点上下文等)。
更改条件主体图内节点的参数须遵守上述规则。
内存节点:
如果
cudaGraph_t当前已实例化为另一个cudaGraphExec_t,则无法使用cudaGraph_t更新cudaGraphExec_t。
对主机节点、事件记录节点或事件等待节点的更新没有限制。
4.2.4. 条件图节点
条件节点允许对其内部包含的图进行条件执行和循环执行。这使得动态和迭代工作流能够完全在图内表示,并让主机 CPU 可以腾出资源并行执行其他工作。
当条件节点的依赖关系得到满足时,设备会对条件值进行求值。条件节点可以是以下类型之一:
条件IF 节点在节点执行时,如果条件值非零,则执行其主体图一次。还可以提供可选的第二个主体图,如果节点执行时条件值为零,则执行该主体图一次。
条件WHILE 节点在节点执行时,如果条件值非零,则执行其主体图,并将持续执行其主体图,直到条件值为零。
条件SWITCH 节点在条件值等于 n 时,执行从零开始编号的第 n 个主体图一次。如果条件值不对应任何主体图,则不会启动任何主体图。
条件值通过条件句柄访问,该句柄必须先于节点创建。设备代码可以使用cudaGraphSetConditional()设置条件值。还可以在创建句柄时指定一个默认值,该默认值会在每次图启动时应用。
创建条件节点时,会创建一个空图,并将句柄返回给用户,以便填充该图。可以使用图 API或cudaStreamBeginCaptureToGraph()填充此条件主体图。
条件节点可以嵌套。
4.2.4.1. 条件句柄
条件值由cudaGraphConditionalHandle表示,并由cudaGraphConditionalHandleCreate()创建。
句柄必须与单个条件节点关联。句柄无法销毁,因此无需跟踪它们。
如果在创建句柄时指定cudaGraphCondAssignDefault,则条件值会在每次图执行开始时初始化为指定的默认值。如果未提供此标志,则条件值在每次图执行开始时都是未定义的,代码不应假定条件值会在多次执行之间保留。
与句柄关联的默认值和标志将在整个图更新期间更新。
4.2.4.2. 条件节点主体图要求
一般要求:
图的所有节点必须驻留在单个设备上。
图只能包含核函数节点、空节点、memcpy 节点、memset 节点、子图节点和条件节点。
核函数节点:
不允许图中的核函数使用 CUDA 动态并行或设备图启动。
只要未使用 MPS,就允许协作式启动。
Memcpy/Memset 节点:
仅允许涉及设备内存和/或映射到设备的页锁定主机内存的复制/memset 操作。
不允许涉及 CUDA 数组的复制/memset 操作。
在实例化时,当前设备必须能够访问这两个操作数。注意,复制操作将从图所驻留的设备执行,即使其目标是另一个设备上的内存也是如此。
4.2.4.3. 条件 IF 节点
如果 IF 节点执行时条件非零,则其主体图将执行一次。下图描绘了一个包含 3 个节点的图,其中中间节点 B 是条件节点:
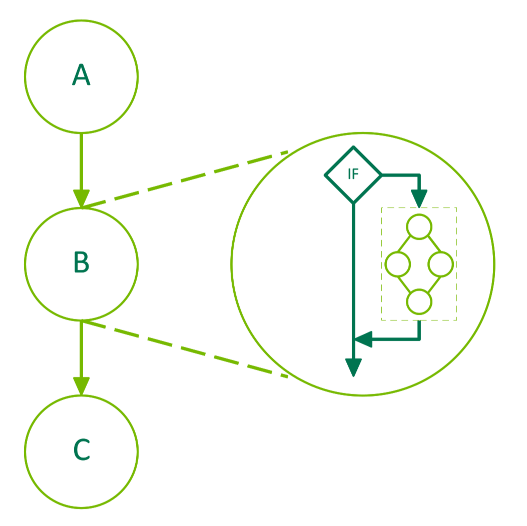
图 27 条件 IF 节点
图内文字中文对照
IF- 如果
以下代码展示了如何创建包含 IF 条件节点的图。条件的默认值使用上游核函数设置。条件主体使用图 API填充。
__global__ void setHandle(cudaGraphConditionalHandle handle, int value)
{
...
// Set the condition value to the value passed to the kernel
cudaGraphSetConditional(handle, value);
...
}
void graphSetup() {
cudaGraph_t graph;
cudaGraphExec_t graphExec;
cudaGraphNode_t node;
void *kernelArgs[2];
int value = 1;
// Create the graph
cudaGraphCreate(&graph, 0);
// Create the conditional handle; because no default value is provided, the condition value is undefined at the start of each graph execution
cudaGraphConditionalHandle handle;
cudaGraphConditionalHandleCreate(&handle, graph);
// Use a kernel upstream of the conditional to set the handle value
cudaGraphNodeParams params = { cudaGraphNodeTypeKernel };
params.kernel.func = (void *)setHandle;
params.kernel.gridDim.x = params.kernel.gridDim.y = params.kernel.gridDim.z = 1;
params.kernel.blockDim.x = params.kernel.blockDim.y = params.kernel.blockDim.z = 1;
params.kernel.kernelParams = kernelArgs;
kernelArgs[0] = &handle;
kernelArgs[1] = &value;
cudaGraphAddNode(&node, graph, nullptr, nullptr, 0, ¶ms);
// Create and add the conditional node
cudaGraphNodeParams cParams = { cudaGraphNodeTypeConditional };
cParams.conditional.handle = handle;
cParams.conditional.type = cudaGraphCondTypeIf;
cParams.conditional.size = 1; // There is only an "if" body graph
cudaGraphAddNode(&node, graph, &node, nullptr, 1, &cParams);
// Get the body graph of the conditional node
cudaGraph_t bodyGraph = cParams.conditional.phGraph_out[0];
// Populate the body graph of the IF conditional node
...
cudaGraphAddNode(&node, bodyGraph, nullptr, nullptr, 0, ¶ms);
// Instantiate and launch the graph
cudaGraphInstantiate(&graphExec, graph, 0);
cudaGraphLaunch(graphExec, 0);
cudaDeviceSynchronize();
// Clean up
cudaGraphExecDestroy(graphExec);
cudaGraphDestroy(graph);
}
IF 节点还可以有一个可选的第二个主体图,如果节点执行时条件值为零,则该主体图执行一次。
void graphSetup() {
cudaGraph_t graph;
cudaGraphExec_t graphExec;
cudaGraphNode_t node;
void *kernelArgs[2];
int value = 1;
// Create the graph
cudaGraphCreate(&graph, 0);
// Create the conditional handle; because no default value is provided, the condition value is undefined at the start of each graph execution
cudaGraphConditionalHandle handle;
cudaGraphConditionalHandleCreate(&handle, graph);
// Use a kernel upstream of the conditional to set the handle value
cudaGraphNodeParams params = { cudaGraphNodeTypeKernel };
params.kernel.func = (void *)setHandle;
params.kernel.gridDim.x = params.kernel.gridDim.y = params.kernel.gridDim.z = 1;
params.kernel.blockDim.x = params.kernel.blockDim.y = params.kernel.blockDim.z = 1;
params.kernel.kernelParams = kernelArgs;
kernelArgs[0] = &handle;
kernelArgs[1] = &value;
cudaGraphAddNode(&node, graph, nullptr, nullptr, 0, ¶ms);
// Create and add the IF conditional node
cudaGraphNodeParams cParams = { cudaGraphNodeTypeConditional };
cParams.conditional.handle = handle;
cParams.conditional.type = cudaGraphCondTypeIf;
cParams.conditional.size = 2; // There is both an "if" and an "else" body graph
cudaGraphAddNode(&node, graph, &node, nullptr, 1, &cParams);
// Get the body graphs of the conditional node
cudaGraph_t ifBodyGraph = cParams.conditional.phGraph_out[0];
cudaGraph_t elseBodyGraph = cParams.conditional.phGraph_out[1];
// Populate the body graphs of the IF conditional node
...
cudaGraphAddNode(&node, ifBodyGraph, nullptr, nullptr, 0, ¶ms);
...
cudaGraphAddNode(&node, elseBodyGraph, nullptr, nullptr, 0, ¶ms);
// Instantiate and launch the graph
cudaGraphInstantiate(&graphExec, graph, 0);
cudaGraphLaunch(graphExec, 0);
cudaDeviceSynchronize();
// Clean up
cudaGraphExecDestroy(graphExec);
cudaGraphDestroy(graph);
}
4.2.4.4. 条件 WHILE 节点
只要条件非零,WHILE 节点的主体图就会执行。条件将在节点执行时以及主体图完成后求值。下图描绘了一个包含 3 个节点的图,其中中间节点 B 是条件节点:
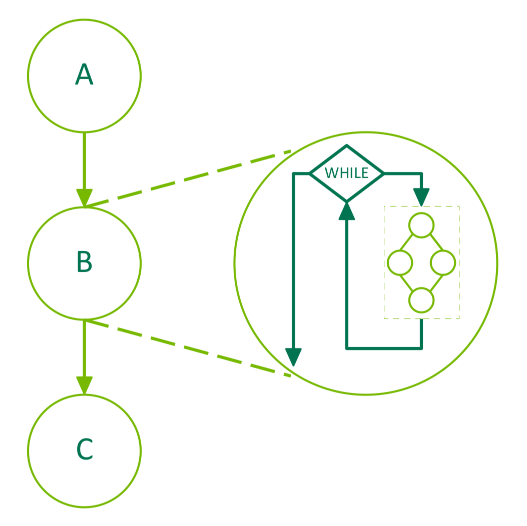
图 28 条件 WHILE 节点
图内文字中文对照
WHILE- 当条件成立时
以下代码展示了如何创建包含 WHILE 条件节点的图。创建句柄时使用cudaGraphCondAssignDefault,以避免需要上游核函数。条件主体使用图 API填充。
__global__ void loopKernel(cudaGraphConditionalHandle handle, char *dPtr)
{
// Decrement the value of dPtr and set the condition value to 0 once dPtr is 0
if (--(*dPtr) == 0) {
cudaGraphSetConditional(handle, 0);
}
}
void graphSetup() {
cudaGraph_t graph;
cudaGraphExec_t graphExec;
cudaGraphNode_t node;
void *kernelArgs[2];
// Allocate a byte of device memory to use as input
char *dPtr;
cudaMalloc((void **)&dPtr, 1);
// Create the graph
cudaGraphCreate(&graph, 0);
// Create the conditional handle with a default value of 1
cudaGraphConditionalHandle handle;
cudaGraphConditionalHandleCreate(&handle, graph, 1, cudaGraphCondAssignDefault);
// Create and add the WHILE conditional node
cudaGraphNodeParams cParams = { cudaGraphNodeTypeConditional };
cParams.conditional.handle = handle;
cParams.conditional.type = cudaGraphCondTypeWhile;
cParams.conditional.size = 1;
cudaGraphAddNode(&node, graph, nullptr, nullptr, 0, &cParams);
// Get the body graph of the conditional node
cudaGraph_t bodyGraph = cParams.conditional.phGraph_out[0];
// Populate the body graph of the conditional node
cudaGraphNodeParams params = { cudaGraphNodeTypeKernel };
params.kernel.func = (void *)loopKernel;
params.kernel.gridDim.x = params.kernel.gridDim.y = params.kernel.gridDim.z = 1;
params.kernel.blockDim.x = params.kernel.blockDim.y = params.kernel.blockDim.z = 1;
params.kernel.kernelParams = kernelArgs;
kernelArgs[0] = &handle;
kernelArgs[1] = &dPtr;
cudaGraphAddNode(&node, bodyGraph, nullptr, nullptr, 0, ¶ms);
// Initialize device memory, instantiate, and launch the graph
cudaMemset(dPtr, 10, 1); // Set dPtr to 10; the loop will run until dPtr is 0
cudaGraphInstantiate(&graphExec, graph, 0);
cudaGraphLaunch(graphExec, 0);
cudaDeviceSynchronize();
// Clean up
cudaGraphExecDestroy(graphExec);
cudaGraphDestroy(graph);
cudaFree(dPtr);
}
4.2.4.5. 条件 SWITCH 节点
如果 SWITCH 节点执行时条件等于 n,则其从零开始编号的第 n 个主体图将执行一次。下图描绘了一个包含 3 个节点的图,其中中间节点 B 是条件节点:
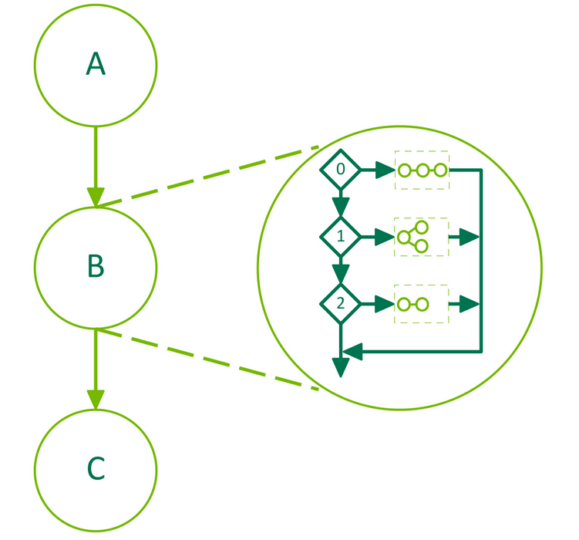
图 29 条件 SWITCH 节点
以下代码展示了如何创建包含 SWITCH 条件节点的图。条件值使用上游核函数设置。各条件主体使用图 API填充。
__global__ void setHandle(cudaGraphConditionalHandle handle, int value)
{
...
// Set the condition value to the value passed to the kernel
cudaGraphSetConditional(handle, value);
...
}
void graphSetup() {
cudaGraph_t graph;
cudaGraphExec_t graphExec;
cudaGraphNode_t node;
void *kernelArgs[2];
int value = 1;
// Create the graph
cudaGraphCreate(&graph, 0);
// Create the conditional handle; because no default value is provided, the condition value is undefined at the start of each graph execution
cudaGraphConditionalHandle handle;
cudaGraphConditionalHandleCreate(&handle, graph);
// Use a kernel upstream of the conditional to set the handle value
cudaGraphNodeParams params = { cudaGraphNodeTypeKernel };
params.kernel.func = (void *)setHandle;
params.kernel.gridDim.x = params.kernel.gridDim.y = params.kernel.gridDim.z = 1;
params.kernel.blockDim.x = params.kernel.blockDim.y = params.kernel.blockDim.z = 1;
params.kernel.kernelParams = kernelArgs;
kernelArgs[0] = &handle;
kernelArgs[1] = &value;
cudaGraphAddNode(&node, graph, nullptr, nullptr, 0, ¶ms);
// Create and add the conditional SWITCH node
cudaGraphNodeParams cParams = { cudaGraphNodeTypeConditional };
cParams.conditional.handle = handle;
cParams.conditional.type = cudaGraphCondTypeSwitch;
cParams.conditional.size = 5;
cudaGraphAddNode(&node, graph, &node, nullptr, 1, &cParams);
// Get the body graphs of the conditional node
cudaGraph_t *bodyGraphs = cParams.conditional.phGraph_out;
// Populate the body graphs of the SWITCH conditional node
...
cudaGraphAddNode(&node, bodyGraphs[0], nullptr, nullptr, 0, ¶ms);
...
cudaGraphAddNode(&node, bodyGraphs[4], NULL, 0, ¶ms);
// Instantiate and launch the graph
cudaGraphInstantiate(&graphExec, graph, 0);
cudaGraphLaunch(graphExec, 0);
cudaDeviceSynchronize();
// Clean up
cudaGraphExecDestroy(graphExec);
cudaGraphDestroy(graph);
}
4.2.5. 图内存节点
4.2.5.1. 简介
图内存节点允许图创建并拥有内存分配。图内存节点具有 GPU 有序的生命周期语义,该语义规定何时允许在设备上访问内存。这种 GPU 有序的生命周期语义支持由驱动程序管理的内存复用,并且与流有序分配 APIcudaMallocAsync和cudaFreeAsync的语义一致,这些 API 可以在创建图时被捕获。
图分配在图的整个生命周期内都具有固定地址,包括重复实例化和启动。这使得图中的其他操作可以直接引用该内存,而无需更新图,即使 CUDA 更改其后备物理内存也是如此。在一个图内,按图排序的生命周期不重叠的分配可以使用同一底层物理内存。
CUDA 可以为多个图中的分配复用同一物理内存,根据 GPU 有序的生命周期语义为虚拟地址映射设置别名。例如,当不同的图启动到同一个流中时,CUDA 可以为同一物理内存设置虚拟别名,以满足生命周期限于单个图的分配的需求。
4.2.5.2. API 基础
图内存节点是表示内存分配或释放操作的图节点。为简便起见,分配内存的节点称为分配节点。同样,释放内存的节点称为释放节点。由分配节点创建的分配称为图分配。CUDA 在节点创建时为图分配指派虚拟地址。尽管这些虚拟地址在分配节点的整个生命周期内固定不变,但分配的内容在释放操作之后不会持续保留,并且可能被引用其他分配的访问覆盖。
每次运行图时,图分配都被视为重新创建。图分配的生命周期不同于节点的生命周期,它始于 GPU 执行到分配图节点之时,并在发生以下任一情况时结束:
GPU 执行到释放图节点
GPU 执行到用于释放内存的
cudaFreeAsync()流调用调用
cudaFree()进行释放时立即结束
注意
销毁图虽然会结束分配节点的生命周期,但不会自动释放任何仍存活的图分配内存。随后必须在另一个图中释放该分配,或使用cudaFreeAsync()/cudaFree()释放。
与其他图结构一样,图内存节点在图内通过依赖边排序。程序必须保证访问图内存的操作:
在顺序上位于分配节点之后
在顺序上位于释放内存的操作之前
图分配的生命周期根据 GPU 执行(而不是 API 调用)开始,并且通常也根据 GPU 执行结束。GPU 排序是工作在 GPU 上运行的顺序,而不是工作入队或被描述的顺序。因此,图分配被视为“GPU 有序”。
4.2.5.2.1. 图节点 API
可以使用节点创建 APIcudaGraphAddNode显式创建图内存节点。添加cudaGraphNodeTypeMemAlloc节点时分配的地址,会通过所传入的cudaGraphNodeParams结构的alloc::dptr字段返回给用户。在执行分配的图内,所有使用图分配的操作都必须在顺序上位于分配节点之后。同样,任何释放节点都必须在顺序上位于图内对该分配的所有使用之后。释放节点使用cudaGraphAddNode以及cudaGraphNodeTypeMemFree节点类型创建。
下图是一个包含分配节点和释放节点的示例图。核函数节点a、b和c在顺序上位于分配节点之后、释放节点之前,因此这些核函数可以访问该分配。核函数节点e在顺序上未被置于分配节点之后,因此无法安全地访问该内存。核函数节点d在顺序上未被置于释放节点之前,因此无法安全地访问该内存。
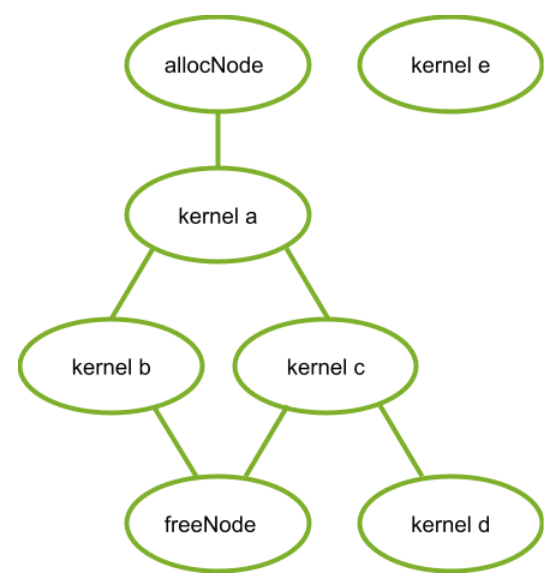
图 30 核函数节点
图内文字中文对照
kernel a- 核函数 a
kernel b- 核函数 b
kernel c- 核函数 c
kernel d- 核函数 d
kernel e- 核函数 e
以下代码片段构建了此图所示的图:
// Create the graph - it starts out empty
cudaGraphCreate(&graph, 0);
// parameters for a basic allocation
cudaGraphNodeParams params = { cudaGraphNodeTypeMemAlloc };
params.alloc.poolProps.allocType = cudaMemAllocationTypePinned;
params.alloc.poolProps.location.type = cudaMemLocationTypeDevice;
// specify device 0 as the resident device
params.alloc.poolProps.location.id = 0;
params.alloc.bytesize = size;
cudaGraphAddNode(&allocNode, graph, NULL, NULL, 0, ¶ms);
// create a kernel node that uses the graph allocation
cudaGraphNodeParams nodeParams = { cudaGraphNodeTypeKernel };
nodeParams.kernel.kernelParams[0] = params.alloc.dptr;
// ...set other kernel node parameters...
// add the kernel node to the graph
cudaGraphAddNode(&a, graph, &allocNode, NULL, 1, &nodeParams);
cudaGraphAddNode(&b, graph, &a, NULL, 1, &nodeParams);
cudaGraphAddNode(&c, graph, &a, NULL, 1, &nodeParams);
cudaGraphNode_t dependencies[2];
// kernel nodes b and c are using the graph allocation, so the freeing node must depend on them. Since the dependency of node b on node a establishes an indirect dependency, the free node does not need to explicitly depend on node a.
dependencies[0] = b;
dependencies[1] = c;
cudaGraphNodeParams freeNodeParams = { cudaGraphNodeTypeMemFree };
freeNodeParams.free.dptr = params.alloc.dptr;
cudaGraphAddNode(&freeNode, graph, dependencies, NULL, 2, freeNodeParams);
// free node does not depend on kernel node d, so it must not access the freed graph allocation.
cudaGraphAddNode(&d, graph, &c, NULL, 1, &nodeParams);
// node e does not depend on the allocation node, so it must not access the allocation. This would be true even if the freeNode depended on kernel node e.
cudaGraphAddNode(&e, graph, NULL, NULL, 0, &nodeParams);
4.2.5.2.2. 流捕获
可以通过捕获相应的流有序分配和释放调用cudaMallocAsync与cudaFreeAsync来创建图内存节点。在这种情况下,被捕获的分配 API 返回的虚拟地址可供图内的其他操作使用。由于流有序依赖关系将被捕获到图中,因此流有序分配 API 的排序要求可保证图内存节点相对于被捕获的流操作具有正确的顺序(对于正确编写的流代码而言)。
为清晰起见,忽略核函数节点d和e,以下代码片段展示了如何使用流捕获来创建上一幅图中的图:
cudaMallocAsync(&dptr, size, stream1);
kernel_A<<< ..., stream1 >>>(dptr, ...);

// Fork into stream2
cudaEventRecord(event1, stream1);
cudaStreamWaitEvent(stream2, event1);

kernel_B<<< ..., stream1 >>>(dptr, ...);
// event dependencies translated into graph dependencies, so the kernel node created by the capture of kernel C will depend on the allocation node created by capturing the cudaMallocAsync call.
kernel_C<<< ..., stream2 >>>(dptr, ...);

// Join stream2 back to origin stream (stream1)
cudaEventRecord(event2, stream2);
cudaStreamWaitEvent(stream1, event2);

// Free depends on all work accessing the memory.
cudaFreeAsync(dptr, stream1);

// End capture in the origin stream
cudaStreamEndCapture(stream1, &graph);
4.2.5.2.3. 在执行分配的图之外访问和释放图内存
图分配不一定要由执行分配的图来释放。当图不释放某项分配时,该分配会在图执行结束后继续存在,并且可以由后续 CUDA 操作访问。只要通过 CUDA 事件和其他流排序机制,使访问操作在顺序上位于分配之后,就可以在另一个图中访问这些分配,也可以直接使用流操作访问。随后可以通过常规调用cudaFree、cudaFreeAsync来释放分配,也可以通过启动另一个具有相应释放节点的图来释放,或者通过随后再次启动执行分配的图来释放(如果该图使用cudaGraphInstantiateFlagAutoFreeOnLaunch标志进行了实例化)。在内存释放后访问它是非法的,必须使用图依赖关系、CUDA 事件及其他流排序机制,使释放操作在顺序上位于所有访问该内存的操作之后。
注意
由于图分配可能共享底层物理内存,因此释放操作在顺序上必须位于所有设备操作完成之后。带外同步(例如计算核函数内基于内存的同步)不足以对内存写入和释放操作进行排序。有关更多信息,请参阅虚拟别名支持中与一致性和相干性相关的规则。
以下三个代码片段演示了如何在执行分配的图之外访问图分配,并分别通过以下方式建立正确的顺序:使用单个流、在流之间使用事件,以及使用内嵌在分配图和释放图中的事件。
第一,通过使用单个流建立顺序:
// Contents of allocating graph
void *dptr;
cudaGraphNodeParams params = { cudaGraphNodeTypeMemAlloc };
params.alloc.poolProps.allocType = cudaMemAllocationTypePinned;
params.alloc.poolProps.location.type = cudaMemLocationTypeDevice;
params.alloc.bytesize = size;
cudaGraphAddNode(&allocNode, allocGraph, NULL, NULL, 0, ¶ms);
dptr = params.alloc.dptr;
cudaGraphInstantiate(&allocGraphExec, allocGraph, 0);
cudaGraphLaunch(allocGraphExec, stream);
kernel<<< ..., stream >>>(dptr, ...);
cudaFreeAsync(dptr, stream);
第二,通过记录和等待 CUDA 事件建立顺序:
// Contents of allocating graph
void *dptr;

// Contents of allocating graph
cudaGraphAddNode(&allocNode, allocGraph, NULL, NULL, 0, &allocNodeParams);
dptr = allocNodeParams.alloc.dptr;

// contents of consuming/freeing graph
kernelNodeParams.kernel.kernelParams[0] = allocNodeParams.alloc.dptr;
cudaGraphAddNode(&freeNode, freeGraph, NULL, NULL, 1, dptr);

cudaGraphInstantiate(&allocGraphExec, allocGraph, 0);
cudaGraphInstantiate(&freeGraphExec, freeGraph, 0);

cudaGraphLaunch(allocGraphExec, allocStream);

// establish the dependency of stream2 on the allocation node
// note: the dependency could also have been established with a stream synchronize operation
cudaEventRecord(allocEvent, allocStream);
cudaStreamWaitEvent(stream2, allocEvent);

kernel<<< ..., stream2 >>> (dptr, ...);

// establish the dependency between the stream 3 and the allocation use
cudaStreamRecordEvent(streamUseDoneEvent, stream2);
cudaStreamWaitEvent(stream3, streamUseDoneEvent);

// it is now safe to launch the freeing graph, which may also access the memory
cudaGraphLaunch(freeGraphExec, stream3);
第三,通过使用图外部事件节点建立顺序:
// Contents of allocating graph
void *dptr;
cudaEvent_t allocEvent; // event indicating when the allocation will be ready for use.
cudaEvent_t streamUseDoneEvent; // event indicating when the stream operations are done with the allocation.

// Contents of allocating graph with event record node
cudaGraphAddNode(&allocNode, allocGraph, NULL, NULL, 0, &allocNodeParams);
dptr = allocNodeParams.alloc.dptr;
// note: this event record node depends on the alloc node

cudaGraphNodeParams allocEventNodeParams = { cudaGraphNodeTypeEventRecord };
allocEventNodeParams.eventRecord.event = allocEvent;
cudaGraphAddNode(&recordNode, allocGraph, &allocNode, NULL, 1, allocEventNodeParams);
cudaGraphInstantiate(&allocGraphExec, allocGraph, 0);

// contents of consuming/freeing graph with event wait nodes
cudaGraphNodeParams streamWaitEventNodeParams = { cudaGraphNodeTypeEventWait };
streamWaitEventNodeParams.eventWait.event = streamUseDoneEvent;
cudaGraphAddNode(&streamUseDoneEventNode, waitAndFreeGraph, NULL, NULL, 0, streamWaitEventNodeParams);

cudaGraphNodeParams allocWaitEventNodeParams = { cudaGraphNodeTypeEventWait };
allocWaitEventNodeParams.eventWait.event = allocEvent;
cudaGraphAddNode(&allocReadyEventNode, waitAndFreeGraph, NULL, NULL, 0, allocWaitEventNodeParams);

kernelNodeParams->kernelParams[0] = allocNodeParams.alloc.dptr;

// The allocReadyEventNode provides ordering with the alloc node for use in a consuming graph.
cudaGraphAddNode(&kernelNode, waitAndFreeGraph, &allocReadyEventNode, NULL, 1, &kernelNodeParams);

// The free node has to be ordered after both external and internal users.
// Thus the node must depend on both the kernelNode and the streamUseDoneEventNode.
dependencies[0] = kernelNode;
dependencies[1] = streamUseDoneEventNode;

cudaGraphNodeParams freeNodeParams = { cudaGraphNodeTypeMemFree };
freeNodeParams.free.dptr = dptr;
cudaGraphAddNode(&freeNode, waitAndFreeGraph, &dependencies, NULL, 2, freeNodeParams);
cudaGraphInstantiate(&waitAndFreeGraphExec, waitAndFreeGraph, 0);

cudaGraphLaunch(allocGraphExec, allocStream);

// establish the dependency of stream2 on the event node satisfies the ordering requirement
cudaStreamWaitEvent(stream2, allocEvent);
kernel<<< ..., stream2 >>> (dptr, ...);
cudaStreamRecordEvent(streamUseDoneEvent, stream2);

// the event wait node in the waitAndFreeGraphExec establishes the dependency on the "readyForFreeEvent" that is needed to prevent the kernel running in stream two from accessing the allocation after the free node in execution order.
cudaGraphLaunch(waitAndFreeGraphExec, stream3);
4.2.5.2.4. cudaGraphInstantiateFlagAutoFreeOnLaunch
在正常情况下,如果图存在尚未释放的内存分配,CUDA 会阻止重新启动该图,因为在同一地址进行多次分配会导致内存泄漏。使用cudaGraphInstantiateFlagAutoFreeOnLaunch标志实例化图,允许在图仍有尚未释放的分配时重新启动该图。在这种情况下,启动会自动插入对尚未释放的分配的异步释放操作。
启动时自动释放对于单生产者、多消费者算法很有用。在每次迭代中,生产者图会创建若干分配,而根据运行时条件,一组可能变化的消费者会访问这些分配。这种可变的执行序列意味着消费者不能释放这些分配,因为后续消费者可能需要访问它们。启动时自动释放意味着启动循环无需跟踪生产者的分配,而是将这些信息继续限定在生产者的创建和销毁逻辑中。一般而言,启动时自动释放简化了那些原本需要在每次重新启动之前释放图所拥有的所有分配的算法。
注意
cudaGraphInstantiateFlagAutoFreeOnLaunch标志不会改变图销毁的行为。即使对于使用该标志实例化的图,应用程序也必须显式释放尚未释放的内存,以避免内存泄漏。以下代码展示了如何使用cudaGraphInstantiateFlagAutoFreeOnLaunch简化单生产者/多消费者算法:
// Create producer graph which allocates memory and populates it with data
cudaStreamBeginCapture(cudaStreamPerThread, cudaStreamCaptureModeGlobal);
cudaMallocAsync(&data1, blocks * threads, cudaStreamPerThread);
cudaMallocAsync(&data2, blocks * threads, cudaStreamPerThread);
produce<<<blocks, threads, 0, cudaStreamPerThread>>>(data1, data2);
...
cudaStreamEndCapture(cudaStreamPerThread, &graph);
cudaGraphInstantiateWithFlags(&producer,
                              graph,
                              cudaGraphInstantiateFlagAutoFreeOnLaunch);
cudaGraphDestroy(graph);

// Create first consumer graph by capturing an asynchronous library call
cudaStreamBeginCapture(cudaStreamPerThread, cudaStreamCaptureModeGlobal);
consumerFromLibrary(data1, cudaStreamPerThread);
cudaStreamEndCapture(cudaStreamPerThread, &graph);
cudaGraphInstantiateWithFlags(&consumer1, graph, 0); //regular instantiation
cudaGraphDestroy(graph);

// Create second consumer graph
cudaStreamBeginCapture(cudaStreamPerThread, cudaStreamCaptureModeGlobal);
consume2<<<blocks, threads, 0, cudaStreamPerThread>>>(data2);
...
cudaStreamEndCapture(cudaStreamPerThread, &graph);
cudaGraphInstantiateWithFlags(&consumer2, graph, 0);
cudaGraphDestroy(graph);

// Launch in a loop
bool launchConsumer2 = false;
do {
    cudaGraphLaunch(producer, myStream);
    cudaGraphLaunch(consumer1, myStream);
    if (launchConsumer2) {
        cudaGraphLaunch(consumer2, myStream);
    }
} while (determineAction(&launchConsumer2));

cudaFreeAsync(data1, myStream);
cudaFreeAsync(data2, myStream);

cudaGraphExecDestroy(producer);
cudaGraphExecDestroy(consumer1);
cudaGraphExecDestroy(consumer2);
4.2.5.2.5. 子图中的内存节点
CUDA 12.9 引入了将子图所有权移交给父图的功能。移交给父图的子图允许包含内存分配和释放节点。这使得包含分配或释放节点的子图可以在添加到父图之前独立构建。
子图移交后适用以下限制:
不能独立实例化或销毁。
不能作为子图添加到另一个父图中。
不能用作 cuGraphExecUpdate 的参数。
不能再向其中添加内存分配或释放节点。
// Create the child graph
cudaGraphCreate(&child, 0);

// parameters for a basic allocation
cudaGraphNodeParams allocNodeParams = { cudaGraphNodeTypeMemAlloc };
allocNodeParams.alloc.poolProps.allocType = cudaMemAllocationTypePinned;
allocNodeParams.alloc.poolProps.location.type = cudaMemLocationTypeDevice;
// specify device 0 as the resident device
allocNodeParams.alloc.poolProps.location.id = 0;
allocNodeParams.alloc.bytesize = size;

cudaGraphAddNode(&allocNode, child, NULL, NULL, 0, &allocNodeParams);
// Additional nodes using the allocation could be added here
cudaGraphNodeParams freeNodeParams = { cudaGraphNodeTypeMemFree };
freeNodeParams.free.dptr = allocNodeParams.alloc.dptr;
cudaGraphAddNode(&freeNode, child, &allocNode, NULL, 1, freeNodeParams);

// Create the parent graph
cudaGraphCreate(&parent, 0);

// Move the child graph to the parent graph
cudaGraphNodeParams childNodeParams = { cudaGraphNodeTypeGraph };
childNodeParams.graph.graph = child;
childNodeParams.graph.ownership = cudaGraphChildGraphOwnershipMove;
cudaGraphAddNode(&parentNode, parent, NULL, NULL, 0, &childNodeParams);
4.2.5.3. 优化的内存复用
CUDA 通过两种方式复用内存:
图内虚拟内存和物理内存的复用基于虚拟地址分配,与流有序分配器中的方式类似。
图之间物理内存的复用通过虚拟别名实现:不同的图可以将同一物理内存映射到各自唯一的虚拟地址。
4.2.5.3.1. 图内地址复用
CUDA 可以将相同的虚拟地址范围分配给生命周期不重叠的不同内存分配,从而在图内复用内存。由于虚拟地址可能被复用,因此不能保证指向生命周期互不重叠的不同内存分配的指针是唯一的。
下图展示了添加一个新分配节点(2)的情况,该节点可以复用具有依赖关系的节点(1)所释放的地址。
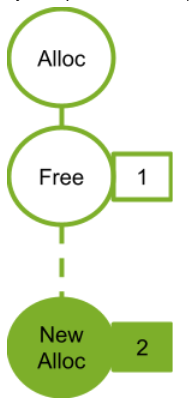
图 31 添加新分配节点 2
下图展示了添加一个新分配节点(4)的情况。新分配节点不依赖于释放节点(2),因此无法复用关联分配节点(2)的地址。如果分配节点(2)使用了释放节点(1)释放的地址,那么新分配节点 3 将需要一个新地址。
图内文字中文对照
Alloc- 分配
Free- 释放
New Alloc- 新分配
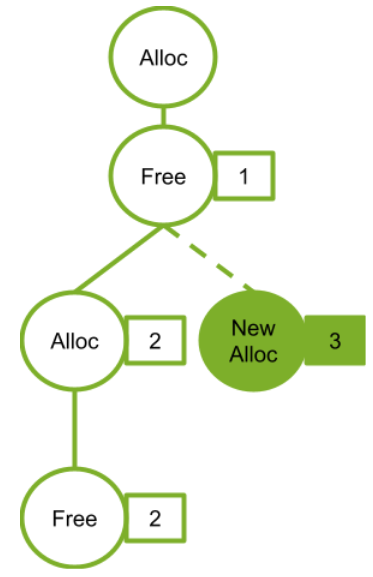
图 32 添加新分配节点 3
图内文字中文对照
Alloc- 分配
Free- 释放
New Alloc- 新分配
4.2.5.3.2. 物理内存管理与共享
CUDA 负责在 GPU 执行顺序到达分配节点之前,将物理内存映射到虚拟地址。为了优化内存占用和映射开销,如果多个图不会同时运行,它们可以将同一物理内存用于不同的内存分配;但是,如果物理页同时绑定到多个正在执行的图,或绑定到尚未释放的图内存分配,则不能复用这些物理页。
CUDA 可以在图实例化、启动或执行期间的任何时刻更新物理内存映射。CUDA 还可以在后续图启动之间引入同步,以防止仍然存续的图内存分配引用同一物理内存。与任何分配、释放、再分配模式一样,如果程序在某次内存分配的生命周期之外访问指针,那么该错误访问可能会在不报错的情况下读取或写入另一内存分配所拥有的有效数据(即使该内存分配的虚拟地址是唯一的)。使用 compute sanitizer 工具可以捕获此错误。
下图展示了在同一流中依次启动的图。在此示例中,每个图都会释放其分配的全部内存。由于同一流中的图从不并发运行,因此 CUDA 可以而且应该使用同一物理内存来满足所有内存分配。
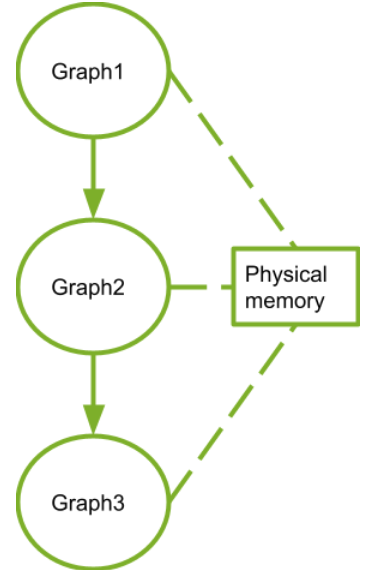
图 33 依次启动的图
图内文字中文对照
Graph1- 图 1
Graph2- 图 2
Graph3- 图 3
Physical memory- 物理内存
4.2.5.4. 性能注意事项
当多个图被启动到同一流中时,CUDA 会尝试为它们分配相同的物理内存,因为这些图的执行不可能重叠。作为一种优化,图的物理映射会在各次启动之间保留,以避免重新映射的开销。如果稍后某个图以其执行可能与其他图重叠的方式启动(例如,被启动到另一个流中),那么 CUDA 就必须执行一些重新映射,因为并发图需要不同的内存以避免数据损坏。
通常,CUDA 中的图内存重新映射可能由以下操作引起:
更改图启动所使用的流
对图内存池执行裁剪操作,该操作会显式释放未使用的内存(在物理内存占用中讨论)
当另一个图中尚未释放的内存分配映射到同一内存时,重新启动一个图会导致在重新启动之前对内存进行重新映射
重新映射必须按执行顺序发生,但必须在该图此前的任何执行完成之后进行(否则,仍在使用的内存可能会被取消映射)。由于存在这种顺序依赖关系,而且映射操作是操作系统调用,因此映射操作的开销可能相对较高。应用程序可以通过始终将包含内存分配节点的图启动到同一流中来避免此开销。
4.2.5.4.1. 首次启动 / cudaGraphUpload
图实例化期间无法分配或映射物理内存,因为尚不知道图将在哪个流中执行。映射改为在图启动期间完成。调用cudaGraphUpload会立即执行该图的所有映射,并将该图与上传流关联,从而将分配开销从启动中分离出来。如果随后将图启动到同一流中,则启动时不会进行任何额外的重新映射。
为图上传和图启动使用不同流的行为与切换流类似,很可能导致重新映射操作。此外,允许不相关的内存池管理从空闲流中取走内存,这可能使上传的效果失效。
4.2.5.5. 物理内存占用
异步分配的内存池管理行为意味着,销毁包含内存节点的图(即使这些节点的内存分配已释放)并不会立即将物理内存归还给操作系统,供其他进程使用。要显式将内存释放回操作系统,应用程序应使用cudaDeviceGraphMemTrimAPI。
cudaDeviceGraphMemTrim将取消映射并释放图内存节点预留的、当前未被使用的所有物理内存。尚未释放的内存分配以及已调度或正在运行的图被视为正在使用物理内存,因此不会受到影响。使用裁剪 API 将使物理内存可供其他分配 API 以及其他应用程序或进程使用,但会导致 CUDA 在下次启动经过裁剪的图时重新分配并重新映射内存。请注意,cudaDeviceGraphMemTrim与cudaMemPoolTrimTo()操作的是不同的内存池。图内存池不向 steam 有序内存分配器开放。CUDA 允许应用程序通过cudaDeviceGetGraphMemAttributeAPI 查询其图内存占用。查询属性cudaGraphMemAttrReservedMemCurrent会返回驱动程序为当前进程中的图内存分配预留的物理内存量。查询cudaGraphMemAttrUsedMemCurrent会返回当前至少被一个图映射的物理内存量。这两个属性中的任意一个都可用于跟踪 CUDA 何时为执行分配的图获取了新的物理内存。这两个属性都有助于检查共享机制节省了多少内存。
4.2.5.6. 对等访问
图内存分配可以配置为允许多个 GPU 访问,在这种情况下,CUDA 将按需把这些内存分配映射到对等 GPU。CUDA 允许需要不同映射的图内存分配复用同一虚拟地址。发生这种情况时,该地址范围会映射到这些不同内存分配所要求的所有 GPU。这意味着,某次内存分配有时允许的对等访问范围可能比创建时请求的更大;但是,依赖这些额外映射仍然是错误的。
4.2.5.6.1. 通过图节点 API 进行对等访问
cudaGraphAddNodeAPI 通过分配节点参数结构体的accessDescs数组字段接收映射请求。嵌入的poolProps.location结构体指定该内存分配的驻留设备。由于假定需要允许执行分配的 GPU 进行访问,因此应用程序不必在accessDescs数组中为驻留设备指定条目。
cudaGraphNodeParams allocNodeParams = { cudaGraphNodeTypeMemAlloc };
allocNodeParams.alloc.poolProps.allocType = cudaMemAllocationTypePinned;
allocNodeParams.alloc.poolProps.location.type = cudaMemLocationTypeDevice;
// specify device 1 as the resident device
allocNodeParams.alloc.poolProps.location.id = 1;
allocNodeParams.alloc.bytesize = size;

// allocate an allocation resident on device 1 accessible from device 1
cudaGraphAddNode(&allocNode, graph, NULL, NULL, 0, &allocNodeParams);

cudaMemAccessDesc accessDescs[2];
// boilerplate for the access descs (only ReadWrite and Device access supported by the add node api)
accessDescs[0].flags = cudaMemAccessFlagsProtReadWrite;
accessDescs[0].location.type = cudaMemLocationTypeDevice;
accessDescs[1].flags = cudaMemAccessFlagsProtReadWrite;
accessDescs[1].location.type = cudaMemLocationTypeDevice;

// access being requested for device 0 & 2.  Device 1 access requirement left implicit.
accessDescs[0].location.id = 0;
accessDescs[1].location.id = 2;

// access request array has 2 entries.
allocNodeParams.accessDescCount = 2;
allocNodeParams.accessDescs = accessDescs;

// allocate an allocation resident on device 1 accessible from devices 0, 1 and 2. (0 & 2 from the descriptors, 1 from it being the resident device).
cudaGraphAddNode(&allocNode, graph, NULL, NULL, 0, &allocNodeParams);
4.2.5.6.2. 通过流捕获进行对等访问
对于流捕获,分配节点会记录执行分配的内存池在捕获时的对等可访问性。在捕获cudaMallocFromPoolAsync调用之后更改执行分配的内存池的对等可访问性,不会影响图将为该内存分配建立的映射。
// boilerplate for the access descs (only ReadWrite and Device access supported by the add node api)
accessDesc.flags = cudaMemAccessFlagsProtReadWrite;
accessDesc.location.type = cudaMemLocationTypeDevice;
accessDesc.location.id = 1;

// let memPool be resident and accessible on device 0

cudaStreamBeginCapture(stream);
cudaMallocFromPoolAsync(&dptr1, size, memPool, stream);
cudaStreamEndCapture(stream, &graph1);

cudaMemPoolSetAccess(memPool, &accessDesc, 1);

cudaStreamBeginCapture(stream);
cudaMallocFromPoolAsync(&dptr2, size, memPool, stream);
cudaStreamEndCapture(stream, &graph2);

//The graph node allocating dptr1 would only have the device 0 accessibility even though memPool now has device 1 accessibility.
//The graph node allocating dptr2 will have device 0 and device 1 accessibility, since that was the pool accessibility at the time of the cudaMallocFromPoolAsync call.
4.2.6. 设备图启动
许多工作流需要在运行时做出依赖于数据的决策,并根据这些决策执行不同的操作。用户可能更愿意在设备上执行这一决策过程,而不是将其交给主机,因为后者可能需要从设备到主机再返回设备的往返通信。为此,CUDA 提供了从设备启动图的机制。
设备图启动提供了一种在设备上执行动态控制流的便捷方式,无论是像循环这样简单的控制流,还是像设备端工作调度器这样复杂的控制流。
下文将能够从设备启动的图称为设备图,将不能从设备启动的图称为主机图。
设备图既可以从主机启动,也可以从设备启动,而主机图只能从主机启动。与主机启动不同,在图的前一次启动仍在运行时从设备启动该设备图,将导致错误并返回cudaErrorInvalidValue;因此,不能同时从设备启动同一个设备图两次。同时从主机和设备启动一个设备图将导致未定义行为。
4.2.6.1. 设备图创建
为了能够从设备启动图,必须显式地将其针对设备启动进行实例化。这通过向cudaGraphInstantiate()调用传递cudaGraphInstantiateFlagDeviceLaunch标志来实现。与主机图一样,设备图的结构在实例化时就已固定,不重新实例化就无法更新,而且实例化只能在主机上进行。为了能够针对设备启动进行实例化,图必须满足各种要求。
4.2.6.1.1. 设备图要求
一般要求:
图的所有节点都必须驻留在同一个设备上。
图只能包含核函数节点、memcpy 节点、memset 节点和子图节点。
核函数节点:
不允许图中的核函数使用 CUDA 动态并行。
只要未使用 MPS,就允许协作启动。
Memcpy 节点:
仅允许涉及设备内存和/或映射到设备的页锁定主机内存的复制。
不允许涉及 CUDA 数组的复制。
在实例化时,当前设备必须能够访问这两个操作数。请注意,复制操作将由图所驻留的设备执行,即使其目标是另一个设备上的内存。
4.2.6.1.2. 设备图上传
为了在设备上启动图,必须先将其上传到设备,以填充必要的设备资源。这可以通过以下两种方式之一实现。
首先,可以显式上传图,方式是使用cudaGraphUpload(),或者通过cudaGraphInstantiateWithParams()请求在实例化过程中进行上传。
另一种方式是先从主机启动图,这会在启动过程中隐式执行此上传步骤。
以下给出了全部三种方法的示例:
// Explicit upload after instantiation
cudaGraphInstantiate(&deviceGraphExec1, deviceGraph1, cudaGraphInstantiateFlagDeviceLaunch);
cudaGraphUpload(deviceGraphExec1, stream);

// Explicit upload as part of instantiation
cudaGraphInstantiateParams instantiateParams = {0};
instantiateParams.flags = cudaGraphInstantiateFlagDeviceLaunch | cudaGraphInstantiateFlagUpload;
instantiateParams.uploadStream = stream;
cudaGraphInstantiateWithParams(&deviceGraphExec2, deviceGraph2, &instantiateParams);

// Implicit upload via host launch
cudaGraphInstantiate(&deviceGraphExec3, deviceGraph3, cudaGraphInstantiateFlagDeviceLaunch);
cudaGraphLaunch(deviceGraphExec3, stream);
4.2.6.1.3. 设备图更新
设备图只能从主机更新,而且在更新可执行图后,必须将其重新上传到设备,才能使更改生效。这可以使用设备图上传一节中概述的相同方法来实现。与主机图不同,在应用更新期间从设备启动设备图将导致未定义行为。
4.2.6.2. 设备启动
设备图既可以从主机通过cudaGraphLaunch()启动,也可以从设备通过它启动,该函数在设备上的签名与主机上的相同。设备图在主机和设备上通过同一个句柄启动。从设备启动设备图时,必须从另一个图中启动。
设备端图启动是逐线程进行的,不同线程可能同时发起多次启动,因此用户需要选择单个线程来启动给定的图。
与主机启动不同,设备图不能启动到常规 CUDA 流中,而只能启动到不同的命名流中,每种命名流表示一种特定的启动模式。下表列出了可用的启动模式。
流 |
启动模式 |
|---|---|
|
即发即弃启动 |
|
尾部启动 |
|
同级启动 |
4.2.6.2.1. 即发即弃启动
顾名思义,即发即弃启动会立即提交给 GPU,并且独立于发起启动的图运行。在即发即弃场景中,发起启动的图是父图,被启动的图是子图。
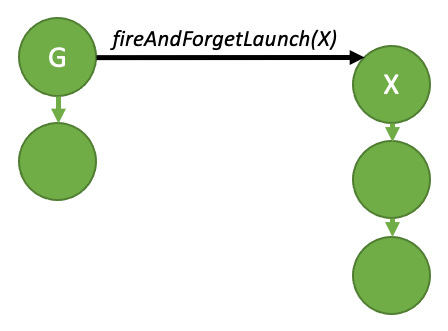
图 34 即发即弃启动
上图可以由以下示例代码生成:
__global__ void launchFireAndForgetGraph(cudaGraphExec_t graph) {
    cudaGraphLaunch(graph, cudaStreamGraphFireAndForget);
}

void graphSetup() {
    cudaGraphExec_t gExec1, gExec2;
    cudaGraph_t g1, g2;

    // Create, instantiate, and upload the device graph.
    create_graph(&g2);
    cudaGraphInstantiate(&gExec2, g2, cudaGraphInstantiateFlagDeviceLaunch);
    cudaGraphUpload(gExec2, stream);

    // Create and instantiate the launching graph.
    cudaStreamBeginCapture(stream, cudaStreamCaptureModeGlobal);
    launchFireAndForgetGraph<<<1, 1, 0, stream>>>(gExec2);
    cudaStreamEndCapture(stream, &g1);
    cudaGraphInstantiate(&gExec1, g1, 0);

    // Launch the host graph, which will in turn launch the device graph.
    cudaGraphLaunch(gExec1, stream);
}
一个图在其执行过程中总共最多可以有 120 个即发即弃图。每次启动同一个父图时,此总数都会重置。
4.2.6.2.1.1. 图执行环境
要全面理解设备端同步模型,首先必须理解执行环境的概念。
从设备启动图时,图会启动到其自身的执行环境中。给定图的执行环境封装了该图中的所有工作,以及所生成的所有即发即弃工作。当该图已完成执行,并且所生成的所有子工作都已完成时,便可以认为该图已完成。
下图展示了上一节中的即发即弃示例代码将生成的环境封装。
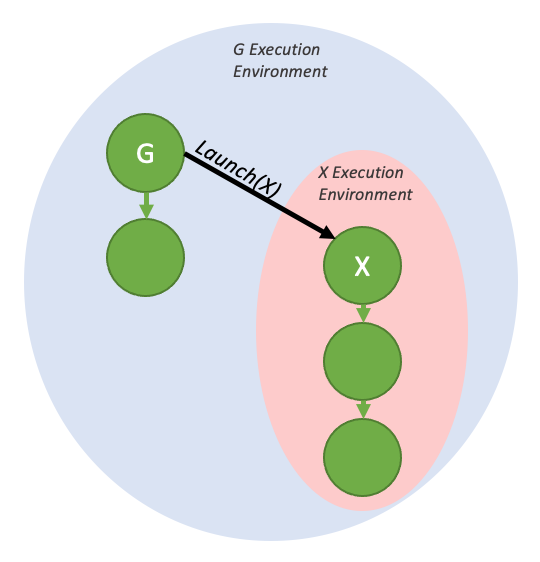
图 35 带有执行环境的即发即弃启动
图内文字中文对照
G Execution Environment- G 执行环境
X Execution Environment- X 执行环境
这些环境还具有层次结构,因此一个图环境可以包含由即发即弃启动产生的多层子环境。
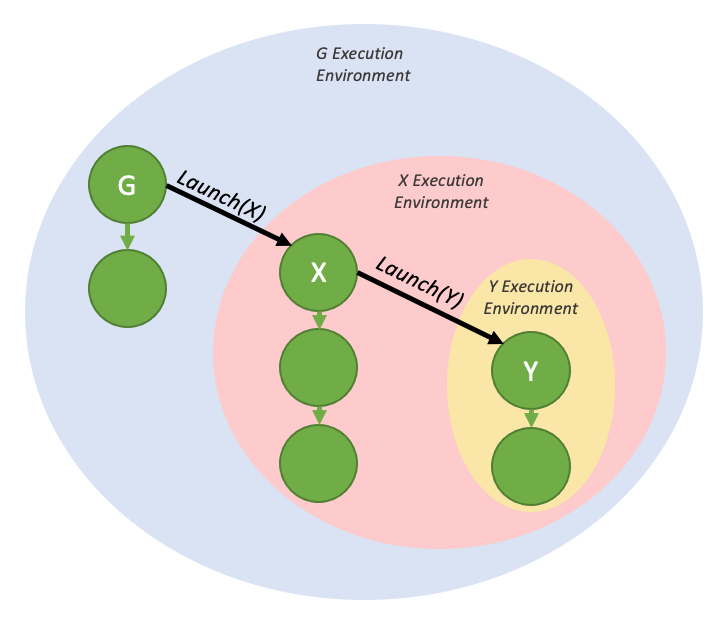
图 36 嵌套的即发即弃环境
图内文字中文对照
G Execution Environment- G 执行环境
X Execution Environment- X 执行环境
Y Execution Environment- Y 执行环境
从主机启动图时,存在一个流环境,作为被启动图的执行环境的父环境。流环境封装了整个启动过程中生成的所有工作。当整个流环境被标记为已完成时,流启动即告完成(即下游依赖工作此时可以运行)。
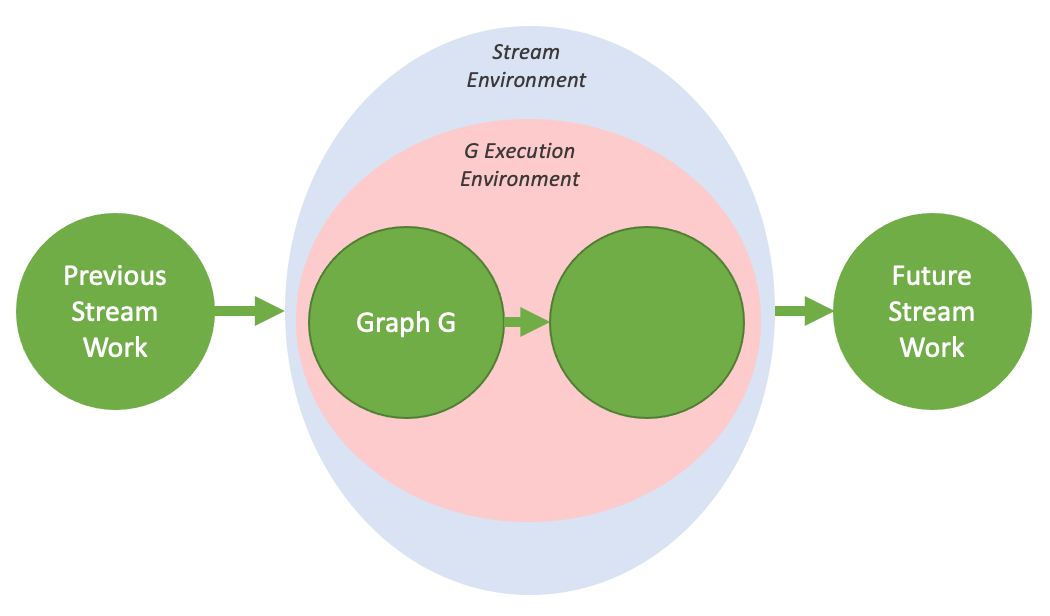
图 37 流环境的可视化表示
图内文字中文对照
Previous Stream Work- 先前的流工作
Stream Environment- 流环境
G Execution Environment- G 执行环境
Graph G- 图 G
Future Stream Work- 后续的流工作
4.2.6.2.2. 尾部启动
与在主机上不同,无法在 GPU 上通过cudaDeviceSynchronize()或cudaStreamSynchronize()等传统方法与设备图同步。相反,为了支持串行工作依赖关系,提供了另一种启动模式,即尾部启动,以提供类似的功能。
尾部启动在图的环境被视为完成时执行,即在图及其所有子图都完成时执行。当一个图完成时,尾部启动列表中下一个图的环境将替代已完成的环境,成为父环境的子环境。与即发即弃启动一样,一个图可以将多个图加入队列以进行尾部启动。
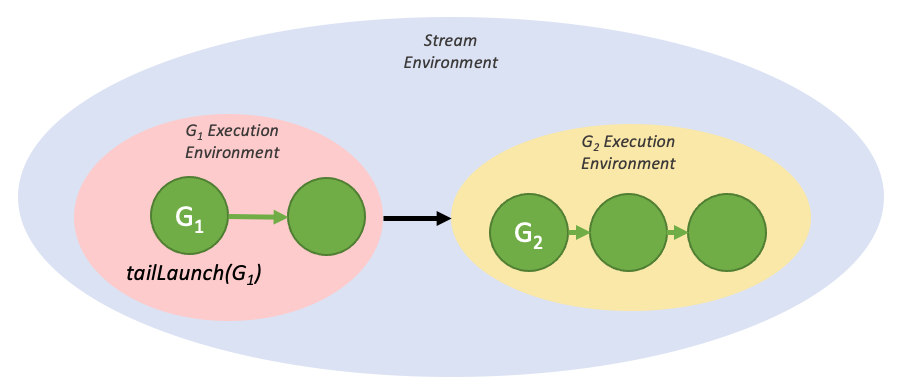
图 38 简单的尾部启动
图内文字中文对照
Stream Environment- 流环境
G₁ Execution Environment- G₁ 执行环境
G₂ Execution Environment- G₂ 执行环境
上述执行流程可由以下代码生成:
__global__ void launchTailGraph(cudaGraphExec_t graph) {
    cudaGraphLaunch(graph, cudaStreamGraphTailLaunch);
}

void graphSetup() {
    cudaGraphExec_t gExec1, gExec2;
    cudaGraph_t g1, g2;

    // Create, instantiate, and upload the device graph.
    create_graph(&g2);
    cudaGraphInstantiate(&gExec2, g2, cudaGraphInstantiateFlagDeviceLaunch);
    cudaGraphUpload(gExec2, stream);

    // Create and instantiate the launching graph.
    cudaStreamBeginCapture(stream, cudaStreamCaptureModeGlobal);
    launchTailGraph<<<1, 1, 0, stream>>>(gExec2);
    cudaStreamEndCapture(stream, &g1);
    cudaGraphInstantiate(&gExec1, g1, 0);

    // Launch the host graph, which will in turn launch the device graph.
    cudaGraphLaunch(gExec1, stream);
}
由某个图加入队列的尾部启动将按加入队列的顺序逐个执行。因此,第一个加入队列的图将首先运行,然后是第二个,依此类推。
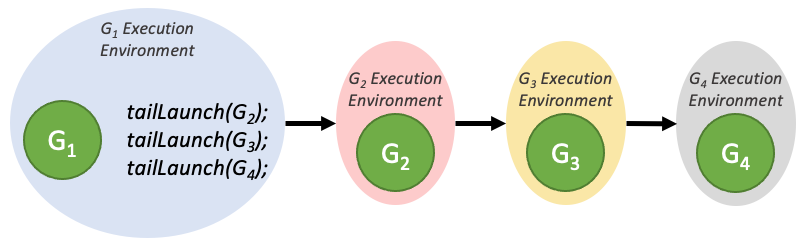
图 39 尾部启动的顺序
图内文字中文对照
G₁ Execution Environment- G₁ 执行环境
G₂ Execution Environment- G₂ 执行环境
G₃ Execution Environment- G₃ 执行环境
G₄ Execution Environment- G₄ 执行环境
由尾部图加入队列的尾部启动,将先于由尾部启动列表中此前的图加入队列的尾部启动执行。这些新的尾部启动将按加入队列的顺序执行。
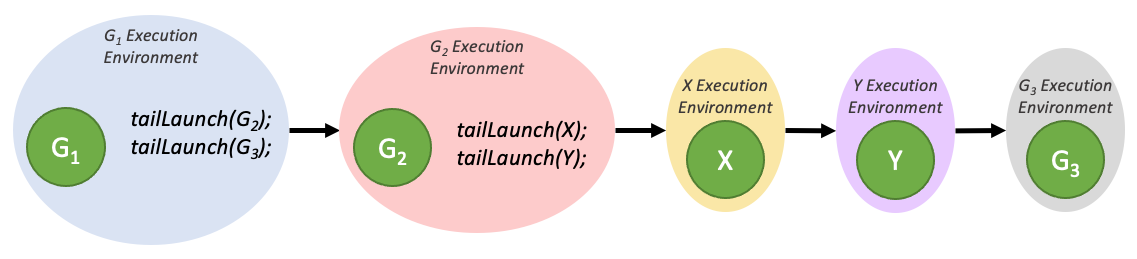
图 40 从多个图加入队列时的尾部启动顺序
图内文字中文对照
G₁ Execution Environment- G₁ 执行环境
G₂ Execution Environment- G₂ 执行环境
X Execution Environment- X 执行环境
Y Execution Environment- Y 执行环境
G₃ Execution Environment- G₃ 执行环境
一个图最多可以有 255 个待执行的尾部启动。
4.2.6.2.2.1. 尾部自启动
设备图可以将自身加入队列以进行尾部启动,不过,一个给定的图在同一时间只能有一个自启动处于队列中。为了查询当前正在运行的设备图,以便重新启动它,新增了一个设备端函数:
cudaGraphExec_t cudaGetCurrentGraphExec();
如果当前正在运行的图是设备图,此函数将返回该图的句柄。如果当前正在执行的核函数不是设备图中的节点,此函数将返回 NULL。
以下示例代码展示了如何使用此函数实现重新启动循环:
__device__ int relaunchCount = 0;

__global__ void relaunchSelf() {
    int relaunchMax = 100;

    if (threadIdx.x == 0) {
        if (relaunchCount < relaunchMax) {
            cudaGraphLaunch(cudaGetCurrentGraphExec(), cudaStreamGraphTailLaunch);
        }

        relaunchCount++;
    }
}
4.2.6.2.3. 同级启动
同级启动是即发即弃启动的一种变体,其中,图启动后并不是发起启动的图的执行环境的子环境,而是发起启动的图的父环境的子环境。同级启动等同于从发起启动的图的父环境进行即发即弃启动。
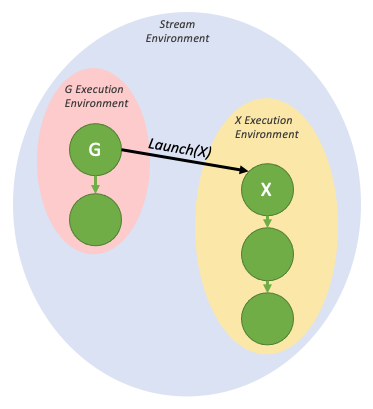
图 41 简单的同级启动
图内文字中文对照
Stream Environment- 流环境
G Execution Environment- G 执行环境
X Execution Environment- X 执行环境
上图可由以下示例代码生成:
__global__ void launchSiblingGraph(cudaGraphExec_t graph) {
    cudaGraphLaunch(graph, cudaStreamGraphFireAndForgetAsSibling);
}

void graphSetup() {
    cudaGraphExec_t gExec1, gExec2;
    cudaGraph_t g1, g2;

    // Create, instantiate, and upload the device graph.
    create_graph(&g2);
    cudaGraphInstantiate(&gExec2, g2, cudaGraphInstantiateFlagDeviceLaunch);
    cudaGraphUpload(gExec2, stream);

    // Create and instantiate the launching graph.
    cudaStreamBeginCapture(stream, cudaStreamCaptureModeGlobal);
    launchSiblingGraph<<<1, 1, 0, stream>>>(gExec2);
    cudaStreamEndCapture(stream, &g1);
    cudaGraphInstantiate(&gExec1, g1, 0);

    // Launch the host graph, which will in turn launch the device graph.
    cudaGraphLaunch(gExec1, stream);
}
由于同级启动并非启动到发起启动的图的执行环境中,因此它们不会阻塞由发起启动的图加入队列的尾部启动。
4.2.7. 使用图 API
cudaGraph_t对象不是线程安全的。用户有责任确保多个线程不会并发访问同一个cudaGraph_t。
cudaGraphExec_t不能与自身并发运行。cudaGraphExec_t的一次启动将排在同一个可执行图此前的启动之后。
图在流中执行,以便与其他异步工作确定先后顺序。但是,流仅用于确定顺序;它不会限制图的内部并行性,也不会影响图节点的执行位置。
请参阅图 API。
4.2.8. CUDA 用户对象
CUDA 用户对象可用于帮助管理 CUDA 中异步工作所使用的资源的生命周期。特别是,此功能对CUDA 图和流捕获很有用。
各种资源管理方案与 CUDA 图并不兼容。例如,考虑基于事件的池,或同步创建、异步销毁的方案。
// Library API with pool allocation
void libraryWork(cudaStream_t stream) {
    auto &resource = pool.claimTemporaryResource();
    resource.waitOnReadyEventInStream(stream);
    launchWork(stream, resource);
    resource.recordReadyEvent(stream);
}
// Library API with asynchronous resource deletion
void libraryWork(cudaStream_t stream) {
    Resource *resource = new Resource(...);
    launchWork(stream, resource);
    cudaLaunchHostFunc(
        stream,
        [](void *resource) {
            delete static_cast<Resource *>(resource);
        },
        resource,
        0);
    // Error handling considerations not shown
}
这些方案很难与 CUDA 图配合使用,因为资源的指针或句柄并不固定,需要间接寻址或图更新,而且每次提交工作时都需要同步的 CPU 代码。如果这些考量对库的调用方是隐藏的,这些方案也无法与流捕获配合使用;在捕获期间使用了不允许的 API 也使它们无法与流捕获配合使用。存在多种解决方案,例如向调用方公开资源。CUDA 用户对象提供了另一种方法。
CUDA 用户对象将用户指定的析构回调与内部引用计数关联起来,类似于 C++ 的shared_ptr。引用可以由 CPU 上的用户代码持有,也可以由 CUDA 图持有。请注意,对于用户持有的引用,与 C++ 智能指针不同,没有表示该引用的对象;用户必须手动跟踪用户持有的引用。典型用例是在创建用户对象后,立即将用户持有的唯一引用移交给 CUDA 图。
当引用与 CUDA 图关联时,CUDA 将自动管理图操作。克隆得到的cudaGraph_t会保留源cudaGraph_t持有的每个引用的副本,且重数相同。实例化得到的cudaGraphExec_t会保留源cudaGraph_t中的每个引用的副本。当cudaGraphExec_t在未同步的情况下被销毁时,这些引用会一直保留到执行完成。
以下是一个使用示例。
cudaGraph_t graph;  // Preexisting graph

Object *object = new Object;  // C++ object with possibly nontrivial destructor
cudaUserObject_t cuObject;
cudaUserObjectCreate(
    &cuObject,
    object,  // Here we use a CUDA-provided template wrapper for this API,
             // which supplies a callback to delete the C++ object pointer
    1,  // Initial refcount
    cudaUserObjectNoDestructorSync  // Acknowledge that the callback cannot be
                                    // waited on via CUDA
);
cudaGraphRetainUserObject(
    graph,
    cuObject,
    1,  // Number of references
    cudaGraphUserObjectMove  // Transfer a reference owned by the caller (do
                             // not modify the total reference count)
);
// No more references owned by this thread; no need to call release API
cudaGraphExec_t graphExec;
cudaGraphInstantiate(&graphExec, graph, 0);  // Will retain a
                                                               // new reference
cudaGraphDestroy(graph);  // graphExec still owns a reference
cudaGraphLaunch(graphExec, 0);  // Async launch has access to the user objects
cudaGraphExecDestroy(graphExec);  // Launch is not synchronized; the release
                                  // will be deferred if needed
cudaStreamSynchronize(0);  // After the launch is synchronized, the remaining
                           // reference is released and the destructor will
                           // execute. Note this happens asynchronously.
// If the destructor callback had signaled a synchronization object, it would
// be safe to wait on it at this point.
子图节点中的图所持有的引用与子图关联,而不是与父图关联。如果子图被更新或删除,引用也会相应改变。如果使用cudaGraphExecUpdate或cudaGraphExecChildGraphNodeSetParams更新可执行图或子图,则会克隆新源图中的引用,并用它们替换目标图中的引用。在这两种情况下,如果此前的启动尚未同步,任何本应释放的引用都将被保留,直到这些启动执行完毕。
目前没有通过 CUDA API 等待用户对象析构函数的机制。用户可以从析构函数代码中手动向同步对象发送信号。此外,不允许从析构函数中调用 CUDA API,这与对cudaLaunchHostFunc的限制类似。这是为了避免阻塞 CUDA 内部的共享线程并阻碍执行继续推进。如果依赖关系是单向的,而且执行调用的线程不会阻碍 CUDA 工作继续推进,则允许向另一个线程发送信号,让其执行 API 调用。
用户对象通过cudaUserObjectCreate创建,这是浏览相关 API 的一个良好起点。