3.3. CUDA 驱动程序 API
本指南前面的各节介绍了 CUDA 运行时。如CUDA 运行时 API 和 CUDA 驱动程序 API中所述,CUDA 运行时是在更底层的 CUDA 驱动程序 API 之上编写的。本节介绍 CUDA 运行时 API 与驱动程序 API 之间的一些差异,以及如何混合使用它们。大多数应用程序无需与 CUDA 驱动程序 API 交互即可获得全部性能。不过,新的接口有时会先在驱动程序 API 中提供,之后才在运行时 API 中提供;某些高级接口(例如虚拟内存管理)则仅通过驱动程序 API 公开。
驱动程序 API 在cuda动态库(cuda.dll或cuda.so)中实现,该库会在安装设备驱动程序时复制到系统上。它的所有入口点均以 cu 为前缀。
它是基于句柄的命令式 API:大多数对象通过不透明句柄引用,可将这些句柄传递给函数以操作对象。
驱动程序 API 中可用的对象汇总于表 6。
对象 |
句柄 |
说明 |
|---|---|---|
设备 |
CUdevice |
支持 CUDA 的设备 |
上下文 |
CUcontext |
大致相当于 CPU 进程 |
模块 |
CUmodule |
大致相当于动态库 |
函数 |
CUfunction |
核函数 |
堆内存 |
CUdeviceptr |
指向设备内存的指针 |
CUDA 数组 |
CUarray |
用于存放设备上一维或二维数据的不透明容器,可通过纹理引用或表面引用读取 |
纹理对象 |
CUtexref |
描述如何解释纹理内存数据的对象 |
表面引用 |
CUsurfref |
描述如何读取或写入 CUDA 数组的对象 |
流 |
CUstream |
描述 CUDA 流的对象 |
事件 |
CUevent |
描述 CUDA 事件的对象 |
在调用驱动程序 API 中的任何函数之前,必须使用cuInit()初始化驱动程序 API。随后,必须创建一个附属于特定设备的 CUDA 上下文,并将其设为调用方主机线程的当前上下文,详见上下文。
在 CUDA 上下文中,核函数由主机代码以 PTX 或二进制对象的形式显式加载,如模块中所述。因此,用 C++ 编写的核函数必须单独编译为PTX或二进制对象。核函数通过 API 入口点启动,如核函数执行中所述。
任何希望在未来设备架构上运行的应用程序都必须加载PTX,而非二进制代码。这是因为二进制代码是特定于架构的,因此与未来的架构不兼容,而PTX代码则由设备驱动程序在加载时编译为二进制代码。
以下是使用驱动程序 API 编写的核函数中示例的主机代码:
int main()
{
    int N = ...;
    size_t size = N * sizeof(float);

    // Allocate input vectors h_A and h_B in host memory
    float* h_A = (float*)malloc(size);
    float* h_B = (float*)malloc(size);

    // Initialize input vectors
    ...

    // Initialize
    cuInit(0);

    // Get number of devices supporting CUDA
    int deviceCount = 0;
    cuDeviceGetCount(&deviceCount);
    if (deviceCount == 0) {
        printf("There is no device supporting CUDA.\n");
        exit (0);
    }

    // Get handle for device 0
    CUdevice cuDevice;
    cuDeviceGet(&cuDevice, 0);

    // Create context
    CUcontext cuContext;
    cuCtxCreate(&cuContext, 0, cuDevice);

    // Create module from binary file
    CUmodule cuModule;
    cuModuleLoad(&cuModule, "VecAdd.ptx");

    // Allocate vectors in device memory
    CUdeviceptr d_A;
    cuMemAlloc(&d_A, size);
    CUdeviceptr d_B;
    cuMemAlloc(&d_B, size);
    CUdeviceptr d_C;
    cuMemAlloc(&d_C, size);

    // Copy vectors from host memory to device memory
    cuMemcpyHtoD(d_A, h_A, size);
    cuMemcpyHtoD(d_B, h_B, size);

    // Get function handle from module
    CUfunction vecAdd;
    cuModuleGetFunction(&vecAdd, cuModule, "VecAdd");

    // Invoke kernel
    int threadsPerBlock = 256;
    int blocksPerGrid =
            (N + threadsPerBlock - 1) / threadsPerBlock;
    void* args[] = { &d_A, &d_B, &d_C, &N };
    cuLaunchKernel(vecAdd,
                   blocksPerGrid, 1, 1, threadsPerBlock, 1, 1,
                   0, 0, args, 0);

    ...
}
完整代码可在vectorAddDrvCUDA 示例中找到。
3.3.1. 上下文
CUDA 上下文类似于 CPU 进程。驱动程序 API 中的所有资源以及执行的操作都封装在 CUDA 上下文内,系统会在上下文销毁时自动清理这些资源。除模块以及纹理引用或表面引用等对象外,每个上下文还有自己独立的地址空间。因此,不同上下文中的CUdeviceptr值引用不同的内存位置。
一个主机线程在任一时刻只能有一个当前设备上下文。使用cuCtxCreate()创建上下文时,该上下文会被设为调用方主机线程的当前上下文。如果线程没有有效的当前上下文,则在上下文中操作的 CUDA 函数(大多数不涉及设备枚举或上下文管理的函数)将返回CUDA_ERROR_INVALID_CONTEXT。
每个主机线程都有一个当前上下文栈。cuCtxCreate()将新上下文压入栈顶。可以调用cuCtxPopCurrent()将上下文与主机线程分离。随后,该上下文处于“浮动”状态,可以被压入任意主机线程的栈中,成为其当前上下文。cuCtxPopCurrent()还会恢复先前的当前上下文(如果存在)。
每个上下文还维护着一个使用计数。cuCtxCreate()创建使用计数为 1 的上下文。cuCtxAttach()增加使用计数,cuCtxDetach()减少使用计数。在调用cuCtxDetach()或cuCtxDestroy()时,如果使用计数降至 0,则上下文会被销毁。
驱动程序 API 可与运行时互操作,并且可以从驱动程序 API 通过cuDevicePrimaryCtxRetain()访问由运行时管理的主上下文(参见运行时初始化)。
使用计数有助于在同一上下文中运行的第三方编写的代码之间实现互操作。例如,如果加载了三个库以使用同一个上下文,则每个库都会调用cuCtxAttach()来增加使用计数,并在库使用完该上下文后调用cuCtxDetach()来减少使用计数。对于大多数库,预期应用程序会在加载或初始化库之前创建上下文;这样,应用程序就可以使用自己的启发式策略来创建上下文,而库只需在传递给它的上下文上操作。如果库希望在其 API 客户端不知情的情况下创建自己的上下文(这些客户端可能已经创建了自己的上下文,也可能没有),则会使用cuCtxPushCurrent()和cuCtxPopCurrent(),如下图所示。
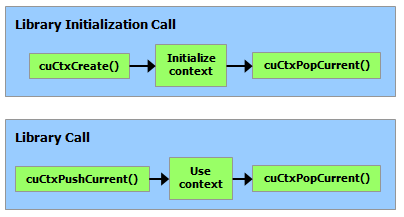
图 23 库的上下文管理
图内文字中文对照
Library Initialization Call- 库初始化调用
Initialize context- 初始化上下文
Library Call- 库调用
Use context- 使用上下文
3.3.2. 模块
模块是可动态加载的设备代码和数据包,类似于 Windows 中的 DLL,由 nvcc 输出(参见使用 NVCC 编译)。所有符号的名称(包括函数、全局变量以及纹理引用或表面引用)都在模块作用域内维护,因此,由独立第三方编写的模块可以在同一个 CUDA 上下文中互操作。
此代码示例加载一个模块,并获取某个核函数的句柄:
CUmodule cuModule;
cuModuleLoad(&cuModule, "myModule.ptx");
CUfunction myKernel;
cuModuleGetFunction(&myKernel, cuModule, "MyKernel");
此代码示例从 PTX 代码编译并加载一个新模块,并解析编译错误:
#define BUFFER_SIZE 8192
CUmodule cuModule;
CUjit_option options[3];
void* values[3];
char* PTXCode = "some PTX code";
char error_log[BUFFER_SIZE];
int err;
options[0] = CU_JIT_ERROR_LOG_BUFFER;
values[0]  = (void*)error_log;
options[1] = CU_JIT_ERROR_LOG_BUFFER_SIZE_BYTES;
values[1]  = (void*)BUFFER_SIZE;
options[2] = CU_JIT_TARGET_FROM_CUCONTEXT;
values[2]  = 0;
err = cuModuleLoadDataEx(&cuModule, PTXCode, 3, options, values);
if (err != CUDA_SUCCESS)
    printf("Link error:\n%s\n", error_log);
此代码示例从多份 PTX 代码编译、链接并加载一个新模块,并解析链接错误和编译错误:
#define BUFFER_SIZE 8192
CUmodule cuModule;
CUjit_option options[6];
void* values[6];
float walltime;
char error_log[BUFFER_SIZE], info_log[BUFFER_SIZE];
char* PTXCode0 = "some PTX code";
char* PTXCode1 = "some other PTX code";
CUlinkState linkState;
int err;
void* cubin;
size_t cubinSize;
options[0] = CU_JIT_WALL_TIME;
values[0] = (void*)&walltime;
options[1] = CU_JIT_INFO_LOG_BUFFER;
values[1] = (void*)info_log;
options[2] = CU_JIT_INFO_LOG_BUFFER_SIZE_BYTES;
values[2] = (void*)BUFFER_SIZE;
options[3] = CU_JIT_ERROR_LOG_BUFFER;
values[3] = (void*)error_log;
options[4] = CU_JIT_ERROR_LOG_BUFFER_SIZE_BYTES;
values[4] = (void*)BUFFER_SIZE;
options[5] = CU_JIT_LOG_VERBOSE;
values[5] = (void*)1;
cuLinkCreate(6, options, values, &linkState);
err = cuLinkAddData(linkState, CU_JIT_INPUT_PTX,
                    (void*)PTXCode0, strlen(PTXCode0) + 1, 0, 0, 0, 0);
if (err != CUDA_SUCCESS)
    printf("Link error:\n%s\n", error_log);
err = cuLinkAddData(linkState, CU_JIT_INPUT_PTX,
                    (void*)PTXCode1, strlen(PTXCode1) + 1, 0, 0, 0, 0);
if (err != CUDA_SUCCESS)
    printf("Link error:\n%s\n", error_log);
cuLinkComplete(linkState, &cubin, &cubinSize);
printf("Link completed in %fms. Linker Output:\n%s\n", walltime, info_log);
cuModuleLoadData(cuModule, cubin);
cuLinkDestroy(linkState);
通过使用多个线程,可以加速模块链接/加载过程中的某些部分,包括加载 cubin 时的某些部分。此代码示例使用CU_JIT_BINARY_LOADER_THREAD_COUNT来加速模块加载。
#define BUFFER_SIZE 8192
CUmodule cuModule;
CUjit_option options[3];
void* values[3];
char* cubinCode = "some cubin code";
char error_log[BUFFER_SIZE];
int err;
options[0] = CU_JIT_ERROR_LOG_BUFFER;
values[0]  = (void*)error_log;
options[1] = CU_JIT_ERROR_LOG_BUFFER_SIZE_BYTES;
values[1]  = (void*)BUFFER_SIZE;
options[2] = CU_JIT_BINARY_LOADER_THREAD_COUNT;
values[2]  = 0; // Use as many threads as CPUs on the machine
err = cuModuleLoadDataEx(&cuModule, cubinCode, 3, options, values);
if (err != CUDA_SUCCESS)
    printf("Link error:\n%s\n", error_log);
完整代码可在ptxjitCUDA 示例中找到。
3.3.3. 核函数执行
cuLaunchKernel()使用给定的执行配置启动核函数。
参数可以作为指针数组(cuLaunchKernel()的倒数第二个参数)传递,其中第 n 个指针对应于第 n 个参数,并指向用于复制该参数的源内存区域;也可以作为额外选项之一(cuLaunchKernel()的最后一个参数)传递。
当参数作为额外选项(CU_LAUNCH_PARAM_BUFFER_POINTER选项)传递时,它们以指向单个缓冲区的指针形式传递,其中假定各参数已按照设备代码中每种参数类型的对齐要求设置了适当的相对偏移。
内置向量类型在设备代码中的对齐要求列于表 43。对于所有其他基本类型,设备代码中的对齐要求与主机代码中的对齐要求一致,因此可使用__alignof()获得。唯一的例外是主机编译器将double和long long(以及 64 位系统上的long)对齐到单字边界而不是双字边界的情况(例如,使用gcc的编译标志-mno-align-double),因为在设备代码中,这些类型始终对齐到双字边界。
CUdeviceptr是一个整数,但表示一个指针,因此其对齐要求为__alignof(void*)。
以下代码示例使用一个宏(ALIGN_UP())调整每个参数的偏移量,以满足其对齐要求,并使用另一个宏(ADD_TO_PARAM_BUFFER())将每个参数添加到传递给CU_LAUNCH_PARAM_BUFFER_POINTER选项的参数缓冲区中。
#define ALIGN_UP(offset, alignment) \
(offset) = ((offset) + (alignment) - 1) & ~((alignment) - 1)
char paramBuffer[1024];
size_t paramBufferSize = 0;
#define ADD_TO_PARAM_BUFFER(value, alignment) \
do { \
paramBufferSize = ALIGN_UP(paramBufferSize, alignment); \
memcpy(paramBuffer + paramBufferSize, \
&(value), sizeof(value)); \
paramBufferSize += sizeof(value); \
} while (0)
int i;
ADD_TO_PARAM_BUFFER(i, __alignof(i));
float4 f4;
ADD_TO_PARAM_BUFFER(f4, 16); // float4's alignment is 16
char c;
ADD_TO_PARAM_BUFFER(c, __alignof(c));
float f;
ADD_TO_PARAM_BUFFER(f, __alignof(f));
CUdeviceptr devPtr;
ADD_TO_PARAM_BUFFER(devPtr, __alignof(devPtr));
float2 f2;
ADD_TO_PARAM_BUFFER(f2, 8); // float2's alignment is 8
void* extra[] = {
CU_LAUNCH_PARAM_BUFFER_POINTER, paramBuffer,
CU_LAUNCH_PARAM_BUFFER_SIZE, ¶mBufferSize,
CU_LAUNCH_PARAM_END
};
cuLaunchKernel(cuFunction,
blockWidth, blockHeight, blockDepth,
gridWidth, gridHeight, gridDepth,
0, 0, 0, extra);
结构体的对齐要求等于其各字段对齐要求的最大值。因此,包含内置向量类型、CUdeviceptr或未对齐的double和long long的结构体,在设备代码和主机代码中的对齐要求可能不同。此类结构体的填充方式也可能不同。例如,以下结构体在主机代码中完全不进行填充,但在设备代码中会在字段f之后填充 12 字节,因为字段f4的对齐要求为 16。
typedef struct {
    float  f;
    float4 f4;
} myStruct;
3.3.4. 运行时 API 与驱动程序 API 之间的互操作性
应用程序可以混合使用运行时 API 代码和驱动程序 API 代码。
如果通过驱动程序 API 创建上下文并将其设为当前上下文,则后续的运行时调用将使用此上下文,而不是创建新的上下文。
如果运行时已初始化,则可使用cuCtxGetCurrent()获取初始化期间创建的上下文。后续的驱动程序 API 调用可以使用此上下文。
由运行时隐式创建的上下文称为主上下文(参见运行时初始化)。可以从驱动程序 API 使用主上下文管理函数来管理它。
使用任一 API 都可以分配和释放设备内存。CUdeviceptr可以强制转换为普通指针,反之亦然:
CUdeviceptr devPtr;
float* d_data;

// Allocation using driver API
cuMemAlloc(&devPtr, size);
d_data = (float*)devPtr;

// Allocation using runtime API
cudaMalloc(&d_data, size);
devPtr = (CUdeviceptr)d_data;
具体而言,这意味着使用驱动程序 API 编写的应用程序可以调用使用运行时 API 编写的库(如 cuFFT、cuBLAS 等)。
参考手册中设备管理和版本管理各节的所有函数都可以互换使用。