4.20. CUDA 动态并行
4.20.1. 简介
4.20.1.1. 概述
CUDA 动态并行(通常缩写为 CDP)是 CUDA 编程模型的一项特性,它使 GPU 上运行的代码能够创建新的 GPU 工作。也就是说,已经在 GPU 上运行的设备代码可以通过额外的核函数启动向 GPU 添加新工作。该特性可以减少在主机和设备之间传递执行控制权和数据的需要,因为在设备上执行的线程可以在运行时做出启动配置决策。
核函数可以在运行时生成依赖于数据的并行工作。在 CUDA 中加入 CDP 之前,某些算法和编程模式需要进行修改,以消除递归、不规则循环结构或其他不适合扁平的单层并行的构造。使用 CUDA 动态并行可以更自然地表达这些程序结构。
注意
本节介绍 CUDA 动态并行的更新版本,有时称为 CDP2,它是 CUDA 12.0 及更高版本中的默认版本。CDP2 是计算能力(CC)9.0 及更高的设备上唯一可用的 CUDA 动态并行版本。对于 CC 低于 9.0 的设备,开发者仍可通过编译器参数-DCUDA_FORCE_CDP1_IF_SUPPORTED选择使用旧版 CUDA 动态并行 CDP1。CDP1 文档可在旧版 CUDA 编程指南中找到。计划在未来的 CUDA 版本中移除 CDP1。
4.20.2. 执行环境
CUDA 中的动态并行允许 GPU 线程配置、启动新网格,并对其进行隐式同步。网格是核函数启动的一个实例,其中包括线程块的具体形状以及由线程块组成的网格的具体形状。在以下各节中,需要注意核函数本身与该核函数的特定调用(即网格)之间的区别。
4.20.2.1. 父网格与子网格
配置并启动新网格的设备线程属于父网格。由该调用创建的新网格称为子网格。
子网格的调用和完成具有正确的嵌套关系,这意味着,只有当父网格的线程所创建的所有子网格都完成后,才认为父网格完成,并且运行时保证父网格与子网格之间存在隐式同步。
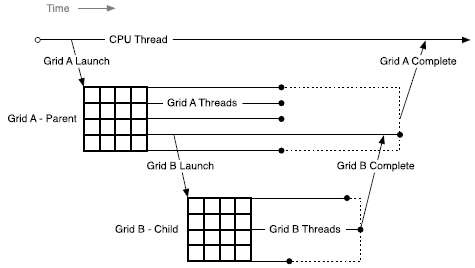
图 57 父子启动嵌套
图内文字中文对照
Time- 时间
CPU Thread- CPU 线程
Grid A Launch- 网格 A 启动
Grid A Complete- 网格 A 完成
Grid A Threads- 网格 A 的线程
Grid A - Parent- 网格 A(父网格)
Grid B Launch- 网格 B 启动
Grid B Complete- 网格 B 完成
Grid B - Child- 网格 B(子网格)
Grid B Threads- 网格 B 的线程
4.20.2.2. CUDA 原语的作用域
CUDA 动态并行依赖于CUDA 设备运行时,它支持调用一组有限的 API,这些 API 在语法上与 CUDA 运行时 API 类似,但可在设备代码中使用。设备运行时 API 的行为与其对应的主机端 API 类似,但存在一些差异。这些差异列于API 参考一节中的表格中。
在主机和设备上,CUDA 运行时都提供了用于启动核函数以及通过流和事件跟踪启动之间依赖关系的 API。在设备上,已启动的核函数和 CUDA 对象对发起调用的网格中的所有线程都可见。例如,这意味着一个流可以由一个线程创建,并由同一网格中的任何其他线程使用。但是,通过设备 API 调用创建的流和事件等 CUDA 对象,仅在创建它们的网格内有效。
4.20.2.3. 流和事件
CUDA 的流和事件允许控制核函数启动之间的依赖关系:启动到同一流中的核函数按顺序执行,而事件可用于在流之间创建依赖关系。在设备上创建的流和事件具有完全相同的用途。
在网格内创建的流和事件存在于该网格的作用域内,但在创建它们的网格之外使用时,其行为未定义。如上所述,网格退出时会对其启动的所有工作进行隐式同步;这也包括启动到流中的工作,所有依赖关系都会得到适当处理。对在网格作用域之外被修改的流执行操作,其行为未定义。
在主机上创建的流和事件在任何核函数中使用时,其行为未定义,正如父网格创建的流和事件在子网格中使用时,其行为未定义一样。
4.20.2.4. 顺序与并发
设备运行时发起的核函数启动的顺序遵循 CUDA 流的顺序语义。在网格内,启动到同一流中的所有核函数(即发即弃流除外)都按顺序执行。当同一网格中的多个线程向同一流发起启动时,流内的顺序取决于网格内的线程调度,而线程调度可以通过__syncthreads()等同步原语来控制。
请注意,虽然命名流由网格内的所有线程共享,但隐式NULL流仅由一个线程块内的所有线程共享。如果一个线程块中的多个线程向隐式流发起启动,则这些启动将按顺序执行。如果不同线程块中的线程向隐式流发起启动,则这些启动可能并发执行。如果希望一个线程块内多个线程发起的启动能够并发执行,应使用显式命名流。
设备运行时并未在 CUDA 执行模型中引入新的并发保证。也就是说,不保证设备上任意数量的不同线程块之间会并发执行。
父网格及其子网格之间同样没有并发保证。当父网格启动子网格时,只要流依赖关系得到满足且硬件资源可用,子网格就可能开始执行,但在父网格到达隐式同步点之前,不保证子网格会开始执行。
并发性可能随设备配置、应用程序工作负载以及运行时调度而变化。因此,依赖不同线程块之间的任何并发性都是不安全的。
4.20.3. 内存相干性与一致性
父网格和子网格共享相同的全局内存和常量内存存储,但各自拥有不同的局部内存和共享内存。下表列出了哪些内存空间允许父网格和子网格通过相同的指针访问。子网格绝不能访问父网格的局部内存或共享内存,父网格也不能访问子网格的局部内存或共享内存。
内存空间 |
父网格/子网格是否使用相同的指针? |
|---|---|
全局内存 |
是 |
映射内存 |
是 |
局部内存 |
否 |
共享内存 |
否 |
纹理内存 |
是(只读) |
4.20.3.1. 全局内存
父网格和子网格对全局内存的访问具有相干性,而子网格与父网格之间只有弱一致性保证。在子网格的执行过程中,只有一个时间点,其内存视图与父线程完全一致:即父线程调用子网格的时刻。
父线程在调用子网格之前执行的所有全局内存操作对子网格都是可见的。随着cudaDeviceSynchronize()被移除,已无法从父网格访问子网格中线程所做的修改。在父网格退出之前,访问子网格中线程所做修改的唯一方法是通过启动到cudaStreamTailLaunch流中的核函数。
在以下示例中,执行child_launch的子网格仅保证能够看到在子网格启动之前对data所做的修改。由于启动由父网格的线程 0 执行,子网格的内存视图将与父网格的线程 0 所见的内存一致。由于第一次__syncthreads()调用,子网格将看到data[0]=0、data[1]=1、…、data[255]=255(如果没有__syncthreads()调用,则仅保证子网格能够看到data[0]=0)。仅保证子网格在隐式同步时返回。这意味着,永远不保证子网格中线程所做的修改可供父网格访问。为了访问child_launch所做的修改,会将一个tail_launch核函数启动到cudaStreamTailLaunch流中。
__global__ void tail_launch(int *data) {
   data[threadIdx.x] = data[threadIdx.x]+1;
}

__global__ void child_launch(int *data) {
   data[threadIdx.x] = data[threadIdx.x]+1;
}

__global__ void parent_launch(int *data) {
   data[threadIdx.x] = threadIdx.x;

   __syncthreads();

   if (threadIdx.x == 0) {
       child_launch<<< 1, 256 >>>(data);
       tail_launch<<< 1, 256, 0, cudaStreamTailLaunch >>>(data);
   }
}

void host_launch(int *data) {
    parent_launch<<< 1, 256 >>>(data);
}
4.20.3.2. 映射内存
映射的系统内存具有与全局内存完全相同的相干性和一致性保证,并遵循上文详述的语义。核函数不能分配或释放映射内存,但可以使用从主机程序传入的指向映射内存的指针。
4.20.3.4. 局部内存
局部内存是执行中线程的私有存储,在该线程之外不可见。启动子核函数时,将指向局部内存的指针作为启动参数传递是非法的。从子网格中解引用这样的局部内存指针,其结果未定义。
例如,以下代码是非法的,如果child_launch访问x_array,则行为未定义:
int x_array[10];       // Creates x_array in parent's local memory
child_launch<<< 1, 1 >>>(x_array);
程序员有时很难知道编译器何时将变量放入局部内存。一般而言,传递给子核函数的所有存储都应从全局内存堆中显式分配,方法是使用cudaMalloc()、new(),或者在全局作用域中声明__device__存储。例如:
// Correct - "value" is global storage
__device__ int value;
__device__ void x() {
    value = 5;
    child<<< 1, 1 >>>(&value);
}
// Invalid - "value" is local storage
__device__ void y() {
    int value = 5;
    child<<< 1, 1 >>>(&value);
}
4.20.3.4.1. 纹理内存
对纹理所映射到的全局内存区域的写入,相对于纹理访问而言不具有相干性。在调用子网格时以及子网格完成时,会强制保证纹理内存的相干性。这意味着,子核函数启动之前对内存的写入会反映在子核函数的纹理内存访问中。与上文的全局内存类似,永远不保证子网格对内存的写入会反映在父网格的纹理内存访问中。在父网格退出之前,访问子网格中线程所做修改的唯一方法是通过启动到cudaStreamTailLaunch流中的核函数。父网格和子网格的并发访问可能导致数据不一致。
4.20.4. 编程接口
4.20.4.1. 基础
以下示例展示了一个使用动态并行的简单你好,世界程序:
#include <stdio.h>

__global__ void childKernel()
{
    printf("Hello ");
}

__global__ void tailKernel()
{
    printf("World!\n");
}

__global__ void parentKernel()
{
    // launch child
    childKernel<<<1,1>>>();
    if (cudaSuccess != cudaGetLastError()) {
        return;
    }

    // launch tail into cudaStreamTailLaunch stream
    // implicitly synchronizes: waits for child to complete
    tailKernel<<<1,1,0,cudaStreamTailLaunch>>>();

}

int main(int argc, char *argv[])
{
    // launch parent
    parentKernel<<<1,1>>>();
    if (cudaSuccess != cudaGetLastError()) {
        return 1;
    }

    // wait for parent to complete
    if (cudaSuccess != cudaDeviceSynchronize()) {
        return 2;
    }

    return 0;
}
可以通过命令行一步构建此程序,如下所示:
$ nvcc -arch=sm_75 -rdc=true hello_world.cu -o hello -lcudadevrt
4.20.4.2. CDP 的 C++ 语言接口
使用 CUDA C++ 实现动态并行的 CUDA 核函数所能使用的语言接口和 API 称为CUDA 设备运行时。
为便于复用可能运行于主机环境或设备环境中的例程的代码,尽可能保留了 CUDA 运行时 API 的语法和语义。
与 CUDA C++ 中的所有代码一样,此处概述的 API 和代码都是逐线程代码。这使每个线程能够独立地动态决定接下来执行哪个核函数或操作。执行所提供的任何设备运行时 API 时,都不要求线程块内的线程之间进行同步,因此可以在具有任意分歧的核函数代码中调用设备运行时 API 函数,而不会发生死锁。
4.20.4.2.1. 设备端核函数启动
可以使用标准 CUDA <<< >>> 语法从设备端启动核函数:
kernel_name<<< Dg, Db, Ns, S >>>([kernel arguments]);
Dg的类型为dim3,用于指定网格的维度和大小Db的类型为dim3,用于指定每个线程块的维度和大小Ns的类型为size_t,用于指定在此次调用中,除静态分配的内存之外,为每个线程块动态分配的共享内存字节数。Ns是可选参数,默认值为 0。S的类型为cudaStream_t,用于指定与此次调用关联的流。该流必须在发起此次调用的同一网格中分配。S是可选参数,默认为 NULL 流。
4.20.4.2.1.1. 启动是异步的
与主机端启动相同,所有设备端核函数启动相对于发起启动的线程都是异步的。也就是说,<<<>>>启动命令会立即返回,发起启动的线程会继续执行,直到到达隐式启动同步点,例如启动到cudaStreamTailLaunch流中的核函数处(尾部启动流)。子网格可能在启动后的任何时刻开始执行,但在发起启动的线程到达隐式启动同步点之前,不能保证子网格会开始执行。
与主机端启动类似,启动到不同流中的工作可能并发运行,但不保证实际发生并发。CUDA 编程模型不支持依赖子核函数之间并发执行的程序,此类程序将具有未定义的行为。
4.20.4.2.1.2. 启动环境配置
所有全局设备配置设置(例如,cudaDeviceGetCacheConfig()返回的共享内存和 L1 缓存大小,以及cudaDeviceGetLimit()返回的设备限制)都将从父级继承。同样,栈大小等设备限制也将保持配置的值。
对于由主机启动的核函数,从主机设置的逐核函数配置将优先于全局设置。从设备启动核函数时,也将使用这些配置。无法从设备重新配置核函数的环境。
4.20.4.2.2. 事件
仅支持 CUDA 事件的流间同步功能。这意味着支持cudaStreamWaitEvent(),但不支持cudaEventSynchronize()、cudaEventElapsedTime()和cudaEventQuery()。由于不支持cudaEventElapsedTime(),必须通过cudaEventCreateWithFlags()创建 cudaEvents,并传入cudaEventDisableTiming标志。
与流一样,事件对象可以在创建它们的网格内的所有线程之间共享,但它们仅限于该网格,不能传递给其他核函数。不保证事件句柄在不同网格之间是唯一的,因此,在未创建某个事件句柄的网格内使用该句柄将导致未定义的行为。
4.20.4.2.3. 同步
如果调用线程打算与其他线程调用的子网格同步,则程序应自行执行充分的线程间同步,例如通过 CUDA 事件。
由于无法从父线程显式同步子工作,因此无法保证子网格中发生的更改对父网格内的线程可见。
4.20.4.2.4. 设备管理
核函数只能控制其正在运行的设备。这意味着设备运行时不支持cudaSetDevice()等设备 API。从 GPU 看到的活动设备(由cudaGetDevice()返回)的设备编号与从主机系统看到的相同。cudaDeviceGetAttribute()调用可以请求有关其他设备的信息,因为此 API 允许将设备 ID 指定为调用的参数。注意,设备运行时不提供可获取所有属性的cudaGetDeviceProperties()API,必须逐个查询属性。
4.20.5. 编程指南
4.20.5.1. 性能
4.20.5.1.1. 启用动态并行的核函数开销
控制动态启动时处于活动状态的系统软件可能会给当时正在运行的任何核函数带来开销,无论该核函数自身是否发起核函数启动。此开销来自设备运行时的执行跟踪和管理软件,并且可能导致性能下降。一般而言,链接设备运行时库的应用程序会产生此开销。
4.20.5.2. 实现的约束与限制
动态并行保证本文档中描述的所有语义,但是,某些硬件和软件资源取决于实现,并会限制使用设备运行时的程序的规模、性能和其他特性。
4.20.5.2.1. 运行时
4.20.5.2.1.1. 内存占用
设备运行时系统软件会为各种管理用途预留内存,尤其会为跟踪待处理的网格启动预留内存。可以通过配置控制来减小这部分预留内存的大小,代价是受到某些启动限制。有关详细信息,请参阅下文的配置选项。
4.20.5.2.1.2. 待处理的核函数启动
启动核函数时,会跟踪所有关联的配置和参数数据,直到核函数完成。这些数据存储在系统管理的启动池中。
可以通过从主机调用cudaDeviceSetLimit()并指定cudaLimitDevRuntimePendingLaunchCount,来配置固定大小启动池的大小。
4.20.5.3. 兼容性与互操作性
默认使用 CDP2。可以使用-DCUDA_FORCE_CDP1_IF_SUPPORTED编译函数,以便在计算能力低于 9.0 的设备上选择不使用 CDP2。
使用 CUDA 12.0 及更新版本编译的函数(默认) |
使用 CUDA 12.0 之前的版本编译的函数,或使用 CUDA 12.0 及更新版本并指定 |
|
|---|---|---|
编译 |
如果设备代码引用 |
如果代码引用 |
计算能力 < 9.0 |
使用新接口。 |
使用旧接口。 |
计算能力为 9.0 及更高 |
使用新接口。 |
使用新接口。如果函数在设备代码中引用 |
使用 CDP1 和 CDP2 的函数可以在同一上下文中同时加载和运行。CDP1 函数能够使用 CDP1 特有的功能(例如cudaDeviceSynchronize),而 CDP2 函数能够使用 CDP2 特有的功能(例如尾部启动和即发即弃启动)。
使用 CDP1 的函数不能启动使用 CDP2 的函数,反之亦然。如果一个将使用 CDP1 的函数的调用图中包含将使用 CDP2 的函数,或者情况相反,则函数加载期间会产生cudaErrorCdpVersionMismatch。
本文档不包含旧版 CDP1 的行为。有关 CDP1 的信息,请参阅旧版 CUDA 编程指南
4.20.6. 从 PTX 进行设备端启动
前面几节讨论了使用CUDA 设备运行时实现动态并行。也可以从 PTX 执行动态并行。对于以并行线程执行(PTX)为目标并计划在其语言中支持动态并行的编程语言和编译器实现者,本节提供了在 PTX 层面支持核函数启动的相关底层细节。
4.20.6.1. 核函数启动 API
可以使用以下两个可从 PTX 访问的 API 实现设备端核函数启动:cudaLaunchDevice()和cudaGetParameterBuffer()。cudaLaunchDevice()使用参数缓冲区启动指定的核函数,该缓冲区通过调用cudaGetParameterBuffer()获得,并填入传递给所启动核函数的参数。如果所启动的核函数不接受任何参数,则参数缓冲区可以为 NULL,即无需调用cudaGetParameterBuffer()。
4.20.6.1.1. cudaLaunchDevice
在 PTX 层面,使用cudaLaunchDevice()之前,需要以下面所示的两种形式之一声明它。
// PTX-level Declaration of cudaLaunchDevice() when .address_size is 64
.extern .func(.param .b32 func_retval0) cudaLaunchDevice
(
  .param .b64 func,
  .param .b64 parameterBuffer,
  .param .align 4 .b8 gridDimension[12],
  .param .align 4 .b8 blockDimension[12],
  .param .b32 sharedMemSize,
  .param .b64 stream
)
;
下面的 CUDA 层面声明映射到前述 PTX 层面声明之一,可以在系统头文件cuda_device_runtime_api.h中找到它。该函数定义在cudadevrt系统库中,程序必须链接此库才能使用设备端核函数启动功能。
// CUDA-level declaration of cudaLaunchDevice()
extern "C" __device__
cudaError_t cudaLaunchDevice(void *func, void *parameterBuffer,
                             dim3 gridDimension, dim3 blockDimension,
                             unsigned int sharedMemSize,
                             cudaStream_t stream);
第一个参数是指向要启动的核函数的指针,第二个参数是参数缓冲区,其中保存传递给所启动核函数的实际参数。参数缓冲区的布局在下文的参数缓冲区布局中进行说明。其他参数指定启动配置,即网格维度、线程块维度、共享内存大小以及与启动关联的流(有关启动配置的详细说明,请参阅核函数配置。
4.20.6.1.2. cudaGetParameterBuffer
使用cudaGetParameterBuffer()之前,需要在 PTX 层面声明它。根据地址大小,PTX 层面的声明必须采用下面给出的两种形式之一:
// PTX-level Declaration of cudaGetParameterBuffer() when .address_size is 64
.extern .func(.param .b64 func_retval0) cudaGetParameterBuffer
(
  .param .b64 alignment,
  .param .b64 size
)
;
以下cudaGetParameterBuffer()的 CUDA 层面声明映射到前述 PTX 层面声明:
// CUDA-level Declaration of cudaGetParameterBuffer()
extern "C" __device__
void *cudaGetParameterBuffer(size_t alignment, size_t size);
第一个参数指定参数缓冲区的对齐要求,第二个参数指定大小要求,单位为字节。在当前实现中,始终保证cudaGetParameterBuffer()返回的参数缓冲区按 64 字节对齐,并且会忽略对齐要求参数。不过,建议向cudaGetParameterBuffer()传递正确的对齐要求值,即要放入参数缓冲区的所有参数中最大的对齐值,以确保将来的可移植性。
4.20.6.2. 参数缓冲区布局
禁止对参数缓冲区中的参数重新排序,并且放入参数缓冲区的每个参数都必须对齐。也就是说,每个参数必须放在参数缓冲区中的第n个字节处,其中n是参数大小的倍数中大于前一个参数所占用的最后一个字节偏移量的最小者。参数缓冲区的最大大小为 4KB。
有关 CUDA 编译器生成的 PTX 代码的更详细说明,请参阅 PTX-3.5 规范。