4.17. 虚拟内存管理
在 CUDA 编程模型中,内存分配调用(例如cudaMalloc())返回 GPU 内存中的一个内存地址。该地址可用于任何 CUDA API,也可用于设备核函数内部。开发者可以使用cudaEnablePeerAccess启用对等设备对这些内存分配的访问。这样,不同设备上的核函数就可以访问相同的数据。但是,所有过去和未来的用户分配也都会映射到目标对等设备。这可能导致用户无意中承担将所有cudaMalloc分配的内存映射到对等设备的运行时开销。在大多数情况下,应用程序只需与另一台设备共享少量内存分配即可进行通信。通常没有必要将所有内存分配映射到所有设备。此外,将这种方法扩展到多节点环境本身就存在困难。
CUDA 提供了虚拟内存管理(VMM)API,使开发者能够对这一过程进行显式的底层控制。
虚拟内存分配是由操作系统和内存管理单元(MMU)管理的复杂过程,分为两个关键阶段。首先,操作系统为程序保留一段连续的虚拟地址范围,而不分配任何物理内存。然后,当程序首次尝试使用该内存时,操作系统提交这些虚拟地址,根据需要为虚拟页分配物理存储。
CUDA 的 VMM API 允许开发者显式保留虚拟地址范围,然后再将其映射到物理 GPU 内存,从而将类似的概念引入 GPU 内存管理。借助 VMM,应用程序可以明确选择允许其他设备访问的某些内存分配。
VMM API 使复杂应用程序能够更高效地管理多个 GPU(以及 CPU 核心)上的内存。通过支持对内存保留、映射和访问权限进行手动控制,VMM API 可以实现细粒度数据共享、零拷贝传输和自定义内存分配器等高级技术。CUDA VMM API 向用户提供了细粒度控制能力,用于管理应用程序中的 GPU 内存。
开发者可以通过以下几个关键方面受益于 VMM API:
对虚拟内存和物理内存管理进行细粒度控制,允许分配不连续的物理内存块,并将它们映射到连续的虚拟地址空间。这有助于减少 GPU 内存碎片并提高内存利用率,尤其适用于深度神经网络训练等大型工作负载。
将虚拟地址空间的保留与物理内存分配分离,实现高效的内存分配和释放。开发者可以保留较大的虚拟内存区域,并按需映射物理内存,无需进行代价高昂的内存复制或重新分配,从而提高动态数据结构和可变大小内存分配的性能。
能够动态扩展 GPU 内存分配,而无需复制所有数据并为其重新分配内存,类似于 CPU 内存管理中
realloc或std::vector的工作方式。这支持更灵活、更高效的 GPU 内存使用模式。通过提供底层 API 来提高开发者的生产力和应用程序性能,这些 API 允许构建复杂的内存分配器和缓存管理系统,例如动态管理大型语言模型中的键值缓存,从而改善吞吐量和延迟。
CUDA VMM API 在分布式多 GPU 环境中具有很高的价值,因为它能够实现多个 GPU 之间高效的内存共享和访问。通过将虚拟地址与物理内存解耦,该 API 允许开发者创建统一的虚拟地址空间,其中的数据可以动态映射到不同的 GPU。这可以优化内存使用并减少数据传输开销。例如,NVIDIA 的 NCCL 和 NVSHMEM 等库就在积极使用 VMM。
总之,CUDA VMM API 为开发者提供了超越传统类 malloc 抽象的高级工具,以实现精细调节、高效、灵活且可扩展的 GPU 内存管理,这对于高性能和大内存应用程序至关重要
注意
本节所述的一组 API 要求系统支持 UVA。请参见虚拟内存管理 API。
4.17.1. 预备知识
4.17.1.1. 定义
互连网络内存:互连网络内存是指可以通过 NVIDIA 的 NVLink 和 NVSwitch 等高速互连网络(fabric)访问的内存。该互连网络在多个 GPU 或节点之间提供内存相干性和高带宽通信层,使它们能够高效地共享内存,就好像内存连接到统一的互连网络,而不是隔离在各个设备上一样。
CUDA 12.4 及更高版本具有 VMM 分配句柄类型CU_MEM_HANDLE_TYPE_FABRIC。在受支持的平台上,并且在 NVIDIA IMEX 守护进程正在运行的前提下,这种分配句柄类型不仅能够通过任意通信机制(例如 MPI)在节点内共享内存分配,还能够在节点间共享内存分配。这使多节点 NVLink 系统中的 GPU 能够映射属于同一 NVLink 互连网络的所有其他 GPU 的内存,即使它们位于不同节点上也是如此。
注意
此处描述的互连网络内存是以地址为中心的:对等设备的物理内存映射到本地虚拟地址空间中,并通过普通的加载和存储进行访问。计算互连传输在同一 NVLink 互连网络上提供了一种互补的以资源为中心的模型,它针对命名的逻辑端点而不是映射的地址,使用异步 put、get 和归约操作移动数据。它会为每个操作报告显式的完成状态,因此适用于需要关注互连网络错误恢复的大型互连网络。
内存句柄:在 VMM 中,句柄是代表物理内存分配的不透明标识符。这些句柄是底层 CUDA VMM API 中内存管理的核心。它们支持对可映射到虚拟地址空间的物理内存对象进行灵活控制。一个句柄唯一标识一项物理内存分配。句柄充当对内存资源的抽象引用,而不暴露直接指针。句柄允许执行跨进程或设备导出和导入内存等操作,从而促进内存共享和虚拟化。
IMEX 通道:IMEX 这一名称代表节点间内存交换,它是 NVIDIA 跨不同节点进行 GPU 到 GPU 通信的解决方案的一部分。IMEX 通道是一项 GPU 驱动程序功能,可在 IMEX 域内的多用户或多节点环境中提供基于用户的内存隔离。IMEX 通道充当一种安全与隔离机制。
IMEX 通道与互连网络句柄直接相关,必须在多节点 GPU 通信中启用。当一个 GPU 分配了内存,并希望另一节点上的 GPU 能够访问这块内存时,它首先需要导出该内存的句柄。在此导出过程中,IMEX 通道用于生成安全的互连网络句柄,只有具备正确通道访问权限的远程进程才能导入该句柄。
单播内存访问:在 VMM API 的上下文中,单播内存访问是指由特定设备或进程将物理内存受控地直接映射到唯一的虚拟地址范围并进行访问。单播内存访问并非将访问广播到多个设备,而是向某个特定 GPU 设备显式授予对某个保留虚拟地址范围的读写权限,该范围映射到一项物理内存分配。
多播内存访问:在 VMM API 的上下文中,多播内存访问是指使用多播机制,将单个物理内存分配或区域同时映射到多个设备的虚拟地址空间的能力。这使数据能够以一对多的方式在多个 GPU 之间高效共享,减少冗余数据传输并提高通信效率。NVIDIA 的 CUDA VMM API 支持创建多播对象,将来自多个设备的物理内存分配绑定在一起。
4.17.1.2. 查询支持情况
应用程序应在尝试使用功能之前查询是否支持这些功能,因为它们的可用性可能因 GPU 架构、驱动程序版本以及所使用的特定软件库而异。以下各节详细说明如何以编程方式检查所需的支持情况。
VMM 支持在尝试使用 VMM API 之前,应用程序必须确保要使用的设备支持 CUDA 虚拟内存管理。以下代码示例展示了如何查询 VMM 支持情况:
int deviceSupportsVmm;
CUresult result = cuDeviceGetAttribute(&deviceSupportsVmm, CU_DEVICE_ATTRIBUTE_VIRTUAL_MEMORY_MANAGEMENT_SUPPORTED, device);
if (deviceSupportsVmm != 0) {
    // `device` supports Virtual Memory Management
}
互连网络内存支持:在尝试使用互连网络内存之前,应用程序必须确保要使用的设备支持互连网络内存。以下代码示例展示了如何查询互连网络内存支持情况:
int deviceSupportsFabricMem;
CUresult result = cuDeviceGetAttribute(&deviceSupportsFabricMem, CU_DEVICE_ATTRIBUTE_HANDLE_TYPE_FABRIC_SUPPORTED, device);
if (deviceSupportsFabricMem != 0) {
    // `device` supports Fabric Memory
}
除了使用CU_MEM_HANDLE_TYPE_FABRIC作为句柄类型,以及无需使用操作系统原生进程间通信机制来交换可共享句柄之外,使用互连网络内存与使用其他分配句柄类型没有区别。
IMEX 通道支持在 IMEX 域内,IMEX 通道能够在多用户环境中实现安全的内存共享。NVIDIA 驱动程序通过创建字符设备nvidia-caps-imex-channels来实现这一点。要使用基于互连网络句柄的共享,用户应验证两件事:
首先,应用程序必须验证/proc/devices下存在此设备:
# cat /proc/devices | grep nvidia
195 nvidia
195 nvidiactl
234 nvidia-caps-imex-channels
509 nvidia-nvswitch

The nvidia-caps-imex-channels device should have a major number (e.g., 234).
其次,要让两个 CUDA 进程(一个导出方和一个导入方)共享内存,它们都必须有权访问同一个 IMEX 通道文件。这些文件(例如/dev/nvidia-caps-imex-channels/channel0)是代表各个 IMEX 通道的节点。系统管理员必须创建这些文件,例如使用mknod()命令。
# mknod /dev/nvidia-caps-imex-channels/channelN c <major_number> 0

This command creates channelN using the major number obtained from
/proc/devices.
注意
默认情况下,如果指定了NVreg_CreateImexChannel0模块参数,驱动程序可以创建 channel0。
多播对象支持:在尝试使用多播对象之前,应用程序必须确保要使用的设备支持这些对象。以下代码示例展示了如何查询多播对象支持情况:
int deviceSupportsMultiCast;
CUresult result = cuDeviceGetAttribute(&deviceSupportsMultiCast, CU_DEVICE_ATTRIBUTE_MULTICAST_SUPPORTED, device);
if (deviceSupportsMultiCast != 0) {
    // `device` supports Multicast Objects
}
4.17.2. API 概述
VMM API 为开发者提供了对虚拟内存管理的细粒度控制。VMM 是一种非常底层的 API,要求直接使用CUDA Driver API。这一用途广泛的 API 既可以用于单节点环境,也可以用于多节点环境。
要有效使用 VMM,开发者必须牢固掌握内存管理中的几个关键概念:
了解操作系统虚拟内存的基础知识,包括它如何处理页和地址空间
必须了解内存层次结构和硬件特性
熟悉进程间通信(IPC)方法,例如套接字或消息传递,
具备有关内存访问权限安全性的基础知识
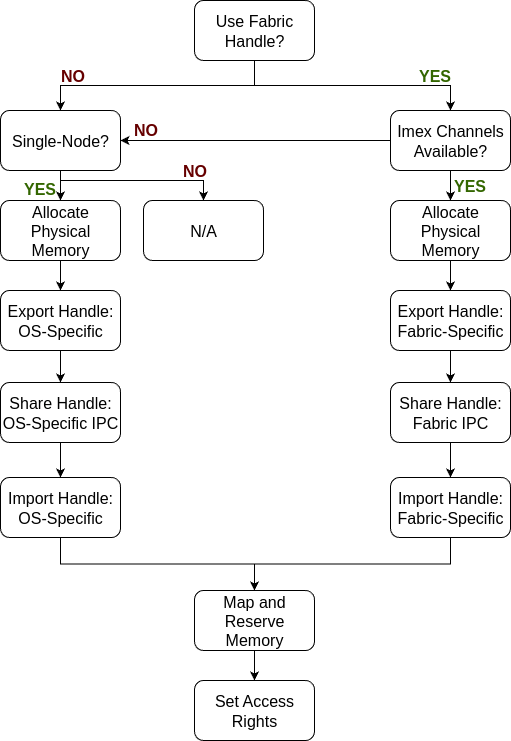
图 55 VMM 使用概览。此图概述了使用 VMM 所需的一系列步骤。该过程首先评估环境配置。根据此评估,用户必须作出一个关键的初始决策:是使用互连网络(fabric)内存句柄,还是使用特定于操作系统的句柄。根据最初选择的句柄,必须执行不同的一系列后续步骤。但是,无论选择哪种类型的句柄,最后的内存管理操作都是相同的,具体包括映射、预留以及设置所分配内存的访问权限。
图内文字中文对照
Single-Node?- 是否为单节点?
YES- 是
NO- 否
Use Fabric Handle?- 是否使用互连网络句柄?
Imex Channels Available?- Imex 通道是否可用?
N/A- 不适用
Allocate Physical Memory- 分配物理内存
Export Handle: OS-Specific- 导出句柄:操作系统专用
Share Handle: OS-Specific IPC- 共享句柄:操作系统专用 IPC
Import Handle: OS-Specific- 导入句柄:操作系统专用
Export Handle: Fabric-Specific- 导出句柄:互连网络专用
Share Handle: Fabric IPC- 共享句柄:互连网络 IPC
Import Handle: Fabric-Specific- 导入句柄:互连网络专用
Map and Reserve Memory- 映射并预留内存
Set Access Rights- 设置访问权限
VMM API 的工作流程包含一系列内存管理步骤,重点是在不同设备或进程之间共享内存。首先,开发者必须在源设备上分配物理内存。为便于共享,VMM API 使用句柄向目标设备或进程传递必要的信息。用户必须导出一个用于共享的句柄,该句柄可以是特定于操作系统的句柄,也可以是特定于互连网络(fabric)的句柄。特定于操作系统的句柄仅限于单个节点上的进程间通信,而特定于互连网络(fabric)的句柄用途更加广泛,既可用于单节点环境,也可用于多节点环境。需要注意的是,使用特定于互连网络(fabric)的句柄需要启用 IMEX 通道。
句柄导出后,必须使用进程间通信协议将其共享给一个或多个接收进程,具体方法由开发者选择。然后,接收进程使用 VMM API 导入句柄。在句柄成功导出、共享和导入后,源进程和目标进程都必须预留虚拟地址空间,以便将所分配的物理内存映射到该空间。最后一步是为每个设备设置内存访问权限,确保建立适当的权限。附图进一步详细说明了整个过程,包括两种句柄方案。
4.17.3. 单播内存共享
GPU 内存共享可以在一台具有多个 GPU 的机器上进行,也可以跨联网的多台机器进行。该过程遵循以下步骤:
分配和导出:一个 GPU 上的 CUDA 程序分配内存,并获取该内存的可共享句柄。
共享和导入:随后使用 IPC、MPI 或 NCCL 等将句柄发送给节点上的其他程序。在接收端 GPU 中,CUDA 驱动程序导入句柄并创建所需的内存对象。
预留和映射:驱动程序创建从程序的虚拟地址(VA)到 GPU 的物理地址(PA),再到其互连网络(fabric)地址(FA)的映射。
访问权限:为分配设置访问权限。
释放内存:在程序结束执行时释放所有分配。
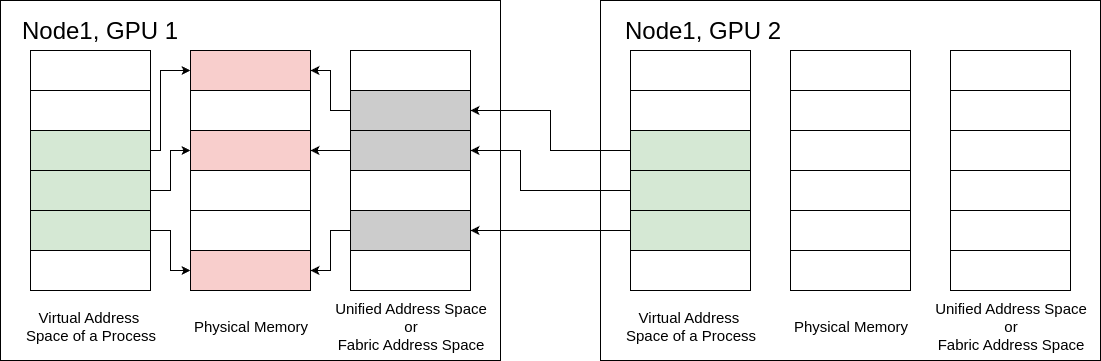
图 56 单播内存共享示例
图内文字中文对照
Node1, GPU 1- 节点 1,GPU 1
Node1, GPU 2- 节点 1,GPU 2
Virtual Address Space of a Process- 进程的虚拟地址空间
Physical Memory- 物理内存
Unified Address Space or Fabric Address Space- 统一地址空间或互连网络地址空间
4.17.3.1. 分配和导出
分配物理内存使用虚拟内存管理 API 分配内存的第一步是创建一个物理内存块,为该分配提供后备存储。要分配物理内存,应用程序必须使用cuMemCreate API。此函数创建的分配没有任何设备或主机映射。函数参数CUmemGenericAllocationHandle描述了要分配的内存的属性,例如分配的位置、该分配是否将共享给另一个进程(或图形 API),或者要分配的内存的物理属性。用户必须确保请求的分配大小按适当的粒度对齐。可以使用cuMemGetAllocationGranularity查询有关分配粒度要求的信息。
CUmemGenericAllocationHandle allocatePhysicalMemory(int device, size_t size) {
    CUmemAllocationHandleType handleType = CU_MEM_HANDLE_TYPE_POSIX_FILE_DESCRIPTOR;
    CUmemAllocationProp prop = {};
    prop.type = CU_MEM_ALLOCATION_TYPE_PINNED;
    prop.location.type = CU_MEM_LOCATION_TYPE_DEVICE;
    prop.location.id = device;
    prop.requestedHandleType = handleType;

    size_t granularity = 0;
    cuMemGetAllocationGranularity(&granularity, &prop, CU_MEM_ALLOC_GRANULARITY_MINIMUM);

    // Ensure size matches granularity requirements for the allocation
    size_t padded_size = ROUND_UP(size, granularity);

    // Allocate physical memory
    CUmemGenericAllocationHandle allocHandle;
    cuMemCreate(&allocHandle, padded_size, &prop, 0);

    return allocHandle;
}
CUmemGenericAllocationHandle allocatePhysicalMemory(int device, size_t size) {
    CUmemAllocationHandleType handleType = CU_MEM_HANDLE_TYPE_FABRIC;
    CUmemAllocationProp prop = {};
    prop.type = CU_MEM_ALLOCATION_TYPE_PINNED;
    prop.location.type = CU_MEM_LOCATION_TYPE_DEVICE;
    prop.location.id = device;
    prop.requestedHandleType = handleType;

    size_t granularity = 0;
    cuMemGetAllocationGranularity(&granularity, &prop, CU_MEM_ALLOC_GRANULARITY_MINIMUM);

    // Ensure size matches granularity requirements for the allocation
    size_t padded_size = ROUND_UP(size, granularity);

    // Allocate physical memory
    CUmemGenericAllocationHandle allocHandle;
    cuMemCreate(&allocHandle, padded_size, &prop, 0);

    return allocHandle;
}
注意
由cuMemCreate分配的内存通过其返回的CUmemGenericAllocationHandle引用。请注意,此引用不是指针,并且其内存尚不可访问。
注意
可以使用cuMemGetAllocationPropertiesFromHandle查询分配句柄的属性。
在局部性域中分配设备内存
要在特定局部性域中分配设备内存,请将CUmemAllocationProp::location.type设置为CU_MEM_LOCATION_TYPE_DEVICE_LOCALITY_DOMAIN。设置CUmemAllocationProp::location.localized的两个成员:deviceId标识 GPU,localityDomainId标识该 GPU 上的有效局部性域。使用cuDeviceGetAttribute和CU_DEVICE_ATTRIBUTE_LOCALITY_DOMAIN_COUNT查询有效局部性域的数量。
分配大小必须是针对局部化分配属性返回的最小粒度的倍数:
CUmemAllocationProp prop {};
prop.type = CU_MEM_ALLOCATION_TYPE_PINNED;
prop.location.type = CU_MEM_LOCATION_TYPE_DEVICE_LOCALITY_DOMAIN;
prop.location.localized.deviceId = device;
prop.location.localized.localityDomainId = localityDomainId;

size_t granularity = 0;
cuMemGetAllocationGranularity(&granularity, &prop, CU_MEM_ALLOC_GRANULARITY_MINIMUM);
size_t alignedSize = ((size + granularity - 1) / granularity) * granularity;

CUmemGenericAllocationHandle allocationHandle {};
cuMemCreate(&allocationHandle, alignedSize, &prop, 0);
返回的句柄与其他 VMM 分配使用相同的预留、映射、访问控制和释放 API。
在只有一个局部性域的设备上,请求局部性域 0 等效于使用CU_MEM_LOCATION_TYPE_DEVICE创建的全设备分配;所得到的分配将其位置类型报告为CU_MEM_LOCATION_TYPE_DEVICE。
有关整体编程模型,请参阅局部性域。
CUmemAllocationHandleType handleType = CU_MEM_HANDLE_TYPE_POSIX_FILE_DESCRIPTOR;
CUmemGenericAllocationHandle handle = allocatePhysicalMemory(0, 1<<21);
int fd;
cuMemExportToShareableHandle(&fd, handle, handleType, 0);
CUmemAllocationHandleType handleType = CU_MEM_HANDLE_TYPE_FABRIC;
CUmemGenericAllocationHandle handle = allocatePhysicalMemory(0, 1<<21);
CUmemFabricHandle fh;
cuMemExportToShareableHandle(&fh, handle, handleType, 0);
注意
特定于操作系统的句柄要求所有进程都属于同一个操作系统。
注意
特定于互连网络(fabric)的句柄要求系统管理员启用 IMEX 通道。
memMapIpcDrv示例可作为对 VMM 分配使用 IPC 的示例。
4.17.3.3. 预留和映射
预留虚拟地址范围
由于 VMM 中地址和内存是不同的概念,应用程序必须划出一个地址范围,以容纳由cuMemCreate进行的内存分配。预留的地址范围必须至少与用户计划放入其中的所有物理内存分配的大小之和一样大。
应用程序可以通过向cuMemAddressReserve传递适当的参数来预留虚拟地址范围。获得的地址范围不会与任何设备或主机物理内存关联。预留的虚拟地址范围可以映射到属于系统中任何设备的内存块,从而为应用程序提供一个连续的 VA 范围,该范围由属于不同设备的内存提供后备存储并与其建立映射。应用程序应使用cuMemAddressFree将虚拟地址范围归还给 CUDA。用户必须确保在调用cuMemAddressFree之前已解除整个 VA 范围的映射。这些函数在概念上类似于 Linux 上的mmap和munmap,或 Windows 上的VirtualAlloc和VirtualFree。以下代码片段展示了该函数的用法:
CUdeviceptr ptr;
// `ptr` holds the returned start of virtual address range reserved.
CUresult result = cuMemAddressReserve(&ptr, size, 0, 0, 0); // alignment = 0 for default alignment
映射内存
前两节中分配的物理内存和划出的虚拟地址空间体现了 VMM API 引入的内存与地址之间的区别。要使分配的内存可用,用户必须将内存映射到地址空间。必须使用cuMemMap将从cuMemAddressReserve获得的地址范围与从cuMemCreate或cuMemImportFromShareableHandle获得的物理分配相互关联。
只要划出了足够的地址空间,用户就可以将来自多个设备的分配关联到连续的虚拟地址范围中。要解除物理分配与地址范围之间的关联,用户必须使用cuMemUnmap解除该映射地址的映射。用户可以根据需要,将内存映射到同一个地址范围并解除映射任意多次,只要确保不尝试在已映射的预留 VA 范围上创建映射即可。以下代码片段展示了该函数的用法:
CUdeviceptr ptr;
// `ptr`: address in the address range previously reserved by cuMemAddressReserve.
// `allocHandle`: CUmemGenericAllocationHandle obtained by a previous call to cuMemCreate.
CUresult result = cuMemMap(ptr, size, 0, allocHandle, 0);
4.17.3.4. 访问权限
CUDA 的虚拟内存管理 API 使应用程序能够通过访问控制机制显式保护其 VA 范围。使用cuMemMap将分配映射到地址范围中的某个区域并不会使该地址变得可访问,如果 CUDA 核函数访问该地址,则会导致程序崩溃。用户必须在源设备和执行访问的设备上使用cuMemSetAccess函数专门选择访问控制。这会允许或限制特定设备对已映射地址范围的访问。以下代码片段展示了该函数的用法:
void setAccessOnDevice(int device, CUdeviceptr ptr, size_t size) {
    CUmemAccessDesc accessDesc = {};
    accessDesc.location.type = CU_MEM_LOCATION_TYPE_DEVICE;
    accessDesc.location.id = device;
    accessDesc.flags = CU_MEM_ACCESS_FLAGS_PROT_READWRITE;

    // Make the address accessible
    cuMemSetAccess(ptr, size, &accessDesc, 1);
}
VMM 提供的访问控制机制允许用户明确指定要与系统上其他对等设备共享哪些分配。如前所述,cudaEnablePeerAccess会强制将之前和之后使用cudaMalloc进行的所有分配映射到目标对等设备。在许多情况下,这很方便,因为用户不必担心跟踪每个分配到系统中每个设备的映射状态。但是,这种方法会影响性能。通过以分配为粒度的访问控制,VMM 允许以最小的开销建立对等映射。
vectorAddMMAP示例可作为使用虚拟内存管理 API 的示例。
4.17.3.5. 释放内存
要释放分配的内存和地址空间,源进程和目标进程都应依次使用cuMemUnmap、cuMemRelease和cuMemAddressFree函数。cuMemUnmap函数从地址范围中解除先前映射的内存区域的映射,从而有效地将物理内存与预留的虚拟地址空间分离。接下来,cuMemRelease释放先前创建的物理内存,将其归还给系统。最后,cuMemAddressFree释放先前预留的虚拟地址范围,使其可供将来使用。这一特定顺序可确保物理内存和虚拟地址空间均被彻底、完整地释放。
cuMemUnmap(ptr, size);
cuMemRelease(handle);
cuMemAddressFree(ptr, size);
注意
在特定于操作系统的情况下,必须使用fclose关闭导出的句柄。此步骤不适用于基于互连网络(fabric)的情况。
4.17.4. 多播内存共享
多播对象管理 API为应用程序提供了创建多播对象的方法,并结合上述虚拟内存管理 API,使应用程序能够在支持此功能、通过 NVSwitch 连接的 NVLink 互连 GPU 上利用 NVLink SHARP。NVLink SHARP 允许 CUDA 应用程序利用互连网络(fabric)内计算,加速通过 NVSwitch 连接的 GPU 之间的广播和归约等操作。为实现这一点,多个通过 NVLink 连接的 GPU 组成一个多播团队,团队中的每个 GPU 都用物理内存为一个多播对象提供后备存储。因此,由 N 个 GPU 组成的多播团队拥有一个多播对象的 N 个物理副本,每个副本都位于某个参与 GPU 的本地。使用多播对象映射的multimem PTX 指令会对该多播对象的所有副本进行操作。
要使用多播对象,应用程序需要
查询多播支持情况。
使用
cuMulticastCreate创建多播句柄。将多播句柄共享给所有控制着应参与多播团队的 GPU 的进程。如上所述,这可通过
cuMemExportToShareableHandle实现。使用
cuMulticastAddDevice添加所有应参与多播团队的 GPU。对于每个参与的 GPU,将如上所述使用
cuMemCreate分配的物理内存绑定到多播句柄。在任何设备上绑定内存之前,需要先将所有设备添加到多播团队。按照上文针对常规单播映射的说明,预留地址范围、映射多播句柄并设置访问权限。可以对同一物理内存建立单播和多播映射。有关如何确保同一物理内存的多个映射之间的一致性,请参阅虚拟别名支持一节。
对多播映射使用multimem PTX 指令。
多 GPU 编程模型 GitHub 仓库中的multi_node_p2p示例包含一个完整示例,使用互连网络(fabric)内存(包括多播对象)来利用 NVLink SHARP。请注意,此示例面向 NCCL 或 NVSHMEM 等库的开发者。它展示了 NVSHMEM 等较高层次的编程模型在一个(多节点)NVLink 域内的内部工作原理。应用程序开发者通常应使用较高层次的 MPI、NCCL 或 NVSHMEM 接口,而不是此 API。
注意
此处描述的多播共享将一个多播对象映射到每个设备的虚拟地址空间,并使用multimem指令对其进行操作,这就是以地址为中心的模型。计算互连传输提供了一个以资源为中心的对应方案,即多播逻辑端点,它通过 NVLink 互连网络(fabric)为一个多播团队提供服务,而不将对象映射到本地地址空间。它会报告每次操作的显式完成状态,因此适用于需要关注互连网络(fabric)错误恢复的大型互连网络(fabric)。
4.17.4.1. 分配多播对象
可以使用cuMulticastCreate创建多播对象:
CUmemGenericAllocationHandle createMCHandle(int numDevices, size_t size) {
    CUmemAllocationProp mcProp = {};
    mcProp.numDevices = numDevices;
    mcProp.handleTypes = CU_MEM_HANDLE_TYPE_FABRIC; // or on single node CU_MEM_HANDLE_TYPE_POSIX_FILE_DESCRIPTOR

    size_t granularity = 0;
    cuMulticastGetGranularity(&granularity, &mcProp, CU_MEM_ALLOC_GRANULARITY_MINIMUM);

    // Ensure size matches granularity requirements for the allocation
    size_t padded_size = ROUND_UP(size, granularity);

    mcProp.size = padded_size;

    // Create Multicast Object this has no devices and no physical memory associated yet
    CUmemGenericAllocationHandle mcHandle;
    cuMulticastCreate(&mcHandle, &mcProp);

    return mcHandle;
}
4.17.4.2. 向多播对象添加设备
可以使用cuMulticastAddDevice将设备添加到多播团队中:
cuMulticastAddDevice(&mcHandle, device);
在将任何设备上的内存绑定到多播对象之前,所有控制多播团队参与设备的进程都需要完成此步骤。
4.17.4.3. 将内存绑定到多播对象
创建多播对象并将所有参与设备添加到多播对象后,需要以使用cuMemCreate为每个设备分配的物理内存作为其后备存储:
cuMulticastBindMem(mcHandle, mcOffset, memHandle, memOffset, size, 0 /*flags*/);
4.17.4.4. 使用多播映射
要在 CUDA C++ 中使用多播映射,必须通过内联 PTX 使用multimem PTX 指令:
__global__ void all_reduce_norm_barrier_kernel(float* l2_norm,
                                               float* partial_l2_norm_mc,
                                               unsigned int* arrival_counter_uc, unsigned int* arrival_counter_mc,
                                               const unsigned int expected_count) {
    assert( 1 == blockDim.x * blockDim.y * blockDim.z * gridDim.x * gridDim.y * gridDim.z );
    float l2_norm_sum = 0.0;
#if __CUDA_ARCH__ >= 900

    // atomic reduction to all replicas
    // this can be conceptually thought of as __threadfence_system(); atomicAdd_system(arrival_counter_mc, 1);
    cuda::ptx::multimem_red(cuda::ptx::release_t, cuda::ptx::scope_sys_t, cuda::ptx::op_add_t, arrival_counter_mc, n);

    // Need a fence between Multicast (mc) and Unicast (uc) access to the same memory `arrival_counter_uc` and `arrival_counter_mc`:
    // - fence.proxy instructions establish an ordering between memory accesses that may happen through different proxies
    // - Value .alias of the .proxykind qualifier refers to memory accesses performed using virtually aliased addresses to the same memory location.
    // from https://docs.nvidia.com/cuda/parallel-thread-execution/#parallel-synchronization-and-communication-instructions-membar
    cuda::ptx::fence_proxy_alias();

    // spin wait with acquire ordering on UC mapping till all peers have arrived in this iteration
    // Note: all ranks need to reach another barrier after this kernel, such that it is not possible for the barrier to be unblocked by an
    // arrival of a rank for the next iteration if some other rank is slow.
    cuda::atomic_ref<unsigned int,cuda::thread_scope_system> ac(arrival_counter_uc);
    while (expected_count > ac.load(cuda::memory_order_acquire));

    // Atomic load reduction from all replicas. It does not provide ordering so it can be relaxed.
    asm volatile ("multimem.ld_reduce.relaxed.sys.global.add.f32 %0, [%1];" : "=f"(l2_norm_sum) : "l"(partial_l2_norm_mc) : "memory");

#else
    #error "ERROR: multimem instructions require compute capability 9.0 or larger."
#endif

    *l2_norm = std::sqrt(l2_norm_sum);
}
4.17.5. 高级配置
4.17.5.1. 内存类型
VMM 还提供了一种机制,使应用程序能够分配某些设备可能支持的特殊类型的内存。通过cuMemCreate,应用程序可以使用CUmemAllocationProp::allocFlags指定内存类型要求,以选择启用特定的内存功能。应用程序必须确保设备支持所请求的内存类型。
4.17.5.2. 可压缩内存
可压缩内存可用于加速对具有非结构化稀疏性的数据以及具有其他可压缩模式的数据的访问。根据数据的不同,压缩可以节省 DRAM 带宽、L2 读取带宽以及 L2 容量。希望在支持计算数据压缩的设备上分配可压缩内存的应用程序,可以通过将CUmemAllocationProp::allocFlags::compressionType设置为CU_MEM_ALLOCATION_COMP_GENERIC来实现。用户必须使用CU_DEVICE_ATTRIBUTE_GENERIC_COMPRESSION_SUPPORTED查询设备是否支持计算数据压缩。以下代码片段演示了如何使用cuDeviceGetAttribute查询对可压缩内存的支持。
int compressionSupported = 0;
cuDeviceGetAttribute(&compressionSupported, CU_DEVICE_ATTRIBUTE_GENERIC_COMPRESSION_SUPPORTED, device);
在支持计算数据压缩的设备上,用户必须在分配时选择启用此功能,如下所示:
prop.allocFlags.compressionType = CU_MEM_ALLOCATION_COMP_GENERIC;
由于硬件资源有限等各种原因,分配的内存可能不具有压缩属性。要验证这些标志是否生效,用户应使用cuMemGetAllocationPropertiesFromHandle查询所分配内存的属性。
CUmemAllocationProp allocationProp = {};
cuMemGetAllocationPropertiesFromHandle(&allocationProp, allocationHandle);

if (allocationProp.allocFlags.compressionType == CU_MEM_ALLOCATION_COMP_GENERIC)
{
    // Obtained compressible memory allocation
}
4.17.5.3. 虚拟别名支持
虚拟内存管理 API 提供了一种方法,通过使用不同的虚拟地址多次调用cuMemMap,为同一内存分配创建多个虚拟内存映射或“代理”。这称为虚拟别名。除非 PTX ISA 中另有说明,否则在执行写入的设备操作(网格启动、memcpy、memset 等)完成之前,对该内存分配的一个代理的写入被视为与同一内存的任何其他代理不一致且不相干。对于在执行写入的设备操作之前已存在于 GPU 上、但在该写入设备操作完成后才进行读取的网格,其代理也被视为不一致且不相干。
例如,假设设备指针 A 和 B 是同一内存分配的虚拟别名,则以下代码片段被视为具有未定义行为:
__global__ void foo(char *A, char *B) {
  *A = 0x1;
  printf("%d\n", *B);    // Undefined behavior!  *B can take on either
// the previous value or some value in-between.
}
假设这两个核函数(通过流或事件)按单调顺序执行,以下行为是已定义的。
__global__ void foo1(char *A) {
  *A = 0x1;
}

__global__ void foo2(char *B) {
  printf("%d\n", *B);    // *B == *A == 0x1 assuming foo2 waits for foo1
// to complete before launching
}

cudaMemcpyAsync(B, input, size, stream1);    // Aliases are allowed at
// operation boundaries
foo1<<<1,1,0,stream1>>>(A);                  // allowing foo1 to access A.
cudaEventRecord(event, stream1);
cudaStreamWaitEvent(stream2, event);
foo2<<<1,1,0,stream2>>>(B);
cudaStreamWaitEvent(stream3, event);
cudaMemcpyAsync(output, B, size, stream3);  // Both launches of foo2 and
                                            // cudaMemcpy (which both
                                            // read) wait for foo1 (which writes)
                                            // to complete before proceeding
如果需要在同一个核函数中通过不同的“代理”访问同一内存分配,可以在两次访问之间使用fence.proxy.alias。因此,可以通过内联 PTX 汇编使上述示例变为合法:
__global__ void foo(char *A, char *B) {
  *A = 0x1;
  cuda::ptx::fence_proxy_alias();
  printf("%d\n", *B);    // *B == *A == 0x1
}
4.17.5.4. 用于 IPC 的操作系统特定句柄详情
通过cuMemCreate,用户可以在分配时表明,已将某个特定的内存分配指定用于进程间通信或图形互操作。应用程序可以通过将CUmemAllocationProp::requestedHandleTypes设置为平台特定的字段来实现这一点。在 Windows 上,当CUmemAllocationProp::requestedHandleTypes设置为CU_MEM_HANDLE_TYPE_WIN32时,应用程序还必须在CUmemAllocationProp::win32HandleMetaData中指定一个 LPSECURITYATTRIBUTES 属性。此安全属性定义了哪些已导出的内存分配可以传递给其他进程。
在尝试导出使用cuMemCreate分配的内存之前,用户必须确保已查询是否支持所请求的句柄类型。以下代码片段演示了如何以平台特定的方式查询对句柄类型的支持。
int deviceSupportsIpcHandle;
#if defined(__linux__)
    cuDeviceGetAttribute(&deviceSupportsIpcHandle, CU_DEVICE_ATTRIBUTE_HANDLE_TYPE_POSIX_FILE_DESCRIPTOR_SUPPORTED, device));
#else
    cuDeviceGetAttribute(&deviceSupportsIpcHandle, CU_DEVICE_ATTRIBUTE_HANDLE_TYPE_WIN32_HANDLE_SUPPORTED, device));
#endif
用户应适当地设置CUmemAllocationProp::requestedHandleTypes,如下所示:
#if defined(__linux__)
    prop.requestedHandleTypes = CU_MEM_HANDLE_TYPE_POSIX_FILE_DESCRIPTOR;
#else
    prop.requestedHandleTypes = CU_MEM_HANDLE_TYPE_WIN32;
    prop.win32HandleMetaData = // Windows specific LPSECURITYATTRIBUTES attribute.
#endif