4.5. 编程式依赖启动与同步
编程式依赖启动机制允许有依赖关系的次级核函数,在同一 CUDA 流中其所依赖的主核函数执行完成之前启动。该技术从计算能力为 9.0 的设备起可用;当次级核函数能够完成大量不依赖主核函数结果的工作时,它可以带来性能收益。
4.5.1. 背景
CUDA 应用程序通过在 GPU 上启动并执行多个核函数来利用 GPU。典型的 GPU 活动时间线如图 42所示。
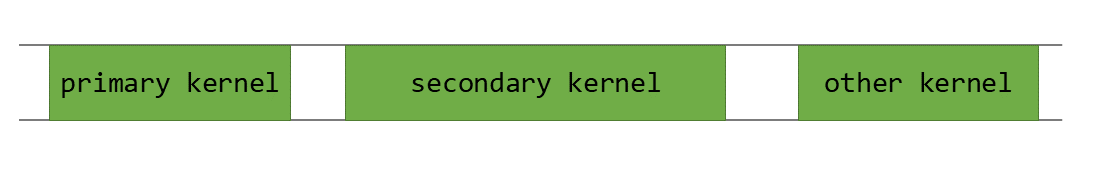
图 42 GPU 活动时间线
图内文字中文对照
primary kernel- 主核函数
secondary kernel- 次核函数
other kernel- 其他核函数
这里,secondary_kernel在primary_kernel执行完成后启动。通常必须串行执行,因为secondary_kernel依赖于primary_kernel产生的结果数据。如果secondary_kernel不依赖于primary_kernel,则可以使用CUDA 流并发启动两者。即使secondary_kernel依赖于primary_kernel,仍有一定的并发执行潜力。例如,几乎所有核函数都有某种前置部分,在其中执行将缓冲区清零或加载常量值等任务。
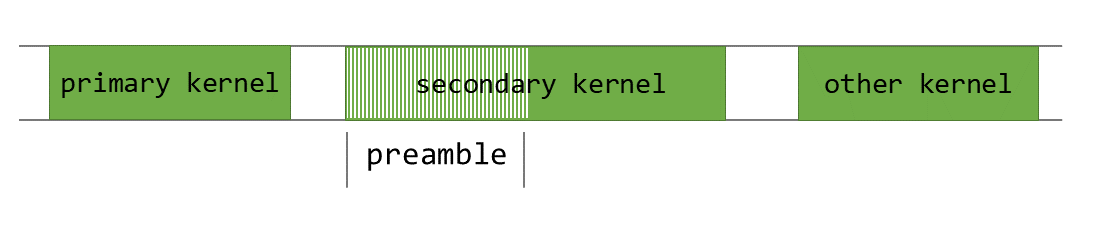
图 43 secondary_kernel的前置部分
图内文字中文对照
primary kernel- 主核函数
secondary kernel- 次核函数
preamble- 前导部分
other kernel- 其他核函数
图 43展示了secondary_kernel中可在不影响应用程序的情况下并发执行的部分。请注意,并发启动还使我们能够通过primary_kernel的执行来隐藏secondary_kernel的启动延迟。
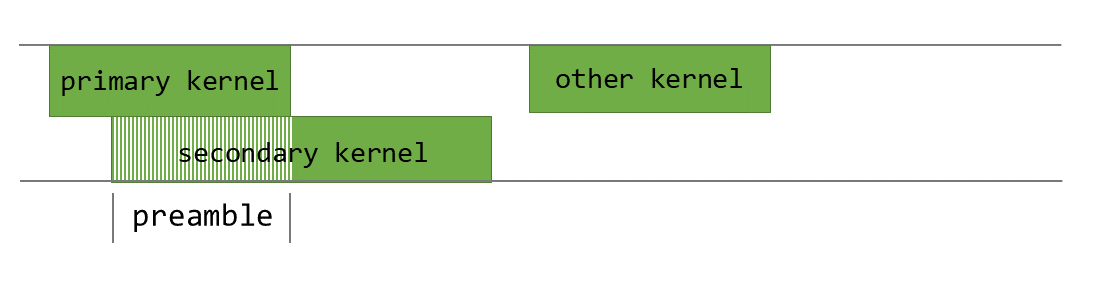
图 44 primary_kernel和secondary_kernel的并发执行
图内文字中文对照
primary kernel- 主核函数
secondary kernel- 次核函数
preamble- 前导部分
other kernel- 其他核函数
使用编程式依赖启动可以实现图 44所示的secondary_kernel的并发启动与执行。
编程式依赖启动对 CUDA 核函数启动 API 引入了更改,下一节将对此进行说明。这些 API 要求计算能力至少为 9.0 才能提供重叠执行。
4.5.2. API 说明
在编程式依赖启动中,主核函数和次级核函数在同一 CUDA 流中启动。当主核函数准备好让次级核函数启动时,其所有线程块都应执行cudaTriggerProgrammaticLaunchCompletion。次级核函数必须使用所示的可扩展启动 API 来启动。
__global__ void primary_kernel() {
   // Initial work that should finish before starting secondary kernel

   // Trigger the secondary kernel
   cudaTriggerProgrammaticLaunchCompletion();

   // Work that can coincide with the secondary kernel
}

__global__ void secondary_kernel()
{
   // Independent work

   // Will block until all primary kernels the secondary kernel is dependent on have completed and flushed results to global memory
   cudaGridDependencySynchronize();

   // Dependent work
}

cudaLaunchAttribute attribute[1];
attribute[0].id = cudaLaunchAttributeProgrammaticStreamSerialization;
attribute[0].val.programmaticStreamSerializationAllowed = 1;
configSecondary.attrs = attribute;
configSecondary.numAttrs = 1;

primary_kernel<<<grid_dim, block_dim, 0, stream>>>();
cudaLaunchKernelEx(&configSecondary, secondary_kernel);
当使用cudaLaunchAttributeProgrammaticStreamSerialization属性启动次级核函数时,CUDA 驱动程序可以安全地提前启动次级核函数,而不必等到主核函数完成并刷新内存后再启动次级核函数。
当主核函数的所有线程块都已启动并执行了cudaTriggerProgrammaticLaunchCompletion时,CUDA 驱动程序即可启动次级核函数。如果主核函数未执行触发操作,则该操作会在主核函数中的所有线程块退出后隐式发生。
无论哪种情况,次级核函数的线程块都可能在主核函数写入的数据变得可见之前启动。因此,当次级核函数配置为使用编程式依赖启动时,它必须始终使用cudaGridDependencySynchronize或其他方式来验证主核函数的结果数据是否可用。
请注意,这些方法为主核函数和次级核函数提供了并发执行的机会,但这种行为是机会性的,并不保证会实现核函数并发执行。依赖这种方式的并发执行是不安全的,可能导致死锁。
4.5.3. 在 CUDA 图中使用
可以通过流捕获,或直接通过边数据,在CUDA 图中使用编程式依赖启动。要在 CUDA 图中通过边数据编程实现此功能,请在连接两个核函数节点的边上将cudaGraphDependencyType的值设为cudaGraphDependencyTypeProgrammatic。这种边类型使上游核函数对下游核函数中的cudaGridDependencySynchronize()可见。此类型必须与cudaGraphKernelNodePortLaunchCompletion或cudaGraphKernelNodePortProgrammatic出端口一起使用。
流捕获所生成的等效图如下:
流代码(简略版) |
生成的图边 |
|---|---|
cudaLaunchAttribute attribute;
attribute.id = cudaLaunchAttributeProgrammaticStreamSerialization;
attribute.val.programmaticStreamSerializationAllowed = 1;
|
cudaGraphEdgeData edgeData;
edgeData.type = cudaGraphDependencyTypeProgrammatic;
edgeData.from_port = cudaGraphKernelNodePortProgrammatic;
|
cudaLaunchAttribute attribute;
attribute.id = cudaLaunchAttributeProgrammaticEvent;
attribute.val.programmaticEvent.triggerAtBlockStart = 0;
|
cudaGraphEdgeData edgeData;
edgeData.type = cudaGraphDependencyTypeProgrammatic;
edgeData.from_port = cudaGraphKernelNodePortProgrammatic;
|
cudaLaunchAttribute attribute;
attribute.id = cudaLaunchAttributeProgrammaticEvent;
attribute.val.programmaticEvent.triggerAtBlockStart = 1;
|
cudaGraphEdgeData edgeData;
edgeData.type = cudaGraphDependencyTypeProgrammatic;
edgeData.from_port = cudaGraphKernelNodePortLaunchCompletion;
|