1.3. CUDA 平台
NVIDIA CUDA 平台由许多软件和硬件,以及为实现异构系统计算而开发的众多重要技术组成。本章旨在介绍 CUDA 平台的一些基本概念和组件,理解这些内容对于应用程序开发者十分重要。与编程模型一样,本章并不针对任何特定编程语言,而是适用于所有使用 CUDA 平台的场景。
1.3.1. 计算能力与流式多处理器(SM)版本
每个 NVIDIA GPU 都有一个计算能力(CC)编号,它表明该 GPU 支持哪些功能,并规定了该 GPU 的一些硬件参数。这些规格记录在附录的第 5.1 节中。CUDA GPU 计算能力页面维护了一份包含所有 NVIDIA GPU 及其计算能力的列表。
计算能力以主版本号和次版本号表示,格式为 X.Y,其中 X 是主版本号,Y 是次版本号。例如,CC 12.0 的主版本号为 12,次版本号为 0。计算能力与 SM 的版本号直接对应。例如,CC 12.0 的 GPU 内部的 SM 具有 SM 版本sm_120。此版本用于标记二进制文件。
第 5.1.1 节说明了如何查询和确定系统中一个或多个 GPU 的计算能力。
1.3.2. CUDA Toolkit 与 NVIDIA 驱动程序
可以将NVIDIA 驱动程序视为 GPU 的操作系统。NVIDIA 驱动程序是一个必须安装在主机系统操作系统上的软件组件,GPU 的所有用途都需要它,包括显示和图形功能。NVIDIA 驱动程序是 CUDA 平台的基础。除了 CUDA,NVIDIA 驱动程序还提供使用 GPU 的所有其他方法,例如 Vulkan 和 Direct3D。NVIDIA 驱动程序具有诸如 r580 这样的版本号。
CUDA Toolkit是一组库、头文件和工具,用于编写、构建和分析利用 GPU 计算的软件。CUDA Toolkit 是独立于 NVIDIA 驱动程序的软件产品
CUDA 运行时是 CUDA Toolkit 所提供的库中的一个特例。CUDA 运行时提供 API 和一些语言扩展,用于处理常见任务,例如分配内存、在 GPU 与其他 GPU 或 CPU 之间复制数据,以及启动核函数。CUDA 运行时的 API 组件被称为 CUDA 运行时 API。
CUDA 兼容性文档提供了有关不同 GPU、NVIDIA 驱动程序和 CUDA Toolkit 版本之间兼容性的完整详细信息。
1.3.2.1. CUDA 运行时 API 与 CUDA 驱动程序 API
CUDA 运行时 API 基于一个称为CUDA 驱动程序 API的更底层 API 实现,后者是 NVIDIA 驱动程序公开的 API。本指南重点介绍 CUDA 运行时 API 所公开的 API。如果需要,仅使用驱动程序 API 也可以实现所有相同的功能。有些功能只能通过驱动程序 API 使用。应用程序可以使用其中一种 API,也可以让两种 API 互操作。CUDA 驱动程序 API一节介绍了运行时 API 与驱动程序 API 之间的互操作。
有关 CUDA 运行时 API 函数的完整 API 参考,请参见CUDA 运行时 API 文档。
有关 CUDA 驱动程序 API 的完整 API 参考,请参见CUDA 驱动程序 API 文档。
1.3.3. 并行线程执行(PTX)
CUDA 平台中一个基础但有时不可见的层是并行线程执行(PTX)虚拟指令集架构(ISA)。PTX 是面向 NVIDIA GPU 的高级汇编语言。PTX 在真实 GPU 硬件的物理 ISA 之上提供了一个抽象层。与其他平台一样,可以直接使用这种汇编语言编写应用程序,但这样做可能会为软件开发增加不必要的复杂性和难度。
领域专用语言及高级语言的编译器可以生成 PTX 代码作为中间表示(IR),然后使用 NVIDIA 的离线或即时(JIT)编译工具生成可执行的 GPU 二进制代码。这使得 CUDA 平台能够使用多种语言进行编程,而不仅仅局限于NVCC:NVIDIA CUDA 编译器等 NVIDIA 提供的工具所支持的语言。
由于 GPU 的能力会随时间变化和增强,PTX 虚拟 ISA 规范采用版本管理。PTX 版本与 SM 版本一样,对应于某个计算能力。例如,支持计算能力 8.0 的所有功能的 PTX 称为compute_80。
有关 PTX 的完整文档,请参见PTX ISA。
1.3.4. Cubins 与 Fatbins
CUDA 应用程序和库通常使用 C++ 等较高级的语言编写。这种较高级的语言被编译为 PTX,然后 PTX 再被编译为面向物理 GPU 的实际二进制文件,称为CUDA 二进制文件,简称cubin。cubin 针对特定的 SM 版本(如sm_120)具有特定的二进制格式。
使用 GPU 计算的可执行文件和库二进制文件同时包含 CPU 和 GPU 代码。GPU 代码存储在一个称为fatbin的容器中。Fatbins 可以包含面向多个不同目标的 cubins 和 PTX。例如,可以将一个应用程序构建为包含面向多种不同 GPU 架构(即不同 SM 版本)的二进制文件。当应用程序运行时,其 GPU 代码被加载到特定 GPU 上,并使用 fatbin 中最适合该 GPU 的二进制文件。
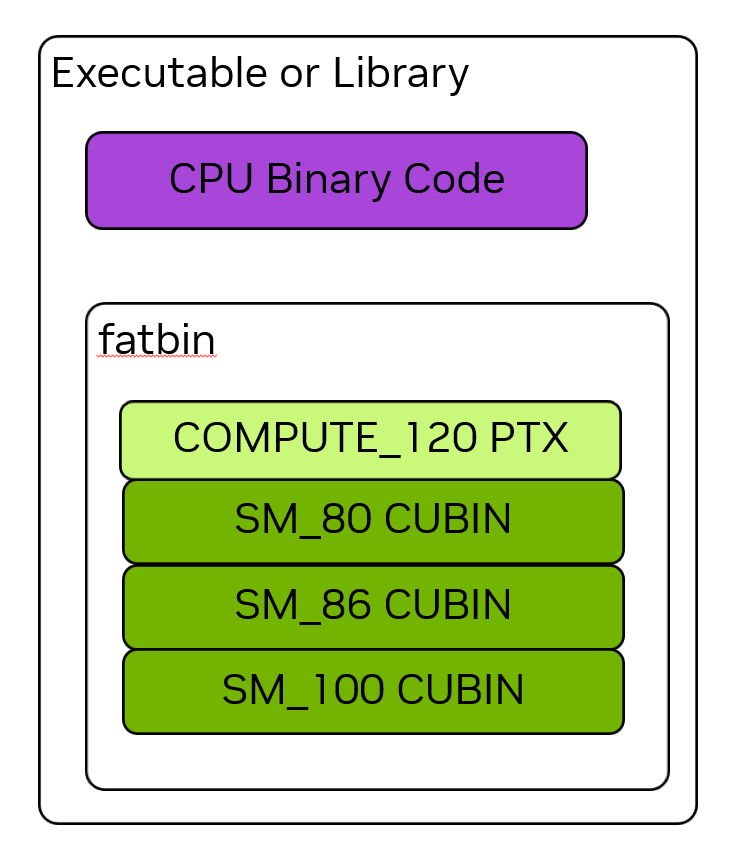
图 10 可执行文件或库的二进制文件同时包含 CPU 二进制代码和用于存储 GPU 代码的 fatbin 容器。一个 fatbin 可以同时包含 cubin GPU 二进制代码和 PTX 虚拟 ISA 代码。PTX 代码可以针对未来的目标进行 JIT 编译。
图内文字中文对照
Executable or Library- 可执行文件或库
CPU Binary Code- CPU 二进制代码
Fatbins 还可以包含一个或多个 PTX 版本的 GPU 代码,其用途在PTX 兼容性中进行了说明。图 10展示了一个应用程序或库的二进制文件示例,其中包含多个 cubin 版本的 GPU 代码以及一个版本的 PTX 代码。
1.3.4.1. 二进制兼容性
NVIDIA GPU 在某些情况下保证二进制兼容性。具体而言,在同一计算能力主版本内,计算能力次版本大于或等于 cubin 目标版本的 GPU 可以加载并执行该 cubin。例如,如果应用程序包含一个 cubin,其中的代码针对计算能力 8.6 编译,那么该 cubin 可以在计算能力为 8.6 或 8.9 的 GPU 上加载和执行。但是,它不能在计算能力为 8.0 的 GPU 上加载,因为该 GPU 的 CC 次版本号 0 低于代码的次版本号 6。
NVIDIA GPU 在不同的计算能力主版本之间不具备二进制兼容性。也就是说,针对计算能力 8.6 编译的 cubin 代码无法在计算能力为 9.0 的 GPU 上加载。
讨论二进制代码时,通常会说二进制代码具有某个版本,例如上述示例中的sm_86。这与说该二进制文件是针对计算能力 8.6 构建的含义相同。这种简写经常使用,因为开发者就是以这种方式向 NVIDIA CUDA 编译器nvcc指定此二进制构建目标的。
注意
只有由nvcc等 NVIDIA 工具创建的二进制文件才享有二进制兼容性保证。不支持手动编辑或生成用于 NVIDIA GPU 的二进制代码。如果以任何方式修改二进制文件,兼容性保证即告失效。
1.3.4.2. PTX 兼容性
GPU 代码可以以二进制或 PTX 形式存储在可执行文件中,这在Cubins 与 Fatbins中有所介绍。当应用程序存储了 PTX 版本的 GPU 代码时,该 PTX 可以在应用程序运行时针对任何等于或高于该 PTX 代码计算能力的计算能力进行 JIT 编译。例如,如果应用程序包含面向compute_80的 PTX,则可以在应用程序运行时将该 PTX 代码 JIT 编译为面向较新 SM 版本(如sm_120)的代码。这实现了与未来 GPU 的前向兼容,而无需重新构建应用程序或库。
1.3.4.3. 即时编译
应用程序在运行时加载的 PTX 代码由设备驱动程序编译为二进制代码。这称为即时(JIT)编译。即时编译会增加应用程序的加载时间,但使应用程序能够受益于每个新设备驱动程序随附的任何新编译器改进。它还使应用程序能够在其编译时尚不存在的设备上运行。
当设备驱动程序为应用程序即时编译 PTX 代码时,它会自动缓存所生成二进制代码的一个副本,以避免在后续调用该应用程序时重复编译。这个称为计算缓存的缓存会在设备驱动程序升级时自动失效,使应用程序能够受益于设备驱动程序中内置的新即时编译器的改进。
相较于 CUDA 的最早版本,对运行时如何以及何时对 PTX 进行 JIT 编译的限制已经放宽,在何时以及是否对部分或全部核函数进行 JIT 编译方面提供了更大的灵活性。延迟加载一节介绍了可用的选项以及如何控制 JIT 行为。此外,还有几个控制即时编译行为的环境变量,详见CUDA 环境变量。
除了使用nvcc编译 CUDA C++ 设备代码外,还可以使用 NVRTC 在运行时将 CUDA C++ 设备代码编译为 PTX。NVRTC 是用于 CUDA C++ 的运行时编译库;更多信息可参见 NVRTC 用户指南。
1.3.4.4. 二进制最终化
从计算能力 10.0 开始,同一系列内的二进制兼容性由 NVIDIA 驱动程序以软件方式管理。用于计算能力 10.0 及更高版本架构的 cubin 采用一种扩展了二进制表示的格式,以提供同一系列内的二进制兼容性。为某个特定目标架构生成(最终化)的二进制文件可以直接在该目标架构上执行,也可以在运行时针对任何保证具有二进制兼容性的 GPU重新进行最终化。用于计算能力 9.x 及更早版本的 cubin 不具备运行时重新最终化的资格。
当为某个目标架构生成的、用于计算能力 10.0 或更高版本的 cubin 被加载到同一 GPU 系列中另一个不同但兼容的架构上时,驱动程序会执行即时最终化,将该 cubin 绑定到目标 GPU 的架构。此过程称为非目标架构最终化。
非目标架构最终化使非目标架构执行成为可能,即为一个架构最终化的 cubin 在同一 GPU 系列中的另一个兼容架构上运行。当 cubin 被加载到生成它时所针对的架构上时,这种执行被视为目标架构执行。目标架构执行不需要进一步的最终化。
不应将用于非目标架构执行的即时最终化与 PTX 即时编译混淆。PTX JIT 编译将 PTX 代码编译成已经针对目标架构完成最终化的 GPU 二进制代码。对 cubin 进行非目标架构最终化,是针对另一个兼容架构对现有 cubin 重新进行最终化。非目标架构最终化的开销显著低于 PTX JIT 编译,但相对于目标架构执行,它仍可能增加模块加载时间。
非目标架构最终化的开销取决于要进行最终化的代码量、模块加载期间可用的主机 CPU 资源,以及源架构与目标架构之间的关系。当对 cubin 进行非目标架构最终化时,加载大型模块或大量模块的应用程序可能会观察到启动时间增加。
与 PTX JIT 编译一样,NVIDIA 驱动程序可以缓存 cubin 的非目标架构最终化结果,以避免在随后调用该应用程序时重复最终化工作。此缓存由第 5.2.2 节中介绍的同一组 CUDA 缓存环境变量控制。