4.19. 扩展 GPU 内存
扩展 GPU 内存(EGM)功能利用高带宽 NVLink-C2C,使 GPU 能够在单节点和多节点系统中高效访问全部系统内存。EGM 适用于集成 CPU-GPU 的 NVIDIA 系统,允许分配可由该配置中任意 GPU 线程访问的物理内存。EGM 确保所有 GPU 都能以 GPU-GPU NVLink 或 NVLink-C2C 的速度访问其资源。
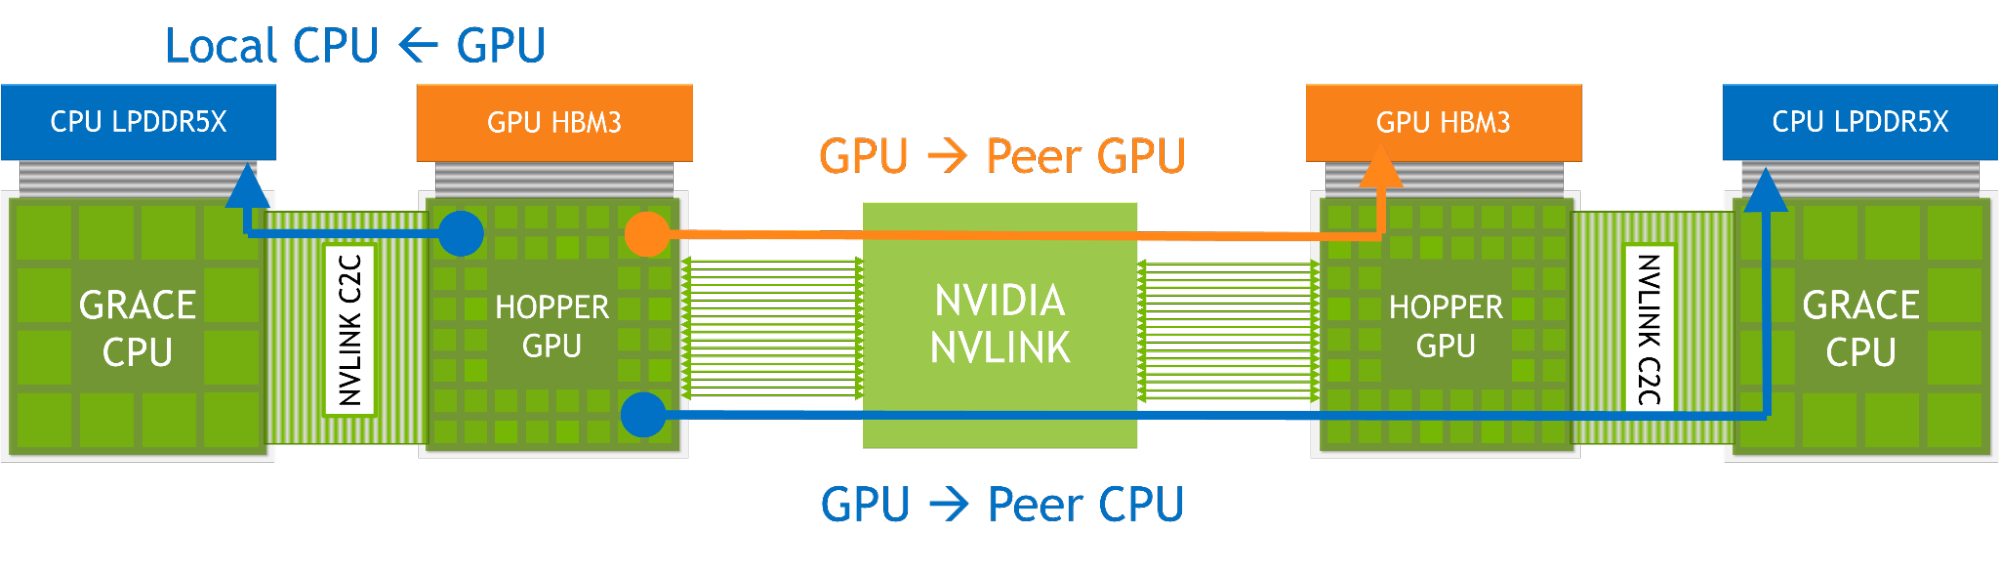
图内文字中文对照
Local CPU ← GPU- 本地 CPU ← GPU
GPU → Peer GPU- GPU → 对等 GPU
GPU → Peer CPU- GPU → 对等 CPU
在此配置中,内存访问通过本地高带宽 NVLink-C2C 进行。远程内存访问使用 GPU NVLink,在某些情况下还会使用 NVLink-C2C。借助 EGM,GPU 线程能够通过 NVSwitch 互连网络(fabric)访问所有可用的内存资源,包括连接到 CPU 的内存和 HBM3。
4.19.1. 预备知识
在深入介绍用于 EGM 功能的 API 更改之前,我们将先介绍当前支持的拓扑、标识符分配、虚拟内存管理的先决条件,以及用于 EGM 的 CUDA 类型。
4.19.1.1. EGM 平台:系统拓扑
目前,可以在多种平台上启用 EGM:(1)单节点、单 GPU:由基于 Arm 的 CPU、连接到 CPU 的内存和一个 GPU 组成。CPU 与 GPU 之间具有高带宽 C2C(芯片到芯片)互连。(2)单节点、多 GPU:由基于 ARM 的多个 CPU 和通过基于 NVLink 的网络连接的多个 GPU 组成,每个 CPU 都带有相连的内存。(3)多节点、多 GPU:由两个或更多通过基于 NVLink 的网络连接的单节点系统组成,每个系统均如上面的(1)或(2)所述。
注意
使用cgroups限制可用设备会阻断通过 EGM 的路由,并导致性能问题。请改用CUDA_VISIBLE_DEVICES。
4.19.1.2. 插槽标识符:它们是什么?如何访问它们?
NUMA(非统一内存访问)是一种用于多处理器计算机系统的内存架构,其中内存被划分为多个节点。每个节点都有自己的处理器和内存。在这样的系统中,NUMA 将系统划分为节点,并为每个节点分配一个唯一的标识符(numaID)。
EGM 使用操作系统分配的 NUMA 节点标识符。注意,此标识符不同于设备的序号,它与最近的主机节点相关联。除了现有方法外,用户还可以使用CU_DEVICE_ATTRIBUTE_HOST_NUMA_ID属性类型调用cuDeviceGetAttribute,获取主机节点的标识符(numaID),如下所示:
int numaId;
cuDeviceGetAttribute(&numaId, CU_DEVICE_ATTRIBUTE_HOST_NUMA_ID, deviceOrdinal);
4.19.1.3. 分配器与 EGM 支持
将系统内存映射为 EGM 不会导致任何性能问题。事实上,访问映射为 EGM 的远程插槽的系统内存会更快。这是因为 EGM 保证流量通过 NVLink 路由。目前,支持使用适当的位置类型和 NUMA 标识符的cuMemCreate和cudaMemPoolCreate分配器。
4.19.1.4. 对现有 API 的内存管理扩展
目前,可以使用虚拟内存(cuMemCreate)或流有序内存(cudaMemPoolCreate)分配器映射 EGM 内存。用户负责分配物理内存,并在所有插槽上将其映射到虚拟内存地址空间。
注意
多节点、多 GPU 平台需要进程间通信。因此,我们建议读者参阅第 4.16 章。
API 中新增了 CUDA 属性类型,使这些方法能够通过类似 NUMA 的节点标识符了解分配位置:
CUDA 类型 |
配合使用 |
|
用于 |
|
用于 |
注意
请参阅CUDA 驱动程序 API和CUDA 运行时数据类型,了解有关 NUMA 专用 CUDA 类型的更多信息。
4.19.2. 使用 EGM 接口
4.19.2.1. 单节点、单 GPU
任何现有的 CUDA 主机分配器以及系统分配的内存都可以用来受益于高带宽 C2C。对用户而言,本地访问与目前的主机内存分配相同。
注意
有关内存分配器和页大小的更多信息,请参阅调优指南。
4.19.2.2. 单节点、多 GPU
在多 GPU 系统中,用户必须提供用于确定放置位置的主机信息。如前所述,表达这些信息的一种自然方式是使用 NUMA 节点 ID,EGM 也采用这种方式。因此,用户应该能够使用cuDeviceGetAttribute函数获知最近的 NUMA 节点 ID。(参阅插槽标识符:它们是什么?如何访问它们?。)然后,用户可以使用 VMM(虚拟内存管理)API 或 CUDA 内存池来分配和管理 EGM 内存。
4.19.2.2.1. 使用 VMM API
使用虚拟内存管理 API 分配内存的第一步,是创建一个物理内存块,作为该分配的后备存储。更多详细信息,请参阅《CUDA 编程指南》的虚拟内存管理一节。在 EGM 分配中,用户必须显式提供CU_MEM_LOCATION_TYPE_HOST_NUMA作为位置类型,并提供numaID作为位置标识符。此外,在 EGM 中,分配必须按平台适当的粒度对齐。以下代码片段展示了使用cuMemCreate分配物理内存:
CUmemAllocationProp prop{};
prop.type = CU_MEM_ALLOCATION_TYPE_PINNED;
prop.location.type = CU_MEM_LOCATION_TYPE_HOST_NUMA;
prop.location.id = numaId;
size_t granularity = 0;
cuMemGetAllocationGranularity(&granularity, &prop, MEM_ALLOC_GRANULARITY_MINIMUM);
size_t padded_size = ROUND_UP(size, granularity);
CUmemGenericAllocationHandle allocHandle;
cuMemCreate(&allocHandle, padded_size, &prop, 0);
分配物理内存后,我们必须保留一个地址空间,并将其映射到一个指针。这些过程没有针对 EGM 的特定更改:
CUdeviceptr dptr;
cuMemAddressReserve(&dptr, padded_size, 0, 0, 0);
cuMemMap(dptr, padded_size, 0, allocHandle, 0);
最后,用户必须显式保护已映射的虚拟地址范围。否则,访问已映射的空间将导致崩溃。与内存分配类似,用户必须提供CU_MEM_LOCATION_TYPE_HOST_NUMA作为位置类型,并提供numaId作为位置标识符。以下代码片段为主机节点和 GPU 创建访问描述符,以便授予二者对已映射内存的读写访问权限:
CUmemAccessDesc accessDesc[2]{{}};
accessDesc[0].location.type = CU_MEM_LOCATION_TYPE_HOST_NUMA;
accessDesc[0].location.id = numaId;
accessDesc[0].flags = CU_MEM_ACCESS_FLAGS_PROT_READWRITE;
accessDesc[1].location.type = CU_MEM_LOCATION_TYPE_DEVICE;
accessDesc[1].location.id = currentDev;
accessDesc[1].flags = CU_MEM_ACCESS_FLAGS_PROT_READWRITE;
cuMemSetAccess(dptr, size, accessDesc, 2);
4.19.2.2.2. 使用 CUDA 内存池
要定义 EGM,用户可以在一个节点上创建内存池,并向对等方授予访问权限。在这种情况下,用户必须显式定义cudaMemLocationTypeHostNuma为位置类型,并定义numaId为位置标识符。以下代码片段展示了使用cudaMemPoolCreate创建内存池:
cudaSetDevice(homeDevice);
cudaMemPoolProps props{};
props.allocType = cudaMemAllocationTypePinned;
props.location.type = cudaMemLocationTypeHostNuma;
props.location.id = numaId;
cudaMemPoolCreate(&memPool, &props);
此外,对于直接连接的对等访问,也可以使用现有的对等访问 APIcudaMemPoolSetAccess。以下代码片段展示了一个accessingDevice的示例:
cudaMemAccessDesc desc{};
desc.flags = cudaMemAccessFlagsProtReadWrite;
desc.location.type = cudaMemLocationTypeDevice;
desc.location.id = accessingDevice;
cudaMemPoolSetAccess(memPool, &desc, 1);
创建内存池并授予访问权限后,用户可以将所创建的内存池设置给residentDevice,然后开始使用cudaMallocAsync分配内存:
cudaDeviceSetMemPool(residentDevice, memPool);
cudaMallocAsync(&ptr, size, memPool, stream);
注意
EGM 使用 2MB 的页进行映射。因此,用户在访问非常大的内存分配时,可能会遇到更多 TLB 未命中。
4.19.2.3. 多节点、多 GPU
除内存分配之外,远程对等访问没有针对 EGM 的特定修改,并且遵循 CUDA 进程间(IPC)协议。有关 IPC 的更多详细信息,请参阅CUDA 编程指南。
用户应使用cuMemCreate分配内存,并且同样必须显式提供CU_MEM_LOCATION_TYPE_HOST_NUMA作为位置类型,提供numaID作为位置标识符。此外,应将CU_MEM_HANDLE_TYPE_FABRIC定义为所请求的句柄类型。以下代码片段展示了在节点 A 上分配物理内存的过程:
CUmemAllocationProp prop{};
prop.type = CU_MEM_ALLOCATION_TYPE_PINNED;
prop.requestedHandleTypes = CU_MEM_HANDLE_TYPE_FABRIC;
prop.location.type = CU_MEM_LOCATION_TYPE_HOST_NUMA;
prop.location.id = numaId;
size_t granularity = 0;
cuMemGetAllocationGranularity(&granularity, &prop,
                              MEM_ALLOC_GRANULARITY_MINIMUM);
size_t padded_size = ROUND_UP(size, granularity);
size_t page_size = ...;
assert(padded_size % page_size == 0);
CUmemGenericAllocationHandle allocHandle;
cuMemCreate(&allocHandle, padded_size, &prop, 0);
使用cuMemCreate创建分配句柄后,用户可以调用cuMemExportToShareableHandle将该句柄导出到另一个节点,即节点 B:
cuMemExportToShareableHandle(&fabricHandle, allocHandle,
                             CU_MEM_HANDLE_TYPE_FABRIC, 0);
// At this point, fabricHandle should be sent to Node B via TCP/IP.
在节点 B 上,可以使用cuMemImportFromShareableHandle导入该句柄,并将其视为任何其他互连网络(fabric)句柄
// At this point, fabricHandle should be received from Node A via TCP/IP.
CUmemGenericAllocationHandle allocHandle;
cuMemImportFromShareableHandle(&allocHandle, &fabricHandle,
                               CU_MEM_HANDLE_TYPE_FABRIC);
在节点 B 上导入句柄后,用户就可以保留一个地址空间,并以常规方式在本地进行映射:
size_t granularity = 0;
cuMemGetAllocationGranularity(&granularity, &prop,
                              MEM_ALLOC_GRANULARITY_MINIMUM);
size_t padded_size = ROUND_UP(size, granularity);
size_t page_size = ...;
assert(padded_size % page_size == 0);
CUdeviceptr dptr;
cuMemAddressReserve(&dptr, padded_size, 0, 0, 0);
cuMemMap(dptr, padded_size, 0, allocHandle, 0);
最后一步,用户应为节点 B 上的每个本地 GPU 授予适当的访问权限。以下代码片段示例为八个本地 GPU 授予读写访问权限:
// Give all 8 local  GPUS access to exported EGM memory located on Node A.                                                               |
CUmemAccessDesc accessDesc[8];
for (int i = 0; i < 8; i++) {
   accessDesc[i].location.type = CU_MEM_LOCATION_TYPE_DEVICE;
   accessDesc[i].location.id = i;
   accessDesc[i].flags = CU_MEM_ACCESS_FLAGS_PROT_READWRITE;
}
cuMemSetAccess(dptr, size, accessDesc, 8);
注意
此处展示的跨节点共享是以地址为中心的:导入的内存分配被映射到本地虚拟地址空间中,并通过普通的加载和存储进行访问。对于通过 NVLink 互连网络(fabric)连接的 GPU,计算互连传输提供了一种以资源为中心的替代方案,它针对一个命名的逻辑端点而非映射的地址,通过异步互连网络操作移动数据。它会报告每个操作的显式完成状态,因此适用于需要考虑互连网络错误恢复的大型互连网络。