2.4. 编写分块核函数
CUDA Tile 提供了一种编写 GPU 核函数代码的方法,不同于前几章介绍的单指令多线程(SIMT)模型。分块(tile)编程允许程序员以不同的方式表达并行性,并将最低层次的并行性留给编译器和内置操作处理。通过这种方式,分块为利用 NVIDIA GPU 新近的性能特性提供了一种更简单的方法,例如张量内存加速器(TMA)单元和张量核心。
在 Python 中,可以通过 cuTile Python 包
cuda.tile进行 CUDA Tile 编程。从 13.3 版本开始,CUDA Toolkit 提供 CUDA Tile C++。
分块核函数外围用于分配设备内存、在主机与设备之间传输数据以及安排核函数启动顺序等任务的应用程序代码,与前几章针对 SIMT 核函数介绍的代码完全相同。分块核函数对使用标准 CUDA API 分配的全局内存进行操作,其结果也以相同方式复制回主机。唯一发生变化的是程序员在核函数本身内部编写的代码。
在 SIMT 核函数中,程序员以单个线程为单位进行思考:计算全局线程索引、加载该线程的元素、对这些元素执行操作,然后存储结果。在分块核函数中,程序员在整个块的层次上进行思考:加载包含许多元素的分块、对整个分块执行操作,然后存储结果。编译器负责将分块操作映射到每个块的硬件线程,而在 SIMT 中,这一问题由程序员显式处理。
本章仅关注这一差异:如何编写核函数入口点及其内部的分块操作。每种模式都使用 CuTile Python(cuda.tile)和 CUDA Tile C++(cuda::tiles)两种语言演示,它们共用一个编译器后端(CUDA Tile IR),因此具有相同的执行语义。
按照惯例,在这两种语言中都将分块 API 的别名设为ct。
Python 中的
import cuda.tile as ctC++ 中的
namespace ct = cuda::tiles
在 Python 中,分块 API 位于cuda.tiles模块中,该模块按上面所示的方式导入。
在 C++ 中,分块 API 位于cuda::tiles命名空间中,由cuda_tile.h头文件公开。
#include "cuda_tile.h"
namespace ct = cuda::tiles;
在下面的代码片段中,无论你阅读的是哪种语言,ct. / ct::前缀都指该语言中的分块 API。
2.4.1. 核函数和函数声明
分块核函数是 GPU 的入口点,会在启动网格中的每个块上执行一次。分块函数可从分块核函数或另一个分块函数中调用,但它本身不是入口点。与 SIMT 核函数一样,分块核函数不能从主机代码中直接调用;必须启动它们。
在 CUDA Tile C++ 中:
__tile_global__是分块中与__global__对应的形式,用于标记分块核函数入口点__tile__是分块中与__device__对应的形式,表示一个应针对 GPU 编译且可从其他__tile__或__tile_global__函数中调用的函数。
数组参数和标量参数的传递方式与 SIMT 核函数相同。分块代码和 SIMT 代码可以共存:单个.cu文件可以同时定义__tile_global__和__global__核函数,单个主机程序可以启动这两种核函数。
注意
目前,不能从__global__或__device__函数中调用__tile__函数。同样,不能从__tile_global__或__tile__函数中调用__device__函数。未来版本的 CUDA 可能会解除这一限制。
在 cuTile Python 中:
@ct.kernel装饰器将一个函数标记为分块核函数入口点@ct.function装饰器将一个函数标记为可从分块核函数或另一个分块函数中调用的函数。
实际上,从核函数中调用的任何函数都会自动编译为分块代码,因此@ct.function装饰器是可选的。数组参数接受任何驻留在设备上且公开 DLPack 或 CUDA Array Interface 的数组。例如,PyTorch 张量和 CuPy 数组。标量参数直接传递。
#include "cuda_tile.h"

// Tile kernel entry point. Cannot be called directly; must be launched.
__tile_global__ void my_kernel(float* a, float* b, float* c) {
    ...
}

// Tile function. Callable from tile kernels and tile functions.
__tile__ float helper(float x, float y) {
    return x + y;
}
import cuda.tile as ct

# Tile kernel entry point. Cannot be called directly; must be launched.
@ct.kernel
def my_kernel(a, b, c):
    ...

# Tile function. Callable from tile kernels and tile functions.
# @ct.function is optional, any function called from tile code
# is automatically compiled as tile code.
@ct.function
def helper(x, y):
    return x + y
2.4.2. 启动核函数
分块核函数在由分块线程块组成的网格上启动,正如 SIMT 核函数在由线程块组成的网格上启动一样。程序员指定网格形状,最多为三个维度。从程序员的角度看,每个分块线程块都由单个逻辑线程执行。块内的并行性由编译器管理。
在 C++ 中,分块核函数复用 SIMT 中熟悉的三重尖括号启动语法。尖括号中的第一个参数是网格形状(分块线程块的数量)。第二个参数是 SIMT 中每个块的线程数;对于分块核函数,编译器在内部确定线程数,第二个参数必须为1。分块核函数也是普通的 CUDA 核函数,因此可以通过运行时现有的 APIcudaLaunchKernel和cudaLaunchKernelEx使用相同的grid, 1配置来启动它。当要将分块核函数集成到已经通过这些 API 执行启动的代码库中时,这一点很有用。
在 Python 中,ct.launch接受四个位置参数:一个 CUDA 流、一个指定每个维度上分块线程块数量的网格元组、核函数对象,以及一个核函数参数元组。
my_kernel<<<dim3(num_blocks_x, num_blocks_y), 1>>>(a, b, c); // second arg must be 1
import torch

stream = torch.cuda.current_stream()     # CUDA stream object
grid = (num_blocks_x, num_blocks_y, 1)   # tile-block grid (x, y, z)
ct.launch(stream, grid, my_kernel, (a, b, c))
2.4.2.1. 网格大小设置模式
一种常见模式是启动足够多的块以覆盖整个数组,其中最后一个块可能在一个或多个维度上超出数组的大小。
int num_blocks = (N + tile_size - 1) / tile_size;   // ceil division -> covers partial tail
kernel<<<num_blocks, 1>>>(in, out, N);
import math

grid = (math.ceil(N / TILE),)   # ceil division -> covers partial tail
ct.launch(stream, grid, my_kernel, (arr_in, arr_out, TILE))
第 2.4.6 节的各小节讨论了如何处理数组大小不能被分块大小整除的情况。
2.4.3. 查询块的位置
每个块都需要知道自己位于网格中的什么位置,以便确定要处理哪一部分数据。在 SIMT 中,程序员结合blockIdx和threadIdx计算全局线程索引。在分块代码中,只需要块索引。编译器会处理块内所有线程级别的索引计算。
在 C++ 中,ct::bid()返回一个uint3,其中包含所有三个维度上的块索引。ct::num_blocks()返回一个dim3,其中包含每个维度上的块总数(由核函数启动参数确定)。通过.x、.y、.z访问各个分量。
在 Python 中,ct.bid(axis)以int32标量的形式返回当前块在给定轴(0、1 或 2)上的索引。ct.num_blocks(axis)返回该轴上的块总数,这对于边界检查和循环计数很有用。
#include "cuda_tile.h"

__tile_global__ void my_kernel(float* a, float* b, float* c) {
    namespace ct = cuda::tiles;
    int bid_x = ct::bid().x;          // block index along .x
    int bid_y = ct::bid().y;          // block index along .y
    int num_x = ct::num_blocks().x;   // total blocks along .x
}
@ct.kernel
def my_kernel(a, b, c):
    bid_x = ct.bid(0)          # block index along axis 0
    bid_y = ct.bid(1)          # block index along axis 1
    num_x = ct.num_blocks(0)   # total blocks along axis 0
2.4.4. 创建分块
确定块的标识之后,下一个问题是分块核函数实际操作的对象是什么。答案就是分块:它是大小固定的多维标量元素数组,其形状和元素类型在编译时已知。分块每个维度的大小都必须是 2 的幂。分块具有值语义。这意味着复制分块会复制其元素,且两个副本完全独立。尽管如此,复制的开销很小,因为编译器控制着分块在硬件内部的表示方式。程序员无需为分块分配或释放内存。
实际上,分块的创建方式有两种:从数组中加载数据(分块空间中的加载和存储),或使用工厂函数生成按指定模式填充的分块。
在 C++ 中,分块类型是显式的:ct::tile<T, ct::shape<dims...>>,其中T是元素类型,ct::shape<dims...>将各维度编码为模板参数(这些整数值是各轴上在编译时确定的大小)。例如,ct::tile<float, ct::shape<8>>是一个包含 8 个浮点数的一维分块,而ct::tile<float, ct::shape<4, 4>>是一个 4×4 的浮点数分块。由于形状是类型的一部分,因此它始终在编译时已知。
工厂函数接受完整的分块类型(下文中的Tile)作为模板参数:
ct::zeros<Tile>()和ct::ones<Tile>():用零或一填充的分块。ct::full<Tile>(val):每个元素的值均为val的分块。ct::iota<Tile>():包含(0, 1, ..., N-1)的分块,其中N是分块的大小。
本章所有 C++ 示例都使用using别名(例如using f32x4x4 = ct::tile<float, ct::shape<4, 4>>),以保持调用处的分块类型易于阅读。
在 Python 中,传给分块工厂的shape元组和dtype参数都是编译时值。Python 字面量(如(64, 64)和ct.float32)天然满足这一要求。也可以使用带有Constant注解的核函数参数来提供这些值,如下文Python Constant[T]所示。得到的分块会公开.shape、.dtype和.ndim属性,这些属性反映其编译时特性。
工厂函数包括:
ct.zeros(shape, dtype)和ct.ones(shape, dtype):用零或一填充的分块。ct.full(shape, fill_value, dtype):用任意常量值填充的分块。ct.arange(size, dtype=...):包含[0, 1, ..., size-1]的一维分块。
#include "cuda_tile.h"

__tile__ void factories() {
    namespace ct = cuda::tiles;

    using i32x8   = ct::tile<int,   ct::shape<8>>;      // 1-D: 8 ints
    using f32x4x4 = ct::tile<float, ct::shape<4, 4>>;   // 2-D: 4x4 floats

    auto z      = ct::zeros<f32x4x4>();       // all zeros
    auto o      = ct::ones<f32x4x4>();        // all ones
    auto filled = ct::full<f32x4x4>(3.14f);   // all 3.14
    auto seq    = ct::iota<i32x8>();          // {0, 1, 2, 3, 4, 5, 6, 7}
}
import cuda.tile as ct

@ct.function
def factories():
    zeros  = ct.zeros((64, 64), dtype=ct.float32)            # 64x64 tile of 0.0
    ones   = ct.ones((128,), dtype=ct.float16)               # 128-element tile of 1.0
    filled = ct.full((32, 32), 3.14, dtype=ct.float32)       # 32x32 tile of 3.14
    seq    = ct.arange(8, dtype=ct.int32)                    # [0, 1, 2, 3, 4, 5, 6, 7]
2.4.5. 编译时常量
分块编译器为分块形状、数据类型和其他结构参数的每种组合生成专门的机器代码。因此,影响所生成代码的值必须在编译时已知。也就是说,分块的形状和数据类型必须在编译时已知。创建分块使用字面量来指定分块形状和数据类型:ct.zeros((64, 64), dtype=ct.float32)和ct::tile<int, ct::shape<8>>。
也可以通过核函数接口将形状作为编译时已知的值传递,如以下各节所示。
2.4.5.1. Python Constant[T]
核函数参数上的ct.Constant[T]类型提示将其标记为常量嵌入参数。这意味着,在核函数内部每次使用该参数时,其行为都如同在相应位置直接写入了字面量值。类型实参是可选的,不带类型实参的ct.Constant会嵌入任意类型的常量。ct.Constant最常用于整数,即ct.Constant[int],用于决定分块形状和循环边界的参数。
import cuda.tile as ct

@ct.kernel
def my_kernel(TILE: ct.Constant[int]):
    # TILE is constant-embedded: wherever TILE appears, the compiler sees its
    # literal value (e.g., 128) and generates specialized code. Here TILE drives
    # the shape of a factory-built tile.
    zeros = ct.zeros((TILE,), dtype=ct.float32)
2.4.5.2. C++ integral_constant 和 _ic 字面量
在 CUDA Tile C++ 中,编译时值通过ct::integral_constant表达,这是一种将数值编码在类型本身中的类型。ct::literals命名空间中的_ic字面量提供了一种简洁的简写形式:0_ic生成一个ct::integral_constant<0>值。
接受编译时值的 API 同时接受非类型模板参数(NTTP)形式和_ic字面量形式。例如,ct::cat沿给定维度拼接两个分块,而该维度必须在编译时已知。下面两行使用相同的编译时轴调用ct::cat;它们唯一的区别在于编译时值写在什么位置:
#include "cuda_tile.h"

__tile__ void concat_demo() {
    namespace ct = cuda::tiles;
    using namespace ct::literals;

    using T = ct::tile<int, ct::shape<4, 8>>;
    T lhs = ct::full<T>(0);
    T rhs = ct::full<T>(1);

    auto a = ct::cat<0>(lhs, rhs);     // NTTP form
    auto b = ct::cat(lhs, rhs, 0_ic);  // _ic form
}
_ic字面量还经常出现在另一个地方。ct::extents和ct::shape各自都有 NTTP 形式(例如ct::extents<std::uint32_t, 4, 8>)和花括号形式。与 NTTP 形式不同,花括号形式接受运行时值,因此,当一个或多个维度仅在启动时才已知时,就应使用这种形式:编译时维度使用_ic字面量,运行时维度使用普通变量。ct::tensor_span和ct::partition_view等分块空间 API(在分块空间中的加载和存储中介绍)使用这种形式来封装此类数组:
auto shape2d = ct::extents{8_ic, length}; // 8 is compile-time; length is runtime
凡是值形式的 API 实参需要编译时值时,_ic字面量都是编译时值的统一简写形式,例如ct::cat维度或extents或shape分量。
2.4.6. 加载和存储分块
正如第 1.2.2.3.1 节最初介绍的那样,CUDA 分块编程模型中有两种关键的内存对象:分块和数组。数组是全局内存中的多维元素容器,对分块核函数的所有块可见。分块也是多维元素容器,但仅局限于 CUDA 分块代码的单个块。分块通常是数组元素的一个子集。本节讨论如何将数组中的数据加载到分块中,以便在分块核函数中使用,以及如何将分块存储回数组。
后续各节将介绍两种加载和存储分块的方法
分块空间加载与存储介绍使用分块空间索引的加载和存储,这类操作使用视图对象,以可预测的模式规定数组元素如何映射到分块
聚集与散布介绍使用索引分块或指针分块的加载和存储,分别用于指示加载时分块元素在数组中的来源元素,或存储时在数组中的目标元素
性能注意事项:在支持的硬件上,编译器可以将分块空间加载映射到张量内存加速器(TMA),这比逐元素聚集快得多。(有关 C++ 方面的内容,另请参阅C++ 性能提示。)
程序员必须决定加载时越界元素应取何值。在 Python 中,默认会静默丢弃越界写入;在 C++ 中,使用带掩码的变体时也会如此。
2.4.6.1. 分块空间加载与存储
使用分块空间加载时,会创建一个视图对象,指定如何将数组划分为由分块大小的区域构成的网格。这种映射称为分块空间,分块核函数可以使用分块空间索引,每次加载或存储一个区域。
分块空间加载这一概念的核心是数组的分块视图,它指定数组元素如何映射到指定大小的分块。图 19中所示的分块视图是一种分区视图,即由指定大小的互不重叠分块构成的分块空间,分块之间没有间隙。
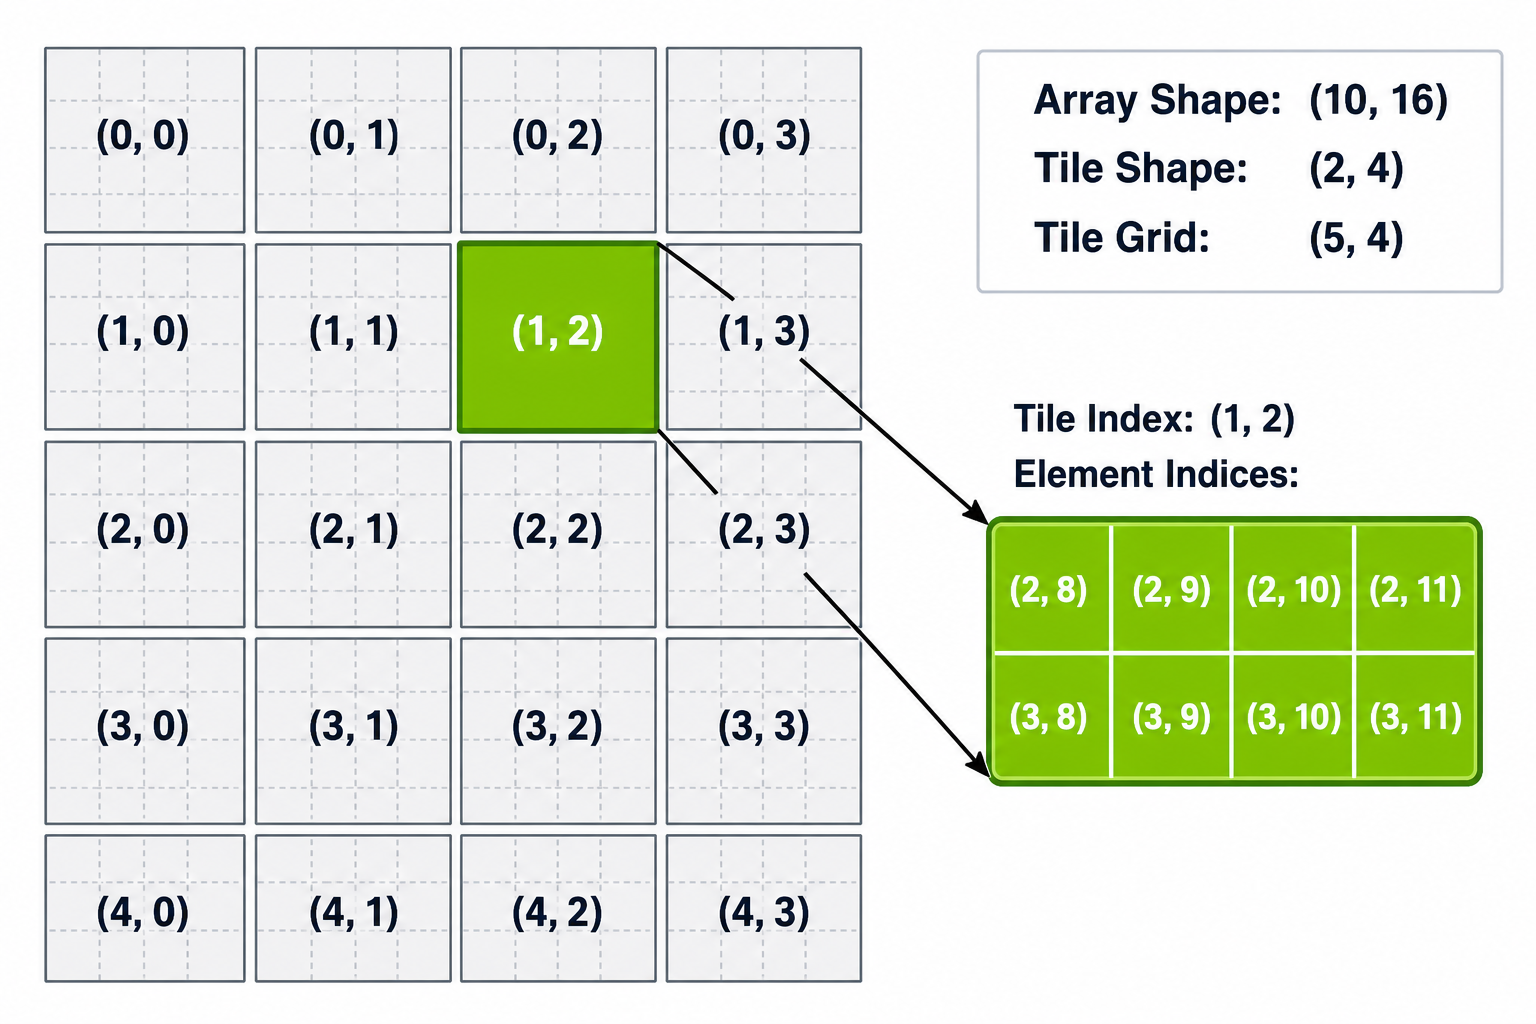
图 19 分区视图的分块空间索引。将形状为(10, 16)的二维数组划分为形状为(2, 4)的分块,生成形状为(5, 4)的分块网格。每个单元格显示其分块空间索引(i, j)。分块空间索引(1, 2)处突出显示的区域涵盖从(2, 8)到(3, 11)的元素索引。
图内文字中文对照
Array Shape: (10,16)- 数组形状:(10,16)
Tile Shape: (2,4)- 分块形状:(2,4)
Tile Grid: (5,4)- 分块网格:(5,4)
Tile Index: (1,2)- 分块索引:(1,2)
Element Indices:- 元素索引:
当数组的各维度不能被完整地划分为分块时,在一个或多个维度上跨越数组边界的分块将仅被部分填充。程序员可以指定加载这些分块时的行为,第 2.4.6.1.3 节将对此进行介绍。
分区视图是可以在数组上定义的多种分块空间之一。两种语言还都提供了另外两种分块空间:
以步幅间隔排列的固定形状数据块,因此这些数据块之间可能留有间隙,也可能相互重叠。C++ 中将其写作
ct::strided_view;Python 则向Array.tiled_view传递traversal_steps参数。通过一个元素索引分块沿某一维度选择的数据块,用于聚集与散布中介绍的不规则访问模式。C++ 中将其写作
ct::gather_scatter_view;Python 使用ct.load_advanced_indexing和ct.store_advanced_indexing。
分区视图是本章演示的唯一一种分块空间,也是Array.tiled_view默认生成的分块空间。有关其他分块空间,请参阅各语言的 API 参考(CUDA Tile C++ API 参考、cuTile Python 分块视图和高级索引)。
2.4.6.1.1. 分区视图加载与存储
结构化的分块空间加载是在全局内存与分块之间移动数据的首选方式。核函数必须首先构建一个定义分块空间的视图对象,然后根据分块空间索引,每次加载或存储一个分块。
在 C++ 中,分区视图分两个步骤构建:
ct::tensor_span:将原始指针与ct::extents配对,为该指针赋予多维结构。ct::partition_view:将 span 划分为由固定大小的分块构成的网格,并提供在分块空间坐标中操作的.load(idx...)/.store(tile, idx...)方法。
在 Python 中,Array.tiled_view(tile_shape)返回一个TiledView,将数组划分为给定形状的分块。该视图提供接受分块空间索引的.load(index) / .store(index, tile)方法,与 C++ 的partition_view直接对应。
注意
本章中的 C++ 示例代码使用__restrict__标注指针参数,并在核函数体靠近开头的位置调用ct::assume_aligned(ptr, 16_ic)。这些都是重要的性能标注,第 2.4.12 节将进一步介绍。数值字面量(例如128_ic、8_ic)上的_ic后缀将其标记为编译期常量,如编译期常量中所介绍的那样。
__tile_global__ void vec_add(float* __restrict__ a, float* __restrict__ b, float* __restrict__ out) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;

    a   = ct::assume_aligned(a,   16_ic);
    b   = ct::assume_aligned(b,   16_ic);
    out = ct::assume_aligned(out, 16_ic);

    // Step 1: attach a shape to each raw pointer. 128_ic marks 128 as a compile-time constant.
    auto aSpan = ct::tensor_span{a,   ct::extents{128_ic}};
    auto bSpan = ct::tensor_span{b,   ct::extents{128_ic}};
    auto oSpan = ct::tensor_span{out, ct::extents{128_ic}};

    // Step 2: partition each span into a tile space of fixed 8-element tiles.
    auto aView = ct::partition_view{aSpan, ct::shape{8_ic}};
    auto bView = ct::partition_view{bSpan, ct::shape{8_ic}};
    auto oView = ct::partition_view{oSpan, ct::shape{8_ic}};

    int  bx    = ct::bid().x;             // this block's tile-space index along .x
    auto aTile = aView.load(bx);          // pick the bx-th tile of a
    auto bTile = bView.load(bx);
    oView.store(aTile + bTile, bx);       // write the tile back at the bx-th position of out
}
@ct.kernel
def vec_add(a, b, c, TILE: ct.Constant[int]):
    a_view = a.tiled_view((TILE,))
    b_view = b.tiled_view((TILE,))
    c_view = c.tiled_view((TILE,))

    bid = ct.bid(0)
    a_tile = a_view.load((bid,))
    b_tile = b_view.load((bid,))
    c_view.store((bid,), a_tile + b_tile)
2.4.6.1.2. Python 单次调用加载与存储
Python 还提供了一种单次调用形式,在每次加载和存储时直接传入分块形状,而无需显式的视图对象。ct.load(array, index, shape)在给定的分块空间索引处读取给定形状的分块。ct.store(array, index, tile)是相应的写入操作。
ct.load/ct.store和Array.tiled_view表达的是相同的分块空间访问模式。区别在于分块形状在何处指定。使用Array.tiled_view时,分块形状一次性绑定到视图对象。使用ct.load/ct.store时,则在每次调用中直接提供分块形状。当多次加载和存储复用同一种划分时,首选使用tiled_view。当单次独立加载这样写更简洁时,使用ct.load/ct.store。
@ct.kernel
def vec_add(a, b, c, TILE: ct.Constant[int]):
    bid = ct.bid(0)                                    # this block's tile-space index along axis 0
    a_tile = ct.load(a, index=(bid,), shape=(TILE,))   # (index, shape) = pick the bid-th TILE-sized region of a
    b_tile = ct.load(b, index=(bid,), shape=(TILE,))
    ct.store(c, index=(bid,), tile=a_tile + b_tile)    # write the tile back to the bid-th region of c
2.4.6.1.3. 分块空间边界处理
在 C++ 中,partition_view提供不带掩码和带掩码的变体:
.load(idx...)/.store(tile, idx...)假定分块完全位于边界内。部分越界访问属于未定义行为。.load_masked(idx...)/.store_masked(tile, idx...)能够安全地处理边缘处的不完整分块。.load_masked()默认用零填充越界位置;也可以选择其他填充模式(例如为浮点分块填充 NaN)。.store_masked()会静默丢弃越界写入。
当数组能够按分块大小完整划分时,首选使用不带掩码的加载和存储变体。当必须处理边界条件时,即使对于完全填满的分块,也可以使用带掩码的变体。
这也是本指南中第一个将数组维度设为运行时值的 C++ 示例。ct::extents{N}接受运行时维度,ct::extents支持编译期值(_ic)和运行时值的任意混合,因此 span 和分区视图可以封装直到核函数启动时才知道大小的数组。
在 Python 中,ct.load接受一个padding_mode参数,用于控制越界元素获得的值。两种常用模式是:
PaddingMode.UNDETERMINED(默认值):越界元素的值由实现决定。仍然会对分块进行边界检查,因此加载操作绝不会读取数组之外的内存;只有越界通道获得的值是未指定的。这适用于永远不会读取越界通道的情况。PaddingMode.ZERO:越界元素用零填充。
对于存储操作,ct.store不需要padding_mode参数:默认情况下,它根据数组对分块进行边界检查,并静默丢弃对越界位置的写入。相同的规则也适用于tiled_view,它在创建视图时便固定了其padding_mode。
ct.load和ct.store还接受check_bounds,其默认值为True。padding_mode决定越界通道包含什么,而check_bounds则决定是否进行边界检查:使用check_bounds=False时,超出数组范围的访问属于未定义行为,会读取或覆盖相邻内存。它是上面不带掩码的 C++ .load() / .store()在 Python 中的对应形式,适用相同的使用指导。TiledView.load和TiledView.store接受同一个关键字。
__tile_global__ void edge_safe(float* __restrict__ in, float* __restrict__ out, int N) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;

    in  = ct::assume_aligned(in,  16_ic);
    out = ct::assume_aligned(out, 16_ic);

    // ct::extents{N} uses a runtime dimension; 128_ic stays compile-time.
    auto inView  = ct::partition_view{ct::tensor_span{in,  ct::extents{N}}, ct::shape{128_ic}};
    auto outView = ct::partition_view{ct::tensor_span{out, ct::extents{N}}, ct::shape{128_ic}};

    int  bx   = ct::bid().x;
    auto tile = inView.load_masked(bx);    // masked load: OOB lanes default to 0
    outView.store_masked(tile, bx);        // masked store: OOB writes silently discarded
}
@ct.kernel
def edge_safe(arr_in, arr_out, TILE: ct.Constant[int]):
    bid = ct.bid(0)
    tile = ct.load(arr_in, index=(bid,), shape=(TILE,),
                   padding_mode=ct.PaddingMode.ZERO)   # OOB lanes of a partial edge tile become 0
    ct.store(arr_out, index=(bid,), tile=tile)         # OOB writes are silently discarded
在 C++ 核函数内部,.load_masked()和.store_masked()负责处理边缘处的不完整分块。在 Python 核函数内部,加载操作上的PaddingMode.ZERO确保边缘处的不完整分块用零填充,而ct.store使用其默认的边界检查,静默丢弃超出数组边界的写入。有关完整的填充模式、掩码选项和填充值,请参阅各语言的 API 参考(CUDA Tile C++ 视图填充、cuTile Python 填充模式)。
从完全位于数组之外的分块加载,或向这样的分块存储,其行为是未定义的。这里讨论的边界处理仅适用于在一个或多个维度上部分越界的分块。
2.4.6.2. 聚集与散布
分块空间加载与存储中的分块空间加载使用了分区视图,它定义了对数组的一种规则的、按块对齐的划分。当访问模式不规则或依赖于数据时,例如查找表或置换,聚集和散布操作允许从数组的非均匀且非连续元素加载分块,以及将分块存储到这些元素。.. 通过任意索引或地址。
聚集和散布操作在 C++ 和 Python 中的形式略有不同:
Python 使用传递给
ct.gather()/ct.scatter()的整数索引分块,并内置边界检查。C++ 使用传递给
ct::load()/ct::store()的指针分块,其带掩码的变体ct::load_masked()和ct::store_masked()接受一个布尔掩码分块,用于处理数组边界处的分块。
在 C++ 中,聚集和散布的工作方式是构造一个指针分块,每个元素对应一个指针,然后将该指针分块传递给ct::load()或ct::store()。标量指针与整数分块之间的算术运算按元素执行,生成一个指针分块。这是在 C++ 中构造聚集/散布索引分块的标准惯用法。
在 Python 中,ct.gather加载索引分块中每个索引处的元素。边界检查默认启用:越界索引返回填充值(默认为零,可通过padding_value=配置),可以使用check_bounds=False禁用边界检查。ct.scatter在每个索引处存储一个值;越界写入会被静默丢弃,check_bounds=False在这里同样适用。
__tile_global__ void vec_add_gather(int* __restrict__ a, int* __restrict__ b, int* __restrict__ out) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;
    using i32x8 = ct::tile<int, ct::shape<8>>;

    a   = ct::assume_aligned(a,   16_ic);
    b   = ct::assume_aligned(b,   16_ic);
    out = ct::assume_aligned(out, 16_ic);

    int bx       = ct::bid().x;
    auto offsets = 8 * bx + ct::iota<i32x8>();   // element-level offsets, one per lane

    // scalar pointer + int tile = tile of pointers (one pointer per offset).
    auto aPtrs = a + offsets;
    auto bPtrs = b + offsets;

    auto aTile = ct::load(aPtrs);                // gather: one load per pointer
    auto bTile = ct::load(bPtrs);
    ct::store(out + offsets, aTile + bTile);     // scatter: one store per pointer
}
@ct.kernel
def vec_add_gather(a, b, c, TILE: ct.Constant[int]):
    bid = ct.bid(0)
    indices = bid * TILE + ct.arange(TILE, dtype=ct.int32)   # one element index per lane

    a_tile = ct.gather(a, indices)                           # load a[indices[i]] per lane
    b_tile = ct.gather(b, indices)
    ct.scatter(c, indices, a_tile + b_tile)                  # store one value per index into c
2.4.6.2.1. 聚集与散布的边界处理
聚集与散布中介绍的聚集/散布操作的边界处理遵循不同的规则。
在 Python 中,ct.gather和ct.scatter默认保证边界安全。越界读取返回填充值(默认为零),越界写入则被静默丢弃。当你能够证明每个索引都在范围内时,可以禁用边界检查;这样做会使越界访问成为未定义行为。有关可选的掩码和填充值设置,请参阅 API 参考(CUDA Tile C++ 加载操作、cuTile Python 加载/存储操作)。
在 C++ 中,边界检查不是自动进行的。程序员构造一个布尔掩码(例如,将偏移量与数组长度进行比较),然后将其传递给ct::load_masked或ct::store_masked:
__tile_global__ void gather_safe(int* __restrict__ arr, int* __restrict__ out, int N) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;
    using i32x8 = ct::tile<int, ct::shape<8>>;

    arr = ct::assume_aligned(arr, 16_ic);
    out = ct::assume_aligned(out, 16_ic);

    int bx       = ct::bid().x;
    auto offsets = 8 * bx + ct::iota<i32x8>();   // element-level offsets, one per lane
    auto mask    = offsets < N;                  // boolean tile: true where the offset is in-bounds

    auto ptrs = arr + offsets;                   // tile of pointers, one per offset
    auto tile = ct::load_masked(ptrs, mask, 0);  // masked lanes get the pad value 0
    ct::store_masked(out + offsets, tile, mask); // masked lanes are skipped on the store
}
2.4.7. 控制流
从程序员的角度来看,分块核函数的每个块都遵循单一的控制流路径。条件和循环边界中的标量值驱动控制流,而主体中的分块操作则由编译器分配给各个硬件线程。
并非所有控制流结构都受支持。例如,分块代码中不允许从循环内部返回。有关完整的限制列表,请参阅各语言的 API 参考(CUDA Tile C++ 一般原则、cuTile Python 控制流)。
2.4.7.1. 循环
一种常见模式是遍历数组中的分块,依次处理每个分块。
在 C++ 中,ct::irange是一个前向范围,表示从下界开始、到上界但不包含上界的递增整数序列,序列中的整数按可选的步长间隔排列。使用ct::irange可以向编译器提供关于迭代边界的结构化信息,这些信息可用于更好地优化生成的代码。要使该优化生效,循环变量必须通过遍历ct::irange的基于范围的 for 表达式进行绑定。
在 Python 中,分块代码支持内置的range()、for、while以及嵌套循环。
步长参数必须严格大于零;不支持负步长范围。
以下单块核函数对一维数组的所有分块求和:
__tile_global__ void tile_sum(float* __restrict__ arr, float* __restrict__ out, int num_tiles) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;
    using f32x8 = ct::tile<float, ct::shape<8>>;

    arr = ct::assume_aligned(arr, 16_ic);
    out = ct::assume_aligned(out, 16_ic);

    auto inView  = ct::partition_view{ct::tensor_span{arr, ct::extents{8 * num_tiles}},
                                      ct::shape{8_ic}};
    auto outView = ct::partition_view{ct::tensor_span{out, ct::extents{8_ic}},
                                      ct::shape{8_ic}};

    auto acc = ct::full<f32x8>(0.0f);
    // range-for over ct::irange gives the compiler structured iteration bounds.
    for (auto k : ct::irange(0, num_tiles)) {
        auto tile = inView.load(k);
        acc = acc + tile;                               // accumulate the k-th tile into acc
    }
    outView.store(acc, 0);                              // write the final result as the 0-th tile of out
}
@ct.kernel
def tile_sum(arr, out, TILE: ct.Constant[int], N_TILES: ct.Constant[int]):
    # Intended grid: (1,) -- a single block sums all tiles of arr.
    acc = ct.zeros((TILE,), dtype=ct.float32)
    for k in range(N_TILES):                            # range() works natively in tile code
        tile = ct.load(arr, index=(k,), shape=(TILE,))
        acc = acc + tile                                # accumulate the k-th tile into acc
    ct.store(out, index=(0,), tile=acc)                 # write the final result as the 0-th tile of out
2.4.7.2. 条件语句
标准的if/else条件语句可以正常工作。由于每个块都遵循单一的控制流路径,关于线程束内分支分歧的注意事项不适用于分块核函数。
__tile_global__ void conditional_load(float* __restrict__ arr, float* __restrict__ out, int N) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;
    using f32x8 = ct::tile<float, ct::shape<8>>;

    arr = ct::assume_aligned(arr, 16_ic);
    out = ct::assume_aligned(out, 16_ic);

    auto inView  = ct::partition_view{ct::tensor_span{arr, ct::extents{N}}, ct::shape{8_ic}};
    auto outView = ct::partition_view{ct::tensor_span{out, ct::extents{N}}, ct::shape{8_ic}};

    int bx   = ct::bid().x;
    int nb_x = ct::num_blocks().x;

    auto tile = ct::full<f32x8>(0.0f);    // default for the last-block branch
    // Scalar condition -> one control-flow path per block; no divergence to reason about.
    if (bx < nb_x - 1) {
        tile = inView.load(bx);           // all blocks except the last
    }
    outView.store_masked(tile, bx);       // masked to handle a potentially partial final tile
}
@ct.kernel
def conditional_load(arr, out, TILE: ct.Constant[int]):
    bid = ct.bid(0)
    # Scalar condition -> one control-flow path per block; no divergence to reason about.
    if bid < ct.num_blocks(0) - 1:
        tile = ct.load(arr, index=(bid,), shape=(TILE,))    # all blocks except the last
    else:
        tile = ct.zeros((TILE,), dtype=ct.float32)          # last block: emit zeros
    ct.store(out, index=(bid,), tile=tile)
2.4.8. 逐元素算术运算与广播
分块支持标准的逐元素算术运算。当两个操作数的形状兼容但不同时,在执行运算之前,会将较小的操作数广播到匹配的形状。
2.4.8.1. 广播
广播遵循 NumPy 语义:标量会复制到整个分块,单例维度(长度为 1)会扩展以匹配另一个操作数的对应维度,而秩较低的操作数会将缺失的前导维度视为单例维度,从而与秩较高的操作数的尾部维度对齐。如果两个对应维度都不是单例维度且大小不相等,则该操作不符合规则。
下面的示例在一次加法中同时运用了单例维度扩展和秩提升:将形状为 8x2 的秩为 2 的分块提升为 1x8x2,然后与形状为 4x1x2 的秩为 3 的分块一起广播到共同的形状 4x8x2。
auto x = ct::iota<ct::tile<int, ct::shape<8, 2>>>();      // 8x2   (rank 2)
auto y = ct::iota<ct::tile<int, ct::shape<4, 1, 2>>>();   // 4x1x2 (rank 3)
auto z = x + y;                                           // x promoted to 1x8x2, then broadcasts to 4x8x2
x = ct.full((8, 2),    3, dtype=ct.int32)   # 8x2   (rank 2)
y = ct.full((4, 1, 2), 5, dtype=ct.int32)   # 4x1x2 (rank 3)
z = x + y                                    # x promoted to 1x8x2, then broadcasts to 4x8x2
2.4.8.2. 算术运算符
所有受支持的算术运算符都按元素作用于分块,并生成具有广播后形状的新分块。标量与分块一起运算时,标量会广播到每个元素。当操作数类型不同时,优先选择能够保留更多信息的类型:
分块与分块一起运算:结果是一个分块,其类型具有更高的精度或更大的范围。例如:
int + float得到floatint16 + int32得到int32
标量与分块一起运算:当标量的类型能够由分块的元素类型精确表示时(例如,整数字面量
2与int分块一起运算,或2.0f与float分块一起运算),运算以分块的元素类型进行。当标量必须经过窄化才能适应分块的元素类型时(例如,字面量2.5与int分块一起运算),两种语言的行为有所不同:Python 将结果提升为能够容纳两者的类型
C++ 将该表达式视为不符合规则并予以拒绝
下面的代码片段说明了两种语言在标量与分块一起运算时存在差异的情况:
using i32x8 = ct::tile<int, ct::shape<8>>;
i32x8 x = ct::full<i32x8>(3);

x + 2;       // OK - int literal matches int tile element type
x + 2.5;     // ill-formed - 2.5 would narrow to int
x = ct.full((8,), 3, dtype=ct.int32)

x + 2          # int32 - int literal matches int32 tile dtype
x + 2.5        # float32 - result promoted to hold both
在实践中,应尽可能以分块的元素类型编写标量字面量,并在需要不同精度时进行显式转换。当核函数内部的操作数是加载的分块时,同样的规则也适用:
__tile_global__ void elementwise(float* __restrict__ a, float* __restrict__ b, float* __restrict__ out, int N) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;

    a   = ct::assume_aligned(a,   16_ic);
    b   = ct::assume_aligned(b,   16_ic);
    out = ct::assume_aligned(out, 16_ic);

    auto aView = ct::partition_view{ct::tensor_span{a,   ct::extents{N}}, ct::shape{8_ic}};
    auto bView = ct::partition_view{ct::tensor_span{b,   ct::extents{N}}, ct::shape{8_ic}};
    auto cView = ct::partition_view{ct::tensor_span{out, ct::extents{N}}, ct::shape{8_ic}};

    int  bx = ct::bid().x;
    auto x  = aView.load(bx);
    auto y  = bView.load(bx);
    // 2.0f matches the float tiles' element type, so no narrowing conversion is required.
    // The scalar is broadcast across every element; + then runs elementwise.
    auto z  = 2.0f * x + y;
    cView.store(z, bx);
}
@ct.kernel
def elementwise(a, b, c, TILE: ct.Constant[int]):
    bid = ct.bid(0)
    x = ct.load(a, index=(bid,), shape=(TILE,))
    y = ct.load(b, index=(bid,), shape=(TILE,))
    # 2.0 is a loosely typed float constant; with float tiles, the result stays float.
    # Scalars are broadcast across every element of the tile, then + runs elementwise.
    z = 2.0 * x + y
    ct.store(c, index=(bid,), tile=z)
当你需要显式控制舍入模式或次正规数处理时,CUDA Tile API 提供了显式开放这些选项的数学函数,既用于逐元素算术运算(例如ct.add、ct::add),也用于超越函数(例如exp和tanh)。
2.4.9. 分块原语
工厂函数(创建分块)、加载和存储(分块空间加载和存储)以及逐元素算术运算(逐元素算术运算与广播)都是分块原语,即语言组成部分中的操作。程序员以分块为粒度编写这些操作,编译器则将其映射到硬件,包括可用的张量核心。本节介绍 CUDA tile 中可用的其他原语。
2.4.9.1. 矩阵乘法
两个分块的矩阵乘法是实现两个数组之间矩阵乘法的基本操作。CUDA Tile 提供两种形式的分块间矩阵乘法:纯矩阵乘法(matmul)a @ b,以及矩阵乘累加(mma)a @ b + acc。在 mma 中,累加器将部分乘积从一个 K 分块传递到下一个 K 分块。这有助于分块矩阵乘法的内层循环。matmul和mma都支持二维矩阵乘法和三维批量乘法,也支持混合使用不同数据类型(精度)的操作数和累加器。这些操作的 API 参考文档(CUDA Tile C++ 矩阵乘法、cuTile Python matmul)中记录了秩和元素类型的约束。
下面的核函数采用了一种常见模式:无论输入精度如何,都以 FP32 进行累加,并在存储时转换为输出元素类型。在 Python 中,这使用ct.mma(a, b, acc),并配合 FP32 类型的acc。在 C++ 中,这使用ct::mma(a, b, acc),并显式指定 FP32 累加器类型。K 循环迭代ceil(K / tk)次,以覆盖 A 的右边缘和 B 的下边缘;不完整的 K 分块在加载时用零填充(Python 中为PaddingMode.ZERO,C++ 中为.load_masked()),C 一侧不完整的 M/N 边缘分块则通过存储侧丢弃越界(OOB)元素来处理(Python 中为ct.store,C++ 中为.store_masked())。
__tile_global__ void gemm(const __half* __restrict__ A, const __half* __restrict__ B, float* __restrict__ C,
                          std::size_t M, std::size_t K, std::size_t N) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;
    using f32_acc = ct::tile<float, ct::shape<32, 32>>;

    A = ct::assume_aligned(A, 16_ic);
    B = ct::assume_aligned(B, 16_ic);
    C = ct::assume_aligned(C, 16_ic);

    constexpr auto tm = 32_ic;
    constexpr auto tn = 32_ic;
    constexpr auto tk = 16_ic;

    auto aView = ct::partition_view{ct::tensor_span{A, ct::extents{M, K}}, ct::shape{tm, tk}};
    auto bView = ct::partition_view{ct::tensor_span{B, ct::extents{K, N}}, ct::shape{tk, tn}};
    auto cView = ct::partition_view{ct::tensor_span{C, ct::extents{M, N}}, ct::shape{tm, tn}};

    auto [bx, by, bz] = ct::bid();
    auto acc = ct::full<f32_acc>(0.0f);                 // FP32 accumulator

    std::size_t num_k = (K + tk - 1) / tk;
    for (auto k : ct::irange(std::size_t{0}, num_k)) {
        acc = ct::mma(aView.load_masked(bx, k),         // zero-pad partial K-tile
                      bView.load_masked(k, by),
                      acc);                             // acc += a @ b
    }
    cView.store_masked(acc, bx, by);                    // drop OOB edge lanes
}
@ct.kernel
def gemm(A, B, C,
         tm: ct.Constant[int], tn: ct.Constant[int], tk: ct.Constant[int]):
    bx, by = ct.bid(0), ct.bid(1)
    num_k  = ct.num_tiles(A, axis=1, shape=(tm, tk))    # number of K-tiles

    acc = ct.full((tm, tn), 0, dtype=ct.float32)        # FP32 accumulator
    for k in range(num_k):
        a = ct.load(A, index=(bx, k), shape=(tm, tk),
                    padding_mode=ct.PaddingMode.ZERO)   # zero-pad partial K-tile
        b = ct.load(B, index=(k, by), shape=(tk, tn),
                    padding_mode=ct.PaddingMode.ZERO)
        acc = ct.mma(a, b, acc)                         # acc += a @ b

    ct.store(C, index=(bx, by), tile=acc.astype(C.dtype))  # cast + store
2.4.9.2. 归约与扫描
归约是将分块折叠成标量或一行标量的工具。计算 softmax 的分母、层归一化的均值和方差,或注意力评分中的最大值,都涉及归约操作。
首先需要牢记的一点是结果的形状。Python 默认移除被归约的轴(传入keepdims=True可将其保留为长度 1);C++ 则始终保留该轴,从而保持分块的秩。下面的两个代码片段都沿轴 1 对一个 2×4 分块进行归约;输出形状是二者的明显区别。
using namespace ct::literals;
using i32x2x4 = ct::tile<int, ct::shape<2, 4>>;

auto x = ct::iota<i32x2x4>();                         // [[0,1,2,3],[4,5,6,7]]
auto row_sums = ct::sum(x, 1_ic);                     // shape (2, 1) - axis kept
// row_sums == [[6], [22]]
x   = ct.arange(8, dtype=ct.int32).reshape((2, 4))    # [[0,1,2,3],[4,5,6,7]]
s   = ct.sum(x, axis=1)                               # shape (2,)    - axis dropped
s_k = ct.sum(x, axis=1, keepdims=True)                # shape (2, 1)  - axis kept
# s == [6, 22];  s_k == [[6], [22]]
扫描是与归约对应的逐步累积操作,它沿某一轴生成累积结果。例如,前缀和(cumsum)生成的输出与输入维度相同,其中给定索引处的值是沿指定轴从起点到该索引(包含该索引)处所有元素之和。有关每种语言中可用操作的完整集合,请参阅 API 参考文档(CUDA Tile C++ 归约与扫描、cuTile Python 归约和扫描)。
2.4.9.3. 转置与置换
两个相关原语可以在不触及分块数据的情况下重新排列其轴:transpose交换前两个轴,permute则进行任意重排。凡是需要在操作之间改变分块逻辑布局的地方,都会用到它们,例如将 matmul 操作数的转置具体化、在注意力块中交换行和列,或在广播前对齐各轴。
在 Python 中,对秩为 2 的分块使用ct.transpose(x)会交换其两个轴;对更高秩的分块使用时,则需要显式的axis0/axis1参数。ct.permute(x, axes)接受一个轴索引元组。在 C++ 中,ct::transpose(x)交换前两个维度(保留后续维度),ct::permute(x, map)则接受一个描述新顺序的ct::dimension_map。
using namespace ct::literals;
using t2d = ct::tile<int, ct::shape<2, 4>>;
using t3d = ct::tile<int, ct::shape<2, 2, 2>>;

auto tx = ct::iota<t2d>();
auto ty = ct::transpose(tx);                                     // shape (4, 2)

auto tz = ct::iota<t3d>();
auto tw = ct::permute(tz, ct::dimension_map{2_ic, 0_ic, 1_ic});  // axes (0,1,2) -> (2,0,1)
tx = ct.arange(8, dtype=ct.int32).reshape((2, 4))
ty = ct.transpose(tx)                                            # shape (4, 2)

tz = ct.arange(8, dtype=ct.int32).reshape((2, 2, 2))
tw = ct.permute(tz, (2, 0, 1))                                   # axes (0,1,2) -> (2,0,1)
2.4.9.4. 逐元素选择
逐元素选择是条件判断的分块形式:给定一个布尔分块和两个操作数分块,根据相应的布尔值,从其中一个操作数分块选取每个输出元素。条件会广播到操作数的形状;操作数类型必须兼容(有关各语言中的确切规则,请参阅 API 参考文档:CUDA Tile C++ select、cuTile Python 选择)。在 Python 中写作ct.where(cond, x, y);在 C++ 中写作ct::select(cond, lhs, rhs)。
using namespace ct::literals;
auto cond = ct::iota<ct::tile<int, ct::shape<4>>>() < 2;   // {T, T, F, F}
auto t    = ct::full<ct::tile<float, ct::shape<4>>>( 1.0f);
auto f    = ct::full<ct::tile<float, ct::shape<4>>>(-1.0f);
auto r    = ct::select(cond, t, f);                        // {1, 1, -1, -1}
cond    = ct.arange(4, dtype=ct.int32) < 2                 # [T, T, F, F]
x_true  = ct.full((4,),  1.0, dtype=ct.float32)
x_false = ct.full((4,), -1.0, dtype=ct.float32)
result  = ct.where(cond, x_true, x_false)                  # [1, 1, -1, -1]
2.4.9.5. 数学函数
在分块代码中,常见的逐元素数学运算以ct命名空间中的函数形式提供:
add,sub,multruediv,floordiv,cdivmodpowexp,exp2,log,log2sqrt,rsqrtsin,cos,tansinh,cosh,tanhminimum,maximumnegativefloor,ceil
每个函数都对输入分块逐元素应用其运算,并返回形状相同的分块。这些运算也适用于分块代码中的标量。
有关确切细节以及所支持的逐元素运算的完整列表,请参阅 API 参考文档:
2.4.10. 原子内存操作
在分块代码中,有两种情况需要使用内存原子操作:
在块间争用中,每个块生成一个部分结果,并使用原子操作,在某个全局内存位置将其与其他块的部分结果合并。
在块内争用中,分块的多个元素被写入内存中的同一位置。
对分块执行原子操作会对分块的每个元素执行一次原子更新。逐元素操作是原子的,但整个调用并不是。逐元素原子操作的执行顺序未作规定。
在 Python 中,原子操作通过数组索引定位目标,所用约定与ct.gather和ct.scatter相同。可选参数控制边界检查、内存顺序和线程作用域。默认设置(启用边界检查、ACQ_REL、设备作用域)使普通调用只需传入数组、索引和更新值。TiledView还以实例方法的形式提供归约式原子操作,这些方法以atomic_store_为名称前缀(例如TiledView.atomic_store_add(index, update));它们通过分块空间索引定位目标,不返回值,并转换为 PTX 中的原子归约。当不需要原先的值时,应优先使用TiledView形式,以获得更好的性能。
在 C++ 中,原子操作接受指针及其对应的值:对于单个位置,接受原始指针和标量;或者接受指针分块和值分块。内存顺序是在调用点指定的编译期类型标签,例如ct::memory_order_relaxed_t{}。线程作用域是相同形式的类型标签,省略时默认为系统范围可见。
ct::partition_view和ct::strided_view还以成员函数的形式提供归约原子操作(atomic_add、atomic_sub、atomic_and、atomic_or、atomic_xor、atomic_max和atomic_min)。它们通过分块空间索引而非指针定位目标,并且与.store()一样,先接受值分块,最后接受索引。与返回内存中原先的值的自由函数不同,它们不返回任何值。与 Python 中一样,当不需要原先的值时,应优先使用它们:成员形式会转换为硬件归约,而指针分块形式则会转换为每个元素一次原子操作。ct::gather_scatter_view不提供这些操作。
2.4.10.1. 块间争用
在下面的代码示例中,由于不同的块写入同一内存位置out,因此会发生块间争用。如果没有原子操作,并行运行的块会导致错误的结果。本例使用设备线程作用域(C++ 中为ct::thread_scope_device_t{},Python 中线程作用域默认为设备范围),因为内存操作的结果必须对设备上运行的所有块可见。Python 核函数使用TiledView.atomic_store_add,因为每个块的部分和都累加到out[0]中,随后立即丢弃。
__tile_global__ void block_sum(int* __restrict__ arr, int* __restrict__ out, std::size_t N) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;
    constexpr auto TILE = 16_ic;

    arr = ct::assume_aligned(arr, 16_ic);
    out = ct::assume_aligned(out, 16_ic);

    auto aView = ct::partition_view{ct::tensor_span{arr, ct::extents{N}},
                                    ct::shape{TILE}};
    int bid = ct::bid().x;
    auto tile    = aView.load_masked(bid);        // partial final tile -> OOB lanes default to 0
    auto partial = ct::sum(tile, 0_ic);           // reduce to a 1-element tile

    ct::atomic_add(out, (int)partial,             // accumulate the scalar into out[0]
                   ct::memory_order_relaxed_t{},  // single-location accumulator -> relaxed suffices
                   ct::thread_scope_device_t{});  // visible across the device
}
@ct.kernel
def block_sum(arr, out, TILE: ct.Constant[int]):
    bid = ct.bid(0)
    # partial final tile -> OOB lanes default to 0
    tile    = ct.load(arr, index=(bid,), shape=(TILE,),
                      padding_mode=ct.PaddingMode.ZERO)
    partial = ct.sum(tile)                               # reduce to a scalar
    out.tiled_view((1,)).atomic_store_add((0,), partial)  # atomically accumulate into out[0]
2.4.10.2. 块内争用
在下面的代码片段中,由于分块的所有值都以原子方式加到内存中的单个位置,因此会发生块内争用。
在本例中,ptrs分块中的每个元素都指向内存中的同一位置slot。由ct::iota<i32x16>()创建的分块中的每个元素,都会以原子方式加到该内存位置中存储的值上。从一个分块对同一内存地址执行多个原子操作时,其执行顺序未作规定。使用块线程作用域ct::thread_scope_block_t{}来指定原子操作的结果只需在此线程块内可见。
using i32x16 = ct::tile<int, ct::shape<16>>;

int* slot = /* pointer to the contended location */;

// 16 lanes all aim at the same address. Add is commutative, so the
// unspecified ordering doesn't affect this sum; block scope suffices
// since contention stays within one block.
auto ptrs = ct::full<ct::tile<int*, ct::shape<16>>>(slot);
ct::atomic_add(ptrs, ct::iota<i32x16>(),
            ct::memory_order_relaxed_t{},
            ct::thread_scope_block_t{});
注意
这里仅作说明之用。若要在线程块内将一个分块求和为标量,应优先采用第 2.4.9.2 节所示的分块归约操作。
2.4.10.3. 支持的原子操作
分块代码支持多种原子内存操作,这些操作的区别在于如何将要写入的值与内存中已有的值相结合:
atomic_and:对传入的值与内存中的值逐元素执行原子按位与运算atomic_or:对传入的值与内存中的值逐元素执行原子按位或运算atomic_xor:对传入的值与内存中的值逐元素执行原子按位异或运算atomic_max:逐元素比较传入的值与内存中的值,并将较大的值存入内存atomic_min:逐元素比较传入的值与内存中的值,并将较小的值存入内存atomic_add:将传入的值加到内存中的值上,并将结果存入内存atomic_sub(仅限 C++):从内存中的值减去传入的值,并将结果存入内存atomic_xchg:将传入的值写入内存,并返回写入前内存中的值atomic_cas(C++ 中为atomic_compare_exchange):逐元素比较内存中的值与作为参数传入的预期值。如果两者匹配,则用所需的值替换内存中的值
有关所有受支持原子内存操作的完整文档,请参阅CUDA Tile C++ API 参考或cuTile Python API 参考中的内存操作章节。
2.4.11. 优化提示
优化提示是附加到源代码构造(分块核函数、加载/存储调用点等)的元数据,用于指导编译器的代码生成。提示不会改变程序的语义:无论是否有提示,核函数的编译和运行行为都相同,因此可以自由添加、移除或调整提示,而不影响正确性。编译器也可以忽略任何提示。
提示具有两个共同的一般属性:
提示针对各个构造单独生效。提示适用于其附加到的特定核函数或特定调用表达式,而不适用于周围的代码。
提示可以按架构指定。每个提示都可以针对不同的 GPU 架构设置不同的值,也可以设置为适用于所有目标的单一值。
两种语言提供提示的方式不同:
C++ 使用 C++ 属性,将其放在相关声明或语句上。
Python 在核函数装饰器以及各个内存操作调用点上使用关键字参数。
提示种类的集合,也就是每个提示实际控制的内容,在两种语言之间是共用的,具体记录在提示种类中。
2.4.11.1. C++:cutile::hint属性
在 C++ 中,提示通过 C++ 属性cutile::hint来表达:
[[ cutile::hint(arch, kind1=value1, kind2=value2, ...) ]]
第一个参数是目标架构,它采用与__CUDA_ARCH__宏相同的约定编码为整数(例如,sm_90对应900,sm_100对应1000)。特殊值0表示适用于所有目标架构的与架构无关的提示。其余每个参数都是一个kind=value对,用于指定提示种类及其值。
cutile::hint属性适用于其后紧接的构造:
对于分块核函数,将属性放在函数声明上。
对于
ct::load、ct::store和ct::partition_view加载/存储等内存操作,将其放在包含调用的表达式语句上。
其他放置位置存在限制;有关完整规则,请参阅CUDA Tile C++ 提示规范。
下面的核函数展示了这两种放置方式:核函数级提示为sm_90和sm_100设置不同的num_cta_in_cga,表达式语句提示则将某次特定加载标记为带宽需求高的操作。
[[ cutile::hint(900,  num_cta_in_cga=4),    // sm_90:  prefer 4 CTAs per cluster
   cutile::hint(1000, num_cta_in_cga=8) ]]  // sm_100: prefer 8 CTAs per cluster
__tile_global__ void optimization_hints(float* __restrict__ in,
                                        float* __restrict__ out) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;

    in  = ct::assume_aligned(in,  16_ic);
    out = ct::assume_aligned(out, 16_ic);

    auto inSpan  = ct::tensor_span{in,  ct::extents{128_ic}};
    auto outSpan = ct::tensor_span{out, ct::extents{128_ic}};
    auto inView  = ct::partition_view{inSpan,  ct::shape{8_ic}};
    auto outView = ct::partition_view{outSpan, ct::shape{8_ic}};

    int bx = ct::bid().x;

    // Expression-statement hint: tag this particular load as bandwidth-heavy.
    ct::tile<float, ct::shape<8>> tile;
    [[ cutile::hint(0, latency=8) ]]
    tile = inView.load(bx);

    outView.store(tile, bx);
}
当多个同种类的提示适用于同一构造时,特定架构的提示会覆盖与架构无关的提示。
2.4.11.2. Python:装饰器参数与调用点关键字
Python 通过两种方式提供提示:
核函数级提示是
@ct.kernel(...)装饰器的关键字参数。已编译的核函数对象还有一个.replace_hints(**hints)方法,该方法返回一个提示已被覆盖的新核函数;新核函数拥有自己的 JIT 缓存,因此replace_hints自然成为构建自动调优循环的基本组件。逐调用提示是内存操作调用点上的关键字参数:
ct.load/ct.store、TiledView.load/TiledView.store以及ct.gather/ct.scatter。
对于按架构指定的值,将值包装在cuda.tile.ByTarget(*, default=..., sm_XXX=..., sm_YYY=...)中。架构键必须是"sm_<major><minor>"形式的字符串(例如"sm_100"或"sm_120")。普通值(非ByTarget值)适用于所有目标,它在 Python 中等同于 C++ 中使用arch=0的与架构无关的提示。
下面的核函数是上面的 C++ 示例的直接 Python 对应版本:ByTarget携带核函数级提示,latency=8关键字携带逐调用提示,而replace_hints可在不编辑源代码的情况下生成重新调优的核函数。
@ct.kernel(num_ctas=ByTarget(sm_90=4, sm_100=8))
def optimization_hints(in_, out, TILE: ct.Constant[int]):
    bid = ct.bid(0)

    # Per-call hint: this particular load is bandwidth-heavy.
    tile = ct.load(in_, index=(bid,), shape=(TILE,), latency=8)

    ct.store(out, index=(bid,), tile=tile)


# Autotuning: produce a new kernel with overridden hints without editing the
# source. The new kernel has its own JIT cache.
tuned_kernel = optimization_hints.replace_hints(num_ctas=8)
2.4.11.3. 提示种类
以下提示在两种语言之间是共用的。对于每个提示,C++ 名称和Python 名称条目是同一个底层提示的不同写法;其他方面均相同:提示的适用位置、取值及含义。
2.4.11.3.1. 每个簇的 CTA 数量
C++ 名称:
num_cta_in_cga(核函数属性)。Python 名称:
num_ctas(@ct.kernel装饰器参数)。允许的值:
1、2、4、8、16。在sm_80上,仅1适用。含义:启动核函数时,编译器应优先为每个协作组数组(CGA)使用的协作线程数组(CTA)数量。
2.4.11.3.2. 占用率
C++ 名称:
occupancy(核函数属性)。Python 名称:
occupancy(@ct.kernel装饰器参数)。允许的值:包含端点的
[1, 32]范围内的任意整数。含义:每个流式多处理器(SM)上活跃 CTA 数量的目标值。编译器将该值视为建议,并会在代码生成期间尝试遵循它。
2.4.11.3.3. 内存访问延迟
C++ 名称:
latency(包含调用的表达式语句上的属性)。Python 名称:
latency(调用点上的关键字参数)。适用于:分块空间加载和存储(C++ 中为
ct::partition_view;Python 中为Array.tiled_view和ct.load/ct.store),以及聚集/散布(C++ 中为使用指针分块的ct::load/ct::store;Python 中为ct.gather/ct.scatter)。允许的值:包含端点的
[1, 10]范围内的任意整数,其中1表示较低的 DRAM 流量,10表示较高的流量。较大的值通常会使编译器安排更大的预取深度。
2.4.11.3.4. 允许 TMA
C++ 名称:
allow_tma(包含调用的表达式语句上的属性)。Python 名称:
allow_tma(调用点上的关键字参数)。适用于:仅适用于分块空间的加载和存储(C++ 中的
ct::partition_view;Python 中的Array.tiled_view以及ct.load/ct.store)。收集和散布操作不接受此提示。允许的值:
true/false(C++)或True/False(Python)。默认允许使用 TMA;将提示设置为false/False会指示编译器,即使在支持 TMA 的硬件上,也不要将这一特定的加载或存储转换为 TMA 操作。
2.4.12. C++ 性能提示
本指南中的 C++ 核函数均使用相同的少量注解和惯用写法。本节说明它们的作用及其重要性。
2.4.12.1. 对内存中的数组使用__restrict__指针
__restrict__关键字告知编译器,在指针的生存期内,通过该指针访问的内存区域将只通过该指针访问。请参阅第 5.4.1.4 节。
在分块 C++ 中,使用满足这些条件的内存数组,并用__restrict__关键字标记指向这些数组的指针,对于获得良好的内存操作性能至关重要。
要了解其中的原因,请考虑一个逐元素复制操作,该操作使用的数组指针未被标记为__restrict__:
__tile_global__ void tile_elementwise_copy(float* out, float const* in) {
    namespace ct = cuda::tiles;

    using f32x64 = ct::tile<float, ct::shape<64>>;
    using i32x64 = ct::tile<int, ct::shape<64>>;

    auto inPtrs  = in  + 64 * ct::bid().x + ct::iota<i32x64>();
    auto outPtrs = out + 64 * ct::bid().x + ct::iota<i32x64>();

    auto data = ct::load(inPtrs);   // (1)
    ct::store(outPtrs, data);       // (2)
}
在 CUDA Tile 程序中,通常可以忽略编译器如何并行化分块操作。不过,为了理解为什么使用不重叠的数组能让编译器生成性能更好的代码,我们将在此考察这一点。
考虑编译器将如何并行化load和store分块操作。如果输入数组与输出数组不重叠,load就可以并行化为一组独立的内存读取操作。同样,store可以并行化为多个内存写入操作,其中每个写入操作仅依赖于对它所写入的一个或多个数据元素的加载操作。
然而,如果输入数组和输出数组可能重叠,那么编译器就必须确保整个分块的所有内存加载操作均已完成,才能发出任何内存存储操作,以保证正确的程序语义。否则,存储操作可能会在某个元素被加载操作读取之前执行并覆盖该元素,导致程序执行不正确。这限制了编译器交错安排读取和写入的能力,因为在发出任何写入之前,所有读取都必须完成。
简而言之,当编译器无法保证数组互不重叠时,它必须生成更保守的代码。这就是为什么使用不重叠的数组,并在其指针上使用__restrict__关键字将这一点告知编译器,有助于实现最佳性能。
如果某个内存区域可通过另一个指针访问,却用__restrict__标记指向该区域的指针,将导致未定义行为。
2.4.12.2. 将数组指针标记为按 16 字节对齐
使用ct::assume_aligned将指向数组的指针标记为按 16 字节对齐:
__tile_global__ void foo(float* __restrict__ in) {
    namespace ct = cuda::tiles;
    using namespace ct::literals;

    in = ct::assume_aligned(in, 16_ic);

    ct::tensor_span t{in, ct::extents{256_ic, 256_ic}};
    ct::partition_view{t, ct::shape{4_ic, 4_ic}};

    // ...
}
这一对齐保证是ct::partition_view使用张量内存加速器(TMA)的必要条件。使用此方法时,必须在运行时提供按 16 字节对齐的指针,否则行为未定义。
由cudaMalloc等 CUDA 内存分配器返回的指针保证至少按 16 字节对齐。
2.4.12.3. 内存访问优先使用ct::partition_view
对于结构化内存访问,应优先使用ct::partition_view,而不是收集和散布形式ct::load和ct::store。基于视图的形式可以在支持的硬件上转换为张量内存加速器(TMA)操作,其速度明显快于逐元素收集。有关收集/散布的背景,请参阅收集和散布。
2.4.12.4. 对有界循环使用ct::irange
在固定范围内迭代时,使用ct::irange,而不是普通的for循环。这种结构化形式让编译器能够应用流水线化和向量化等优化,而当循环边界和步长是不透明的整数表达式时,这些优化无法应用(请参阅控制流):
for (auto idx : ct::irange(lowerBound, upperBound, step)) {
    // ...
}