1.2. 编程模型
本章从总体上介绍 CUDA 编程模型,且不依赖任何语言。此处介绍的术语和概念适用于以任何受支持的编程语言使用 CUDA 的情况。后续章节将使用 C++ 说明这些概念。
1.2.1. 异构系统
CUDA 编程模型假定使用异构计算系统,即同时包含 GPU 和 CPU 的系统。CPU 及与其直接连接的内存分别称为主机和主机内存。GPU 及与其直接连接的内存分别称为设备和设备内存。在某些片上系统(SoC)中,它们可能是同一封装的一部分。在更大的系统中,可能有多个 CPU 或 GPU。
CUDA 应用在 GPU 上执行部分代码,但应用始终从 CPU 上开始执行。主机代码,即在 CPU 上运行的代码,可以使用 CUDA API 在主机内存与设备内存之间复制数据、启动在 GPU 上执行的代码,以及等待数据复制或 GPU 代码执行完成。CPU 和 GPU 可以同时执行代码,通常通过最大化 CPU 和 GPU 两者的利用率来获得最佳性能。
应用在 GPU 上执行的代码称为设备代码,而被调用以在 GPU 上执行的函数,由于历史原因,称为核函数。开始运行核函数的操作称为启动核函数。一次核函数启动可以理解为启动多个线程,在 GPU 上并行执行核函数代码。GPU 线程的工作方式与 CPU 上的线程类似,不过也存在一些对正确性和性能都很重要的差异,后续章节将介绍这些差异(参见第 3.2.2.1.1 节)。
1.2.2. GPU 硬件模型
与任何编程模型一样,CUDA 依赖于底层硬件的概念模型。对于 CUDA 编程而言,可以将 GPU 视为一组流式多处理器(SM),这些 SM 被组织成若干组,称为图形处理簇(GPC)。每个 SM 包含一个局部寄存器文件、一个统一数据缓存以及若干执行计算的功能单元。统一数据缓存为共享内存和 L1 缓存提供物理资源。统一数据缓存在 L1 与共享内存之间的分配可以在运行时配置。不同 GPU 架构中,SM 内各类内存的大小和功能单元的数量可能有所不同。
注意
GPU 的实际硬件布局或其在物理上执行编程模型的方式可能有所不同。这些差异不会影响使用 CUDA 编程模型编写的软件的正确性。
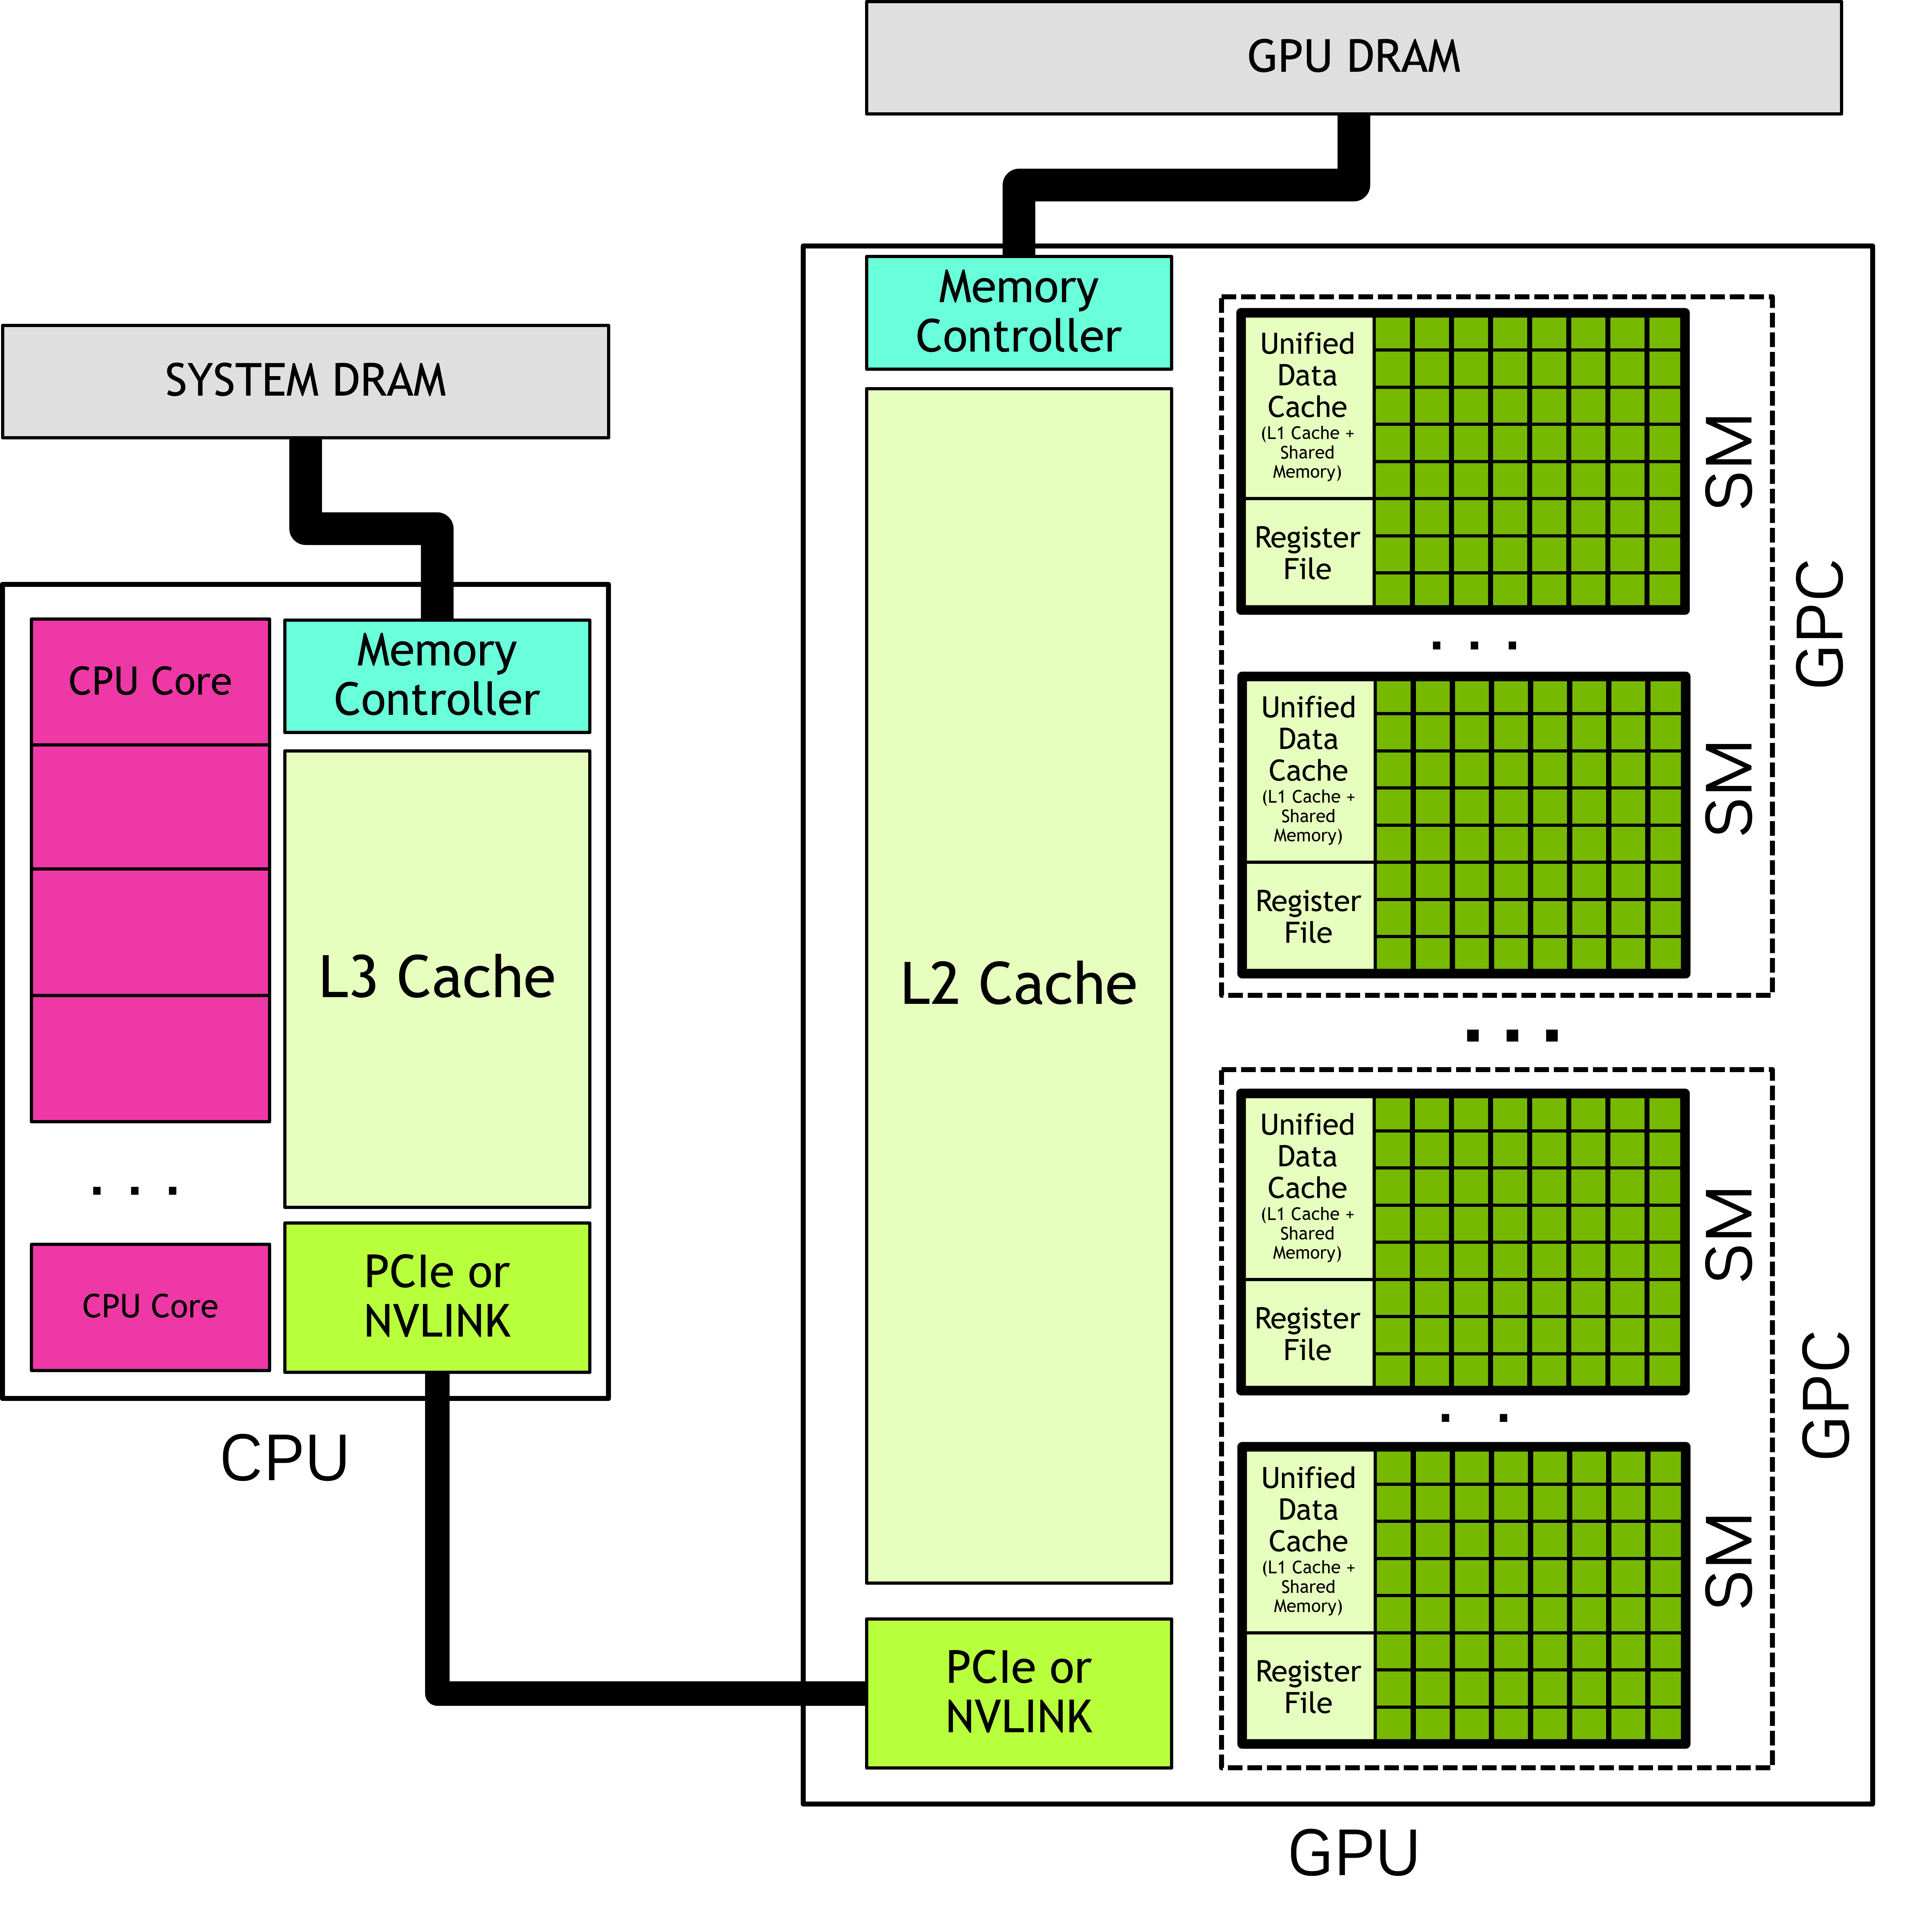
图 2 GPU 具有许多流式多处理器(SM),每个 SM 都包含许多功能单元。图形处理簇(GPC)是 SM 的集合。GPU 是一组连接到 GPU 内存的 GPC。CPU 通常具有多个核心和一个连接到系统内存的内存控制器。CPU 与 GPU 通过 PCIe 或 NVLINK 等互连连接。
图内文字中文对照
SYSTEM DRAM- 系统 DRAM
CPU Core- CPU 核心
Memory Controller- 内存控制器
L3 Cache- L3 缓存
PCIe or NVLINK- PCIe 或 NVLINK
L2 Cache- L2 缓存
Unified Data Cache (L1 Cache + Shared Memory)- 统一数据缓存(L1 缓存 + 共享内存)
Register File- 寄存器文件
SM- 流式多处理器
1.2.2.1. 线程块与网格
应用启动核函数时,会使用大量线程,通常多达数百万个。这些线程被组织成块。顾名思义,由线程组成的块称为线程块。线程块被组织成网格。一个网格中的所有线程块具有相同的大小和维度。图 3展示了由线程块组成的网格的示意图。
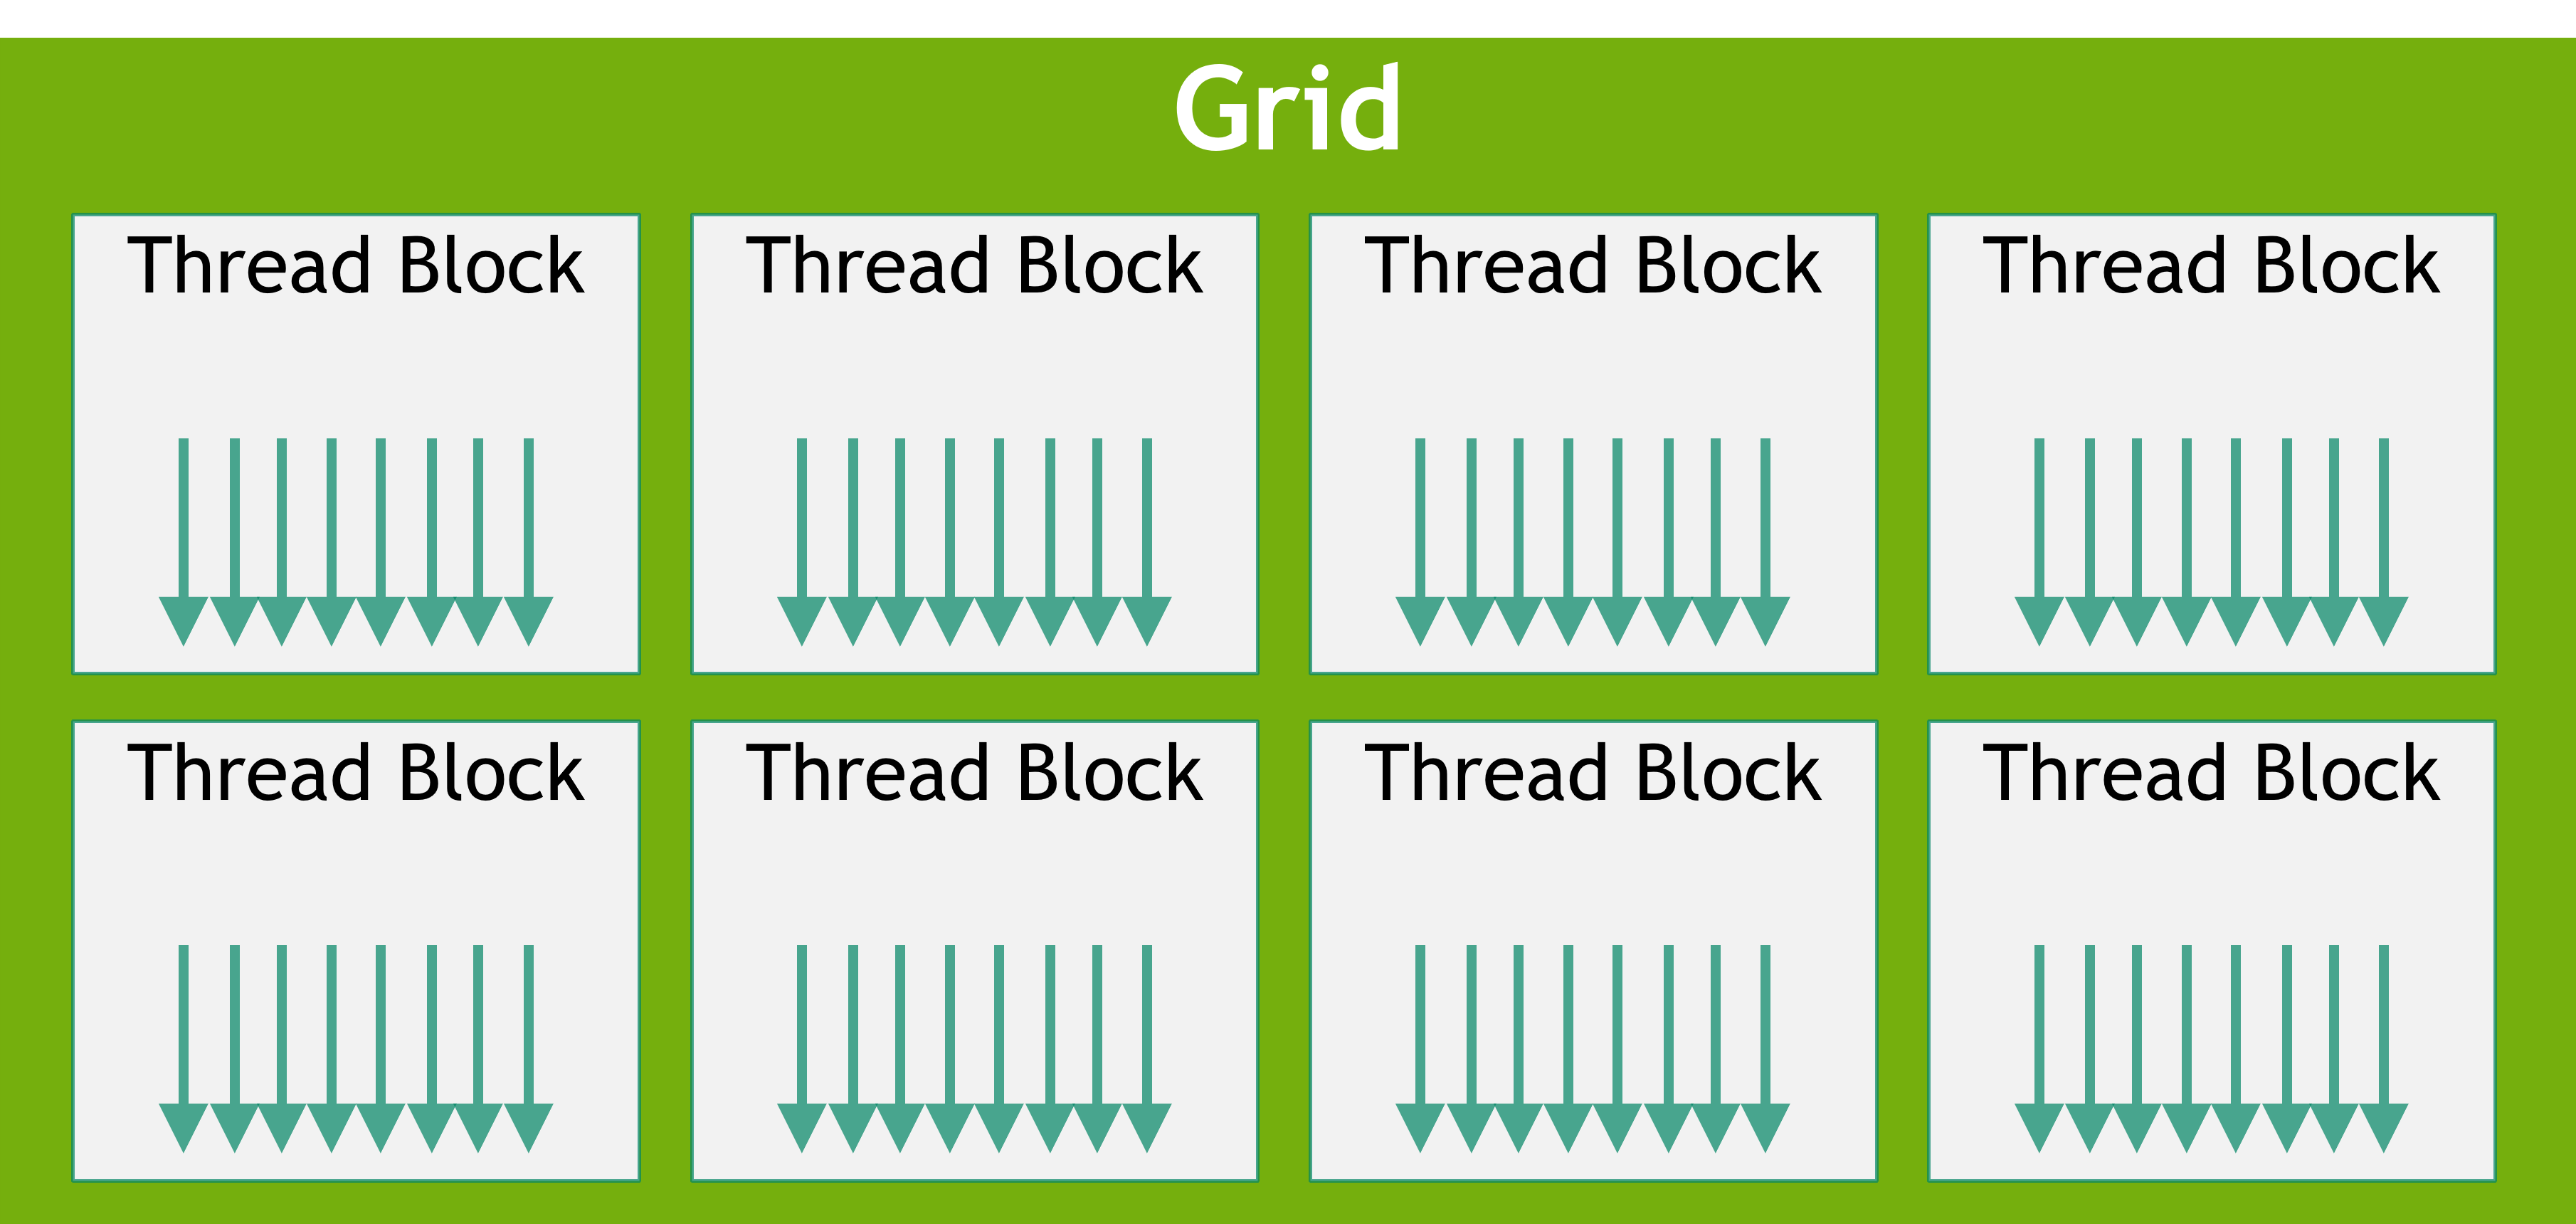
图 3 由线程块组成的网格。每个箭头代表一个线程(箭头数量不代表实际线程数量)。
图内文字中文对照
Grid- 网格
Thread Block- 线程块
线程块和网格可以是一维、二维或三维的。这些维度可以简化将各个线程映射到工作单元或数据项的过程。
启动核函数时,会使用特定的执行配置,以指定网格和线程块的维度。执行配置还可以包含可选参数,例如簇大小、流和 SM 配置设置,这些将在后续章节中介绍。
通过内置变量,每个执行核函数的线程都可以确定自己在所属线程块中的位置,以及其线程块在所属网格中的位置。线程还可以利用这些内置变量,确定核函数启动所使用的线程块和网格的维度。这使每个线程在运行该核函数的所有线程中都具有唯一的身份标识。此标识经常用于确定线程负责哪些数据或操作。
一个线程块的所有线程都在单个 SM 中执行。这使得线程块内的线程能够高效地相互通信和同步。线程块内的所有线程都可以访问片上共享内存,该内存可用于在线程块的线程之间交换信息。
一个网格可能由数百万个线程块组成,而执行该网格的 GPU 可能只有几十个或几百个 SM。一个线程块的所有线程都由单个 SM 执行,并且在大多数情况下[1],会在该 SM 上运行直至完成。线程块之间的调度没有任何保证,因此一个线程块不能依赖其他线程块的结果,因为其他线程块可能必须等到该线程块完成后才能被调度。图 4展示了将网格中的线程块分配给 SM 的示例。
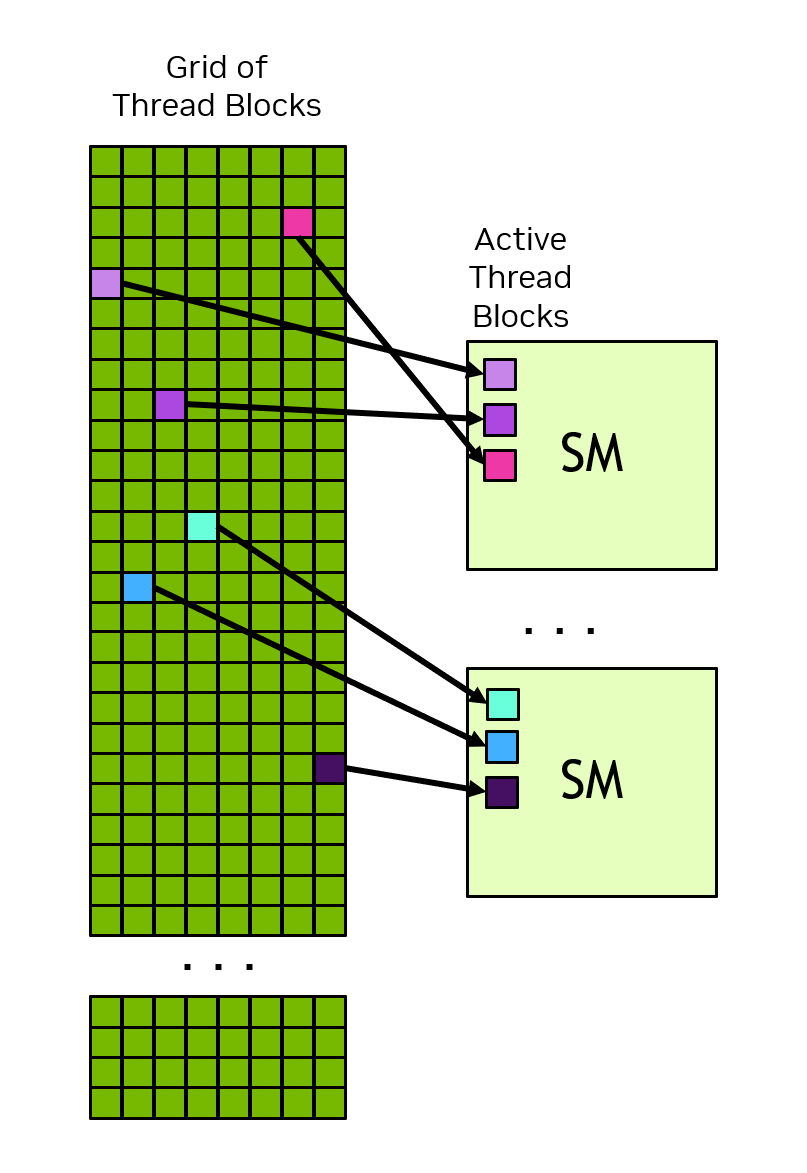
图 4 每个 SM 都有一个或多个活动线程块。在此示例中,每个 SM 同时调度了三个线程块。对于网格中的线程块被分配给 SM 的顺序,没有任何保证。
图内文字中文对照
Grid of Thread Blocks- 线程块网格
Active Thread Blocks- 活动线程块
SM- 流式多处理器
CUDA 编程模型使任意大的网格都能在任何规模的 GPU 上运行,无论 GPU 仅有一个 SM,还是有数千个 SM。为实现这一点,除少数例外情况外,CUDA 编程模型要求不同线程块中的线程之间不存在数据依赖。也就是说,一个线程不应依赖同一网格中其他线程块内线程的结果,也不应与其同步。一个线程块内的所有线程同时在同一个 SM 上运行。网格中的不同线程块被调度到可用的 SM 上,并且可以按任意顺序执行。简而言之,CUDA 编程模型要求线程块能够以任意顺序、并行或串行执行。
1.2.2.1.1. 线程块簇
除了线程块之外,计算能力为 9.0 及更高版本的 GPU 还具有一个可选的分组层级,称为簇。簇是一组线程块,与线程块和网格一样,可以按一维、二维或三维进行布局。图 5展示了一个同时组织成簇的线程块网格。指定簇不会改变网格的维度,也不会改变线程块在网格中的索引。
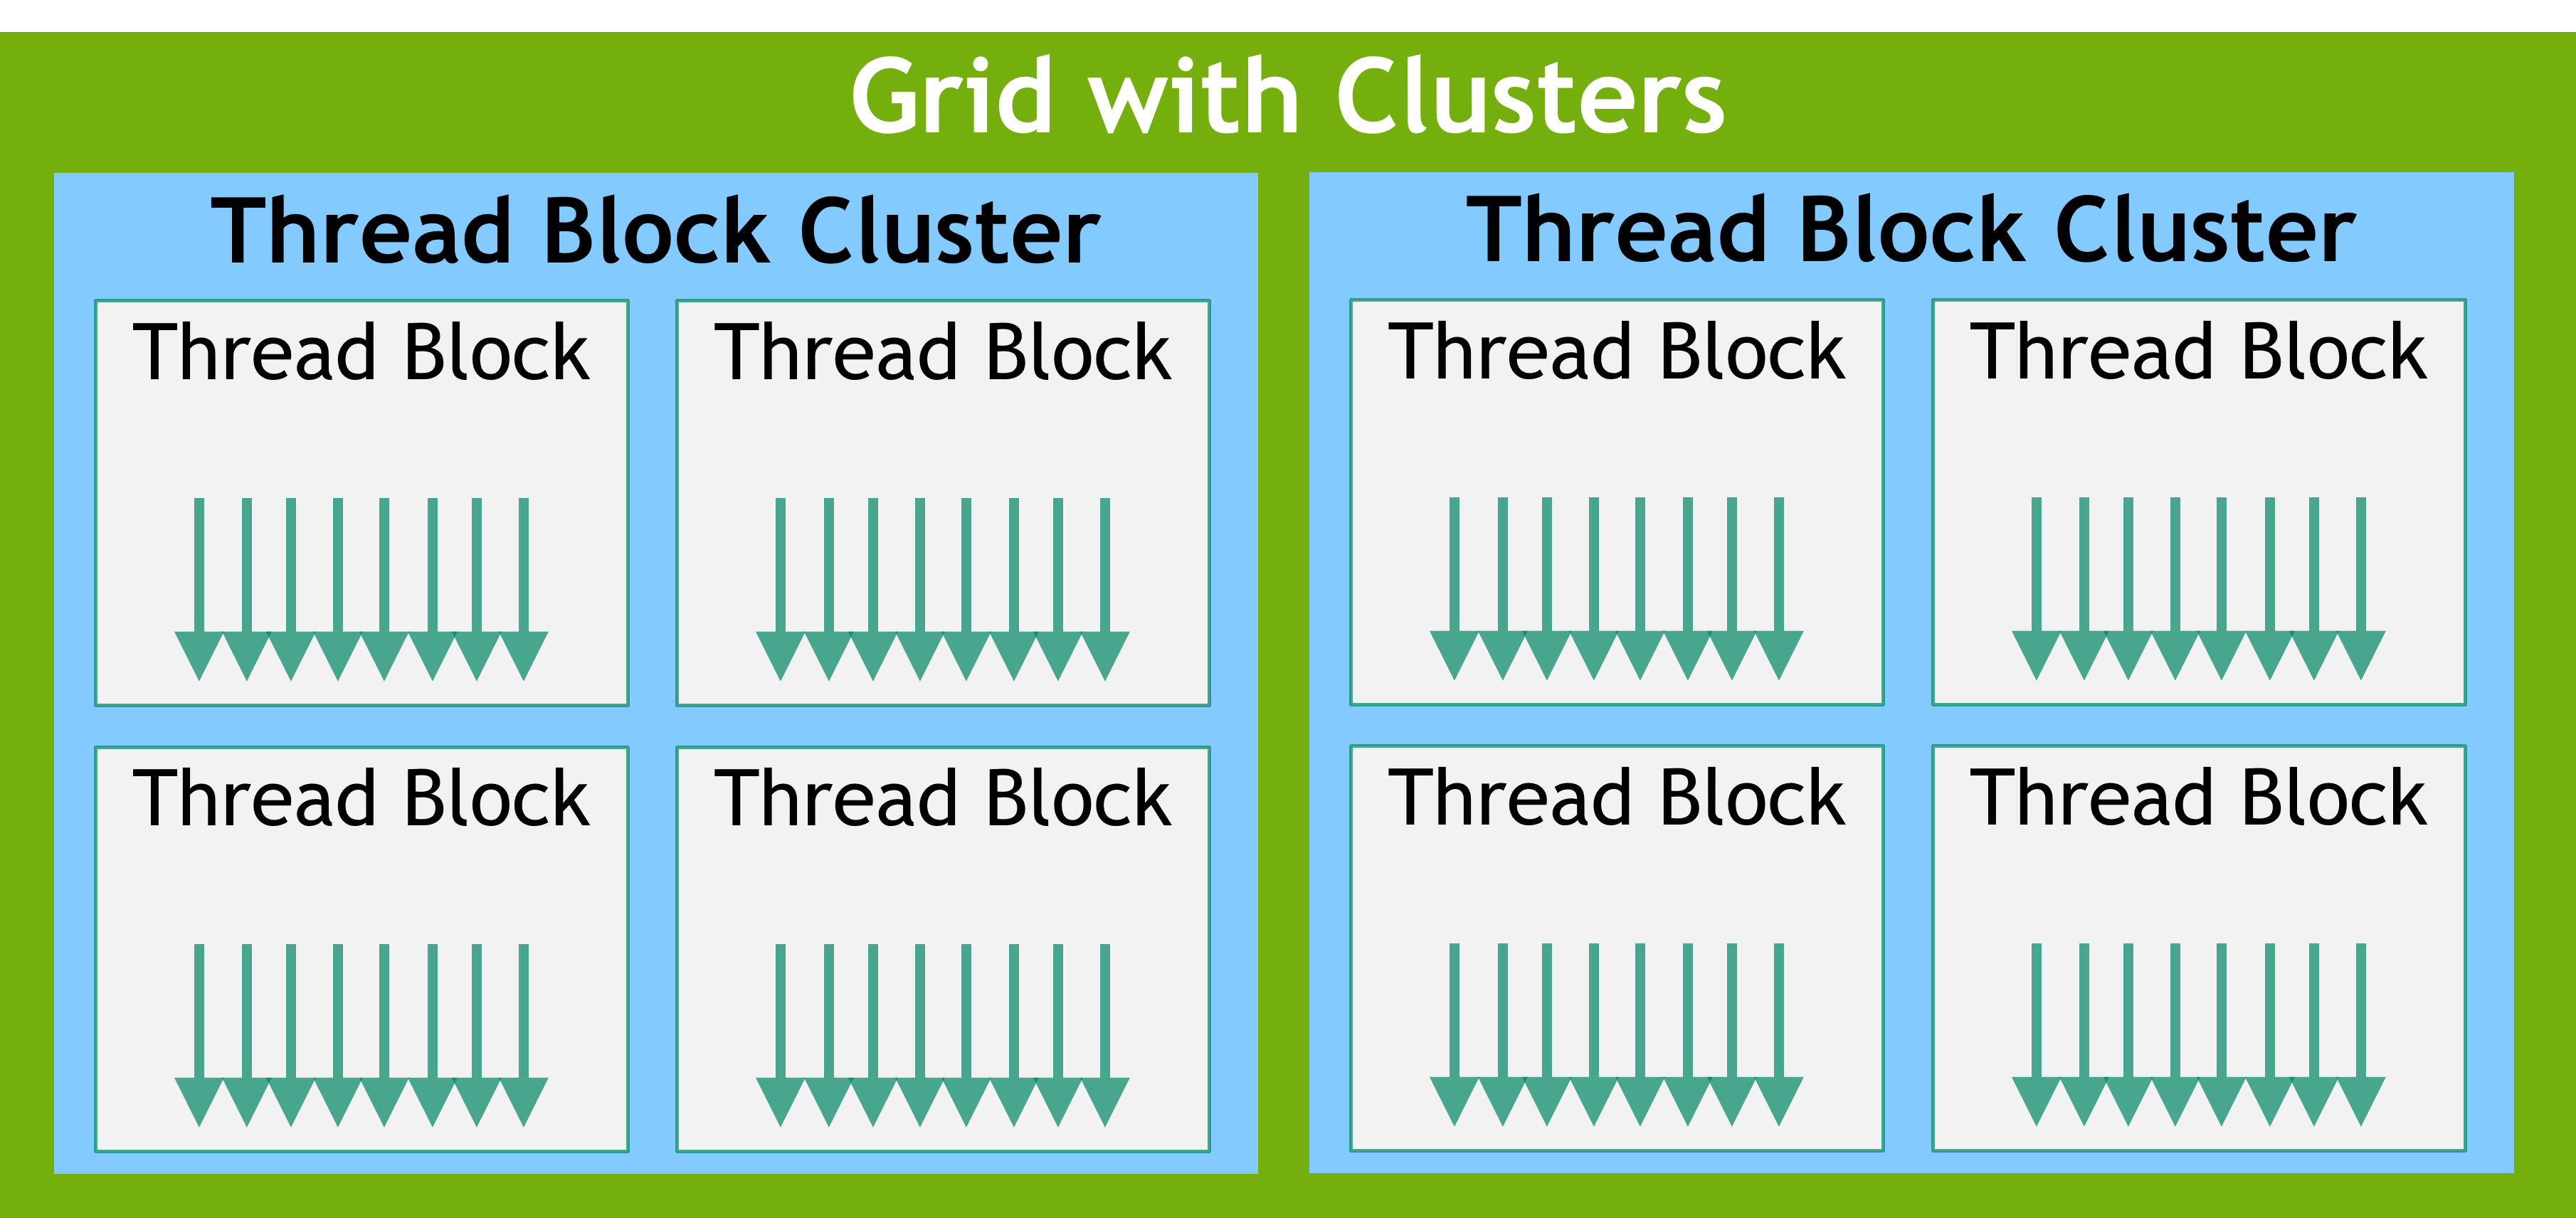
图 5 指定簇时,线程块在网格中的位置保持不变,但也具有其在所属簇中的位置。
图内文字中文对照
Grid with Clusters- 包含簇的网格
Thread Block Cluster- 线程块簇
Thread Block- 线程块
指定簇会将相邻线程块分组成簇,并在簇级别提供一些额外的同步和通信机会。具体而言,一个簇中的所有线程块都在同一个 GPC 中执行。图 6展示了指定簇时,如何将线程块调度到一个 GPC 中的 SM 上。由于这些线程块被同时调度且位于同一个 GPC 内,因此,位于不同线程块但处于同一个簇中的线程可以使用协作组提供的软件接口相互通信和同步。簇中的线程可以访问该簇中所有线程块的共享内存,这称为分布式共享内存。簇的最大大小取决于硬件,并因设备而异。
图 6展示了如何将一个簇中的线程块同时调度到一个 GPC 内的 SM 上。一个簇中的线程块在网格中始终彼此相邻。
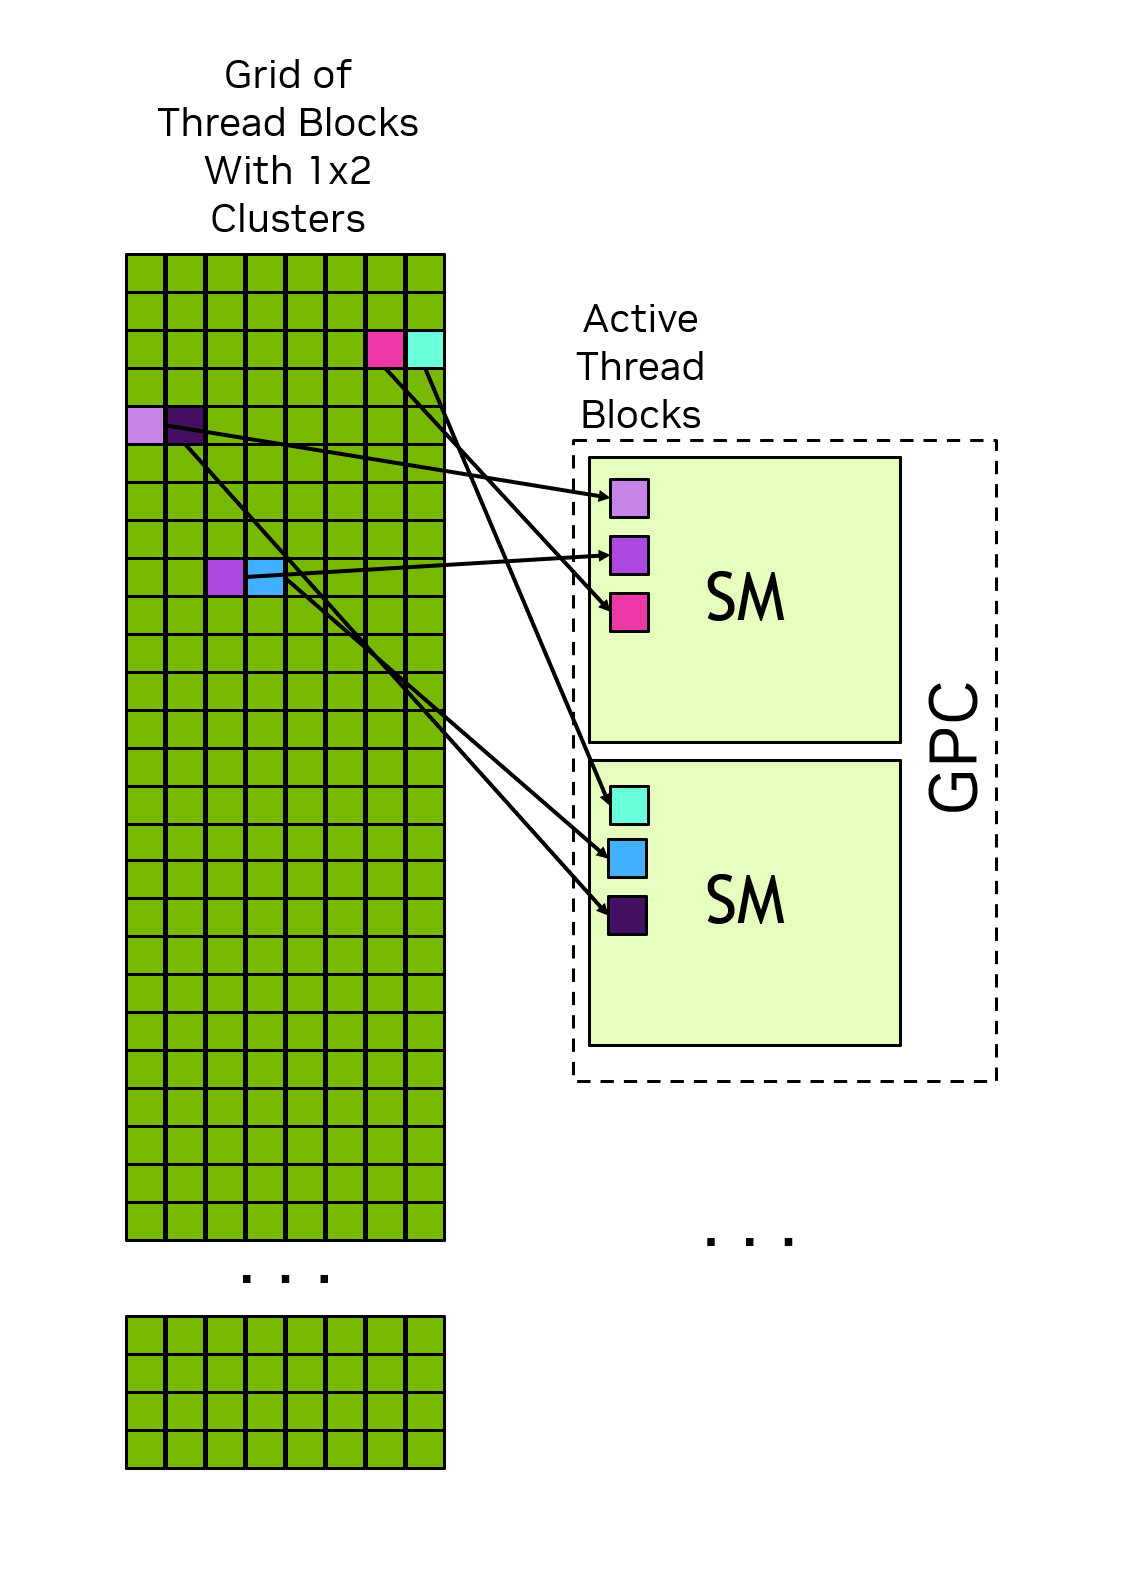
图 6 指定簇时,簇中的线程块在网格中按照其簇的形状排列。一个簇的线程块被同时调度到同一个 GPC 的 SM 上。
图内文字中文对照
Grid of Thread Blocks With 1x2 Clusters- 包含 1x2 簇的线程块网格
Active Thread Blocks- 活动线程块
SM- 流式多处理器
1.2.2.2. 线程束与 SIMT
在线程块内,线程按每组 32 个线程组织,称为线程束。线程束以单指令多线程(SIMT)范式执行核函数代码。在 SIMT 中,线程束中的所有线程都执行相同的核函数代码,但每个线程可能沿着代码中的不同分支执行。也就是说,尽管程序中的所有线程都执行相同的代码,线程却不必遵循相同的执行路径。
线程在线程束中执行时,会被分配一个线程束通道。线程束通道的编号为 0 到 31,线程块中的线程以一种可预测的方式分配到线程束中,详见硬件多线程。
线程束中的所有线程同时执行相同的指令。如果线程束中的某些线程在执行时进入某个控制流分支,而其他线程不进入,则在执行进入该分支的线程时,不进入该分支的线程将被屏蔽。例如,如果某个条件仅对线程束中一半的线程为真,那么在活跃线程执行这些指令时,线程束中的另一半线程将被屏蔽。图 7展示了这种情况。线程束中的不同线程遵循不同代码路径的情况有时称为线程束分歧。因此,当线程束中的线程遵循相同的控制流路径时,GPU 的利用率可达到最大。
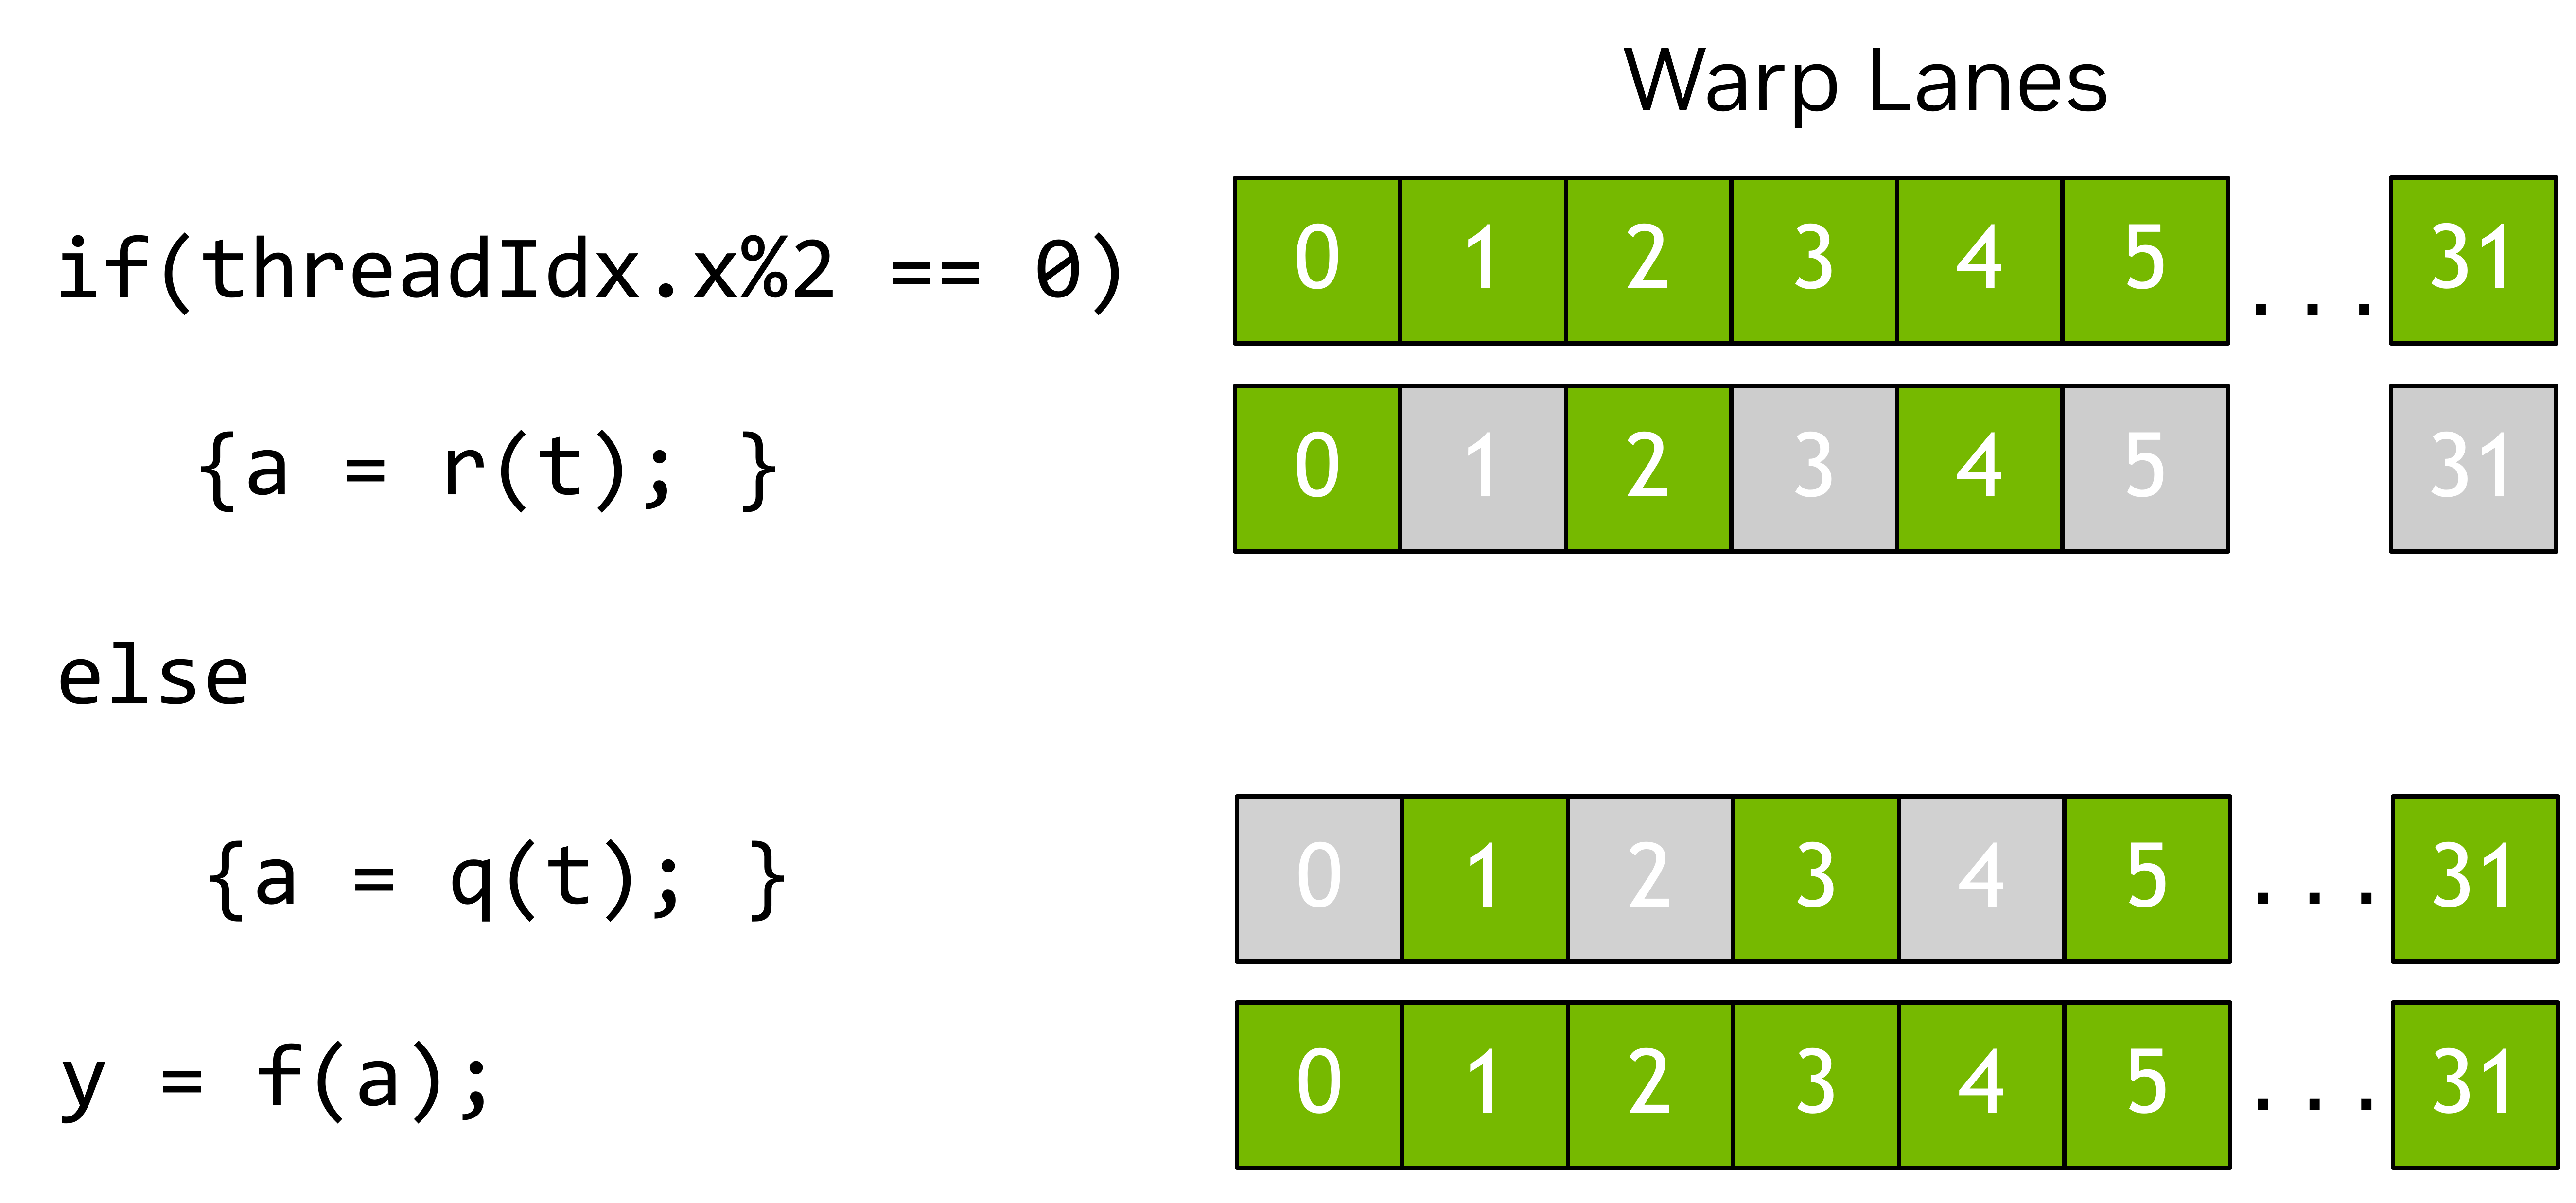
图 7 在此示例中,只有线程索引为偶数的线程执行 if 语句体,其他线程在执行语句体期间被屏蔽。
图内文字中文对照
Warp Lanes- 线程束通道
在 SIMT 模型中,线程束中的所有线程以锁步方式执行核函数。硬件执行情况可能有所不同。有关这种区别在哪些情况下很重要的更多信息,请参阅独立线程执行相关章节。不建议利用线程束执行实际上如何映射到真实硬件的知识。CUDA 编程模型和 SIMT 规定,线程束中的所有线程一起执行代码。只要遵循该编程模型,硬件就可以以对程序透明的方式优化被屏蔽的通道。如果程序违反该模型,可能导致未定义行为,并且这种行为在不同的 GPU 硬件上可能有所不同。
虽然编写 CUDA 代码时不必考虑线程束,但了解线程束执行模型有助于理解全局内存访问合并和共享内存存储体访问模式等概念。一些高级编程技术通过在线程块内对线程束进行专门化来限制线程分歧并最大限度地提高利用率。这种优化以及其他优化都利用了线程在执行时会被分组成线程束这一知识。
线程束执行意味着,最好将线程块的线程总数指定为 32 的倍数。使用任意数量的线程都是合法的,但当总数不是 32 的倍数时,线程块的最后一个线程束会有一些通道在整个执行过程中都不使用。这很可能导致该线程束的功能单元利用率和内存访问效果不佳。
SIMT 经常被拿来与单指令多数据(SIMD)并行性进行比较,但两者存在一些重要区别。在 SIMD 中,执行遵循单一控制流路径,而在 SIMT 中,允许每个线程遵循自己的控制流路径。因此,SIMT 不像 SIMD 那样具有固定的数据宽度。有关 SIMT 的更详细讨论,请参阅SIMT 执行模型。
1.2.2.3. CUDA 中的分块编程
除了前面各节介绍的 SIMT 模型之外,CUDA 还支持分块编程模型。在分块编程中,程序员在整个线程块的层级上编写代码,描述对称为分块(tile)的多维数据集合执行的操作。编译器将这些操作映射到线程块中的各个线程。
分块核函数在线程块网格上启动,如线程块与网格一节所述。每个线程块执行分块核函数,并可以查询自身在网格中的位置,以确定自己负责哪一部分数据。程序员只需指定网格维度;每个线程块的线程数由编译器根据核函数中的分块操作确定(图 8)。
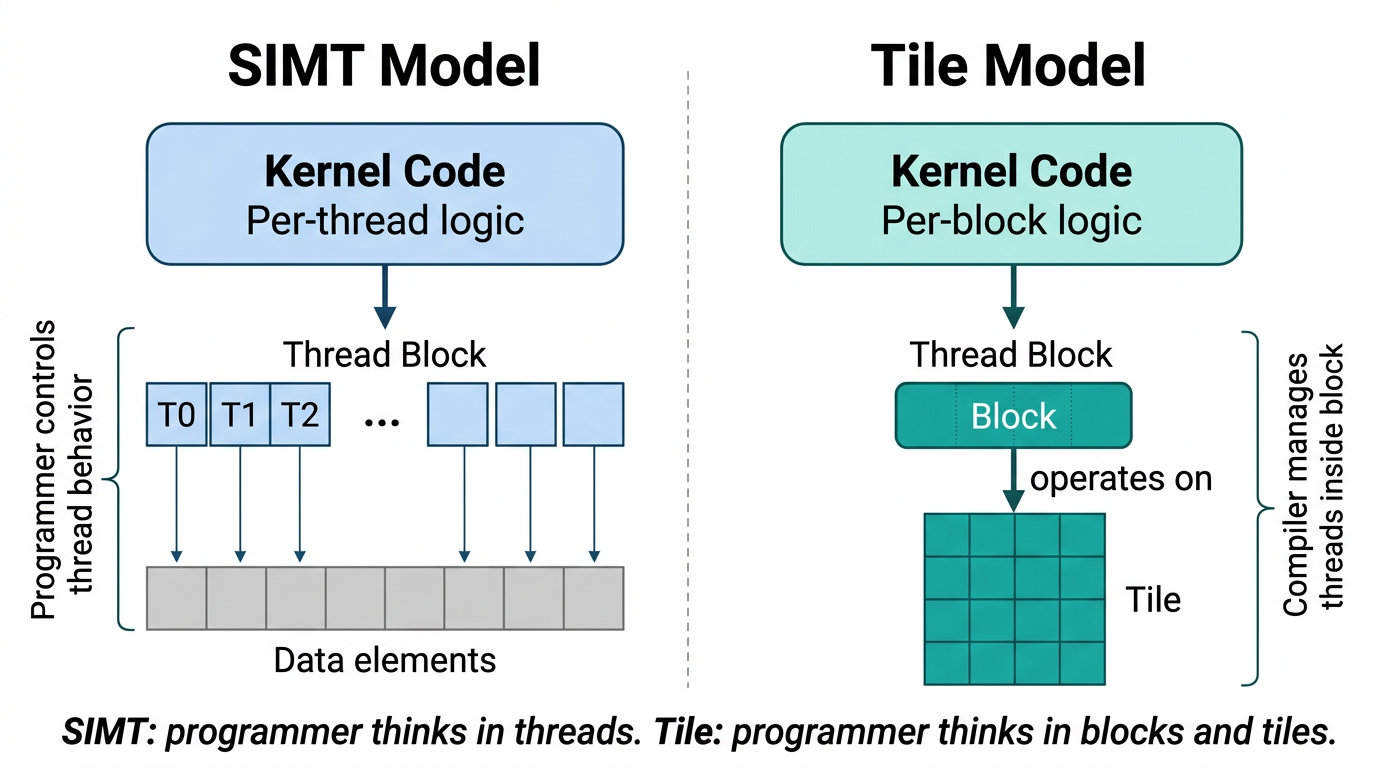
图 8 SIMT 和分块编程模型中的程序员视角。在 SIMT 中,程序员编写每个线程的代码,并控制每个线程如何访问数据。在分块编程中,程序员编写每个线程块的代码来操作分块;编译器将操作映射到线程块中的线程。
图内文字中文对照
SIMT Model- SIMT 模型
Tile Model- 分块模型
Kernel Code- 核函数代码
Per-thread logic- 每个线程的逻辑
Per-block logic- 每个线程块的逻辑
Programmer controls thread behavior- 程序员控制线程行为
Thread Block- 线程块
Block- 线程块
operates on- 作用于
Tile- 分块
Compiler manages threads inside block- 编译器管理线程块内的线程
Data elements- 数据元素
SIMT: programmer thinks in threads. Tile: programmer thinks in blocks and tiles.- SIMT:程序员以线程为单位思考。分块:程序员以线程块和分块为单位思考。
在分块核函数内,线程块执行单一控制流。程序员指定对分块执行的操作,编译器则将工作分配给线程块中的各个线程。分块编程支持条件语句和循环等标准控制流结构,但由于线程块遵循单一控制流,因此不存在线程束分歧的概念。标量操作(例如计算索引或循环边界)由线程块中的一个线程执行。分块操作(例如将两个分块逐元素相加)由线程块中的所有线程共同并行执行。
重要的是,不要将作为执行单位的线程块与作为数据单位的分块混淆。单个线程块可以创建并操作许多具有不同形状和数据类型的分块。
1.2.2.3.1. 数组与分块
分块核函数处理两类数据:数组和分块。数组(或全局数组)是存储在设备内存中的元素的多维容器。数组是可变的:可以通过核函数内的存储操作修改其内容。数组具有形状和数据类型。
分块是一个多维值集合,仅存在于分块代码中,并且局限于单个线程块。分块是不可变的:对分块执行的每个操作都会产生一个新分块,而不是修改现有分块。与数组不同,分块不一定在内存中具有表示形式;编译器决定如何存储分块数据,可能会使用寄存器、共享内存或 SM 的其他资源。分块的每个维度都必须是 2 的幂,并且必须在编译时已知(也就是说,其值必须能够在核函数执行前确定,而不是在执行期间计算)。分块不能作为核函数参数传递;它们完全在分块代码内创建和使用。
1.2.2.3.2. 分块空间与数据移动
数据通过加载和存储操作在数组与分块之间移动。这些操作使用一个称为分块空间的概念,即在概念上将数组划分为大小相等、互不重叠的分块所得到的结果。例如,考虑一个形状为 (M, N) 的二维数组。如果加载操作指定分块形状为 (tm, tn),则该数组在概念上被划分为行、列的分块。该分块空间中的索引(例如 (i, j))标识要加载哪个分块。加载操作返回一个形状为 (tm, tn) 的分块,其中包含数组中对应的元素。当分块超出数组边界时,例如数组维度不是分块维度的整数倍时的边缘位置,加载操作会指定如何处理越界元素,例如用零填充这些元素(图 9)。
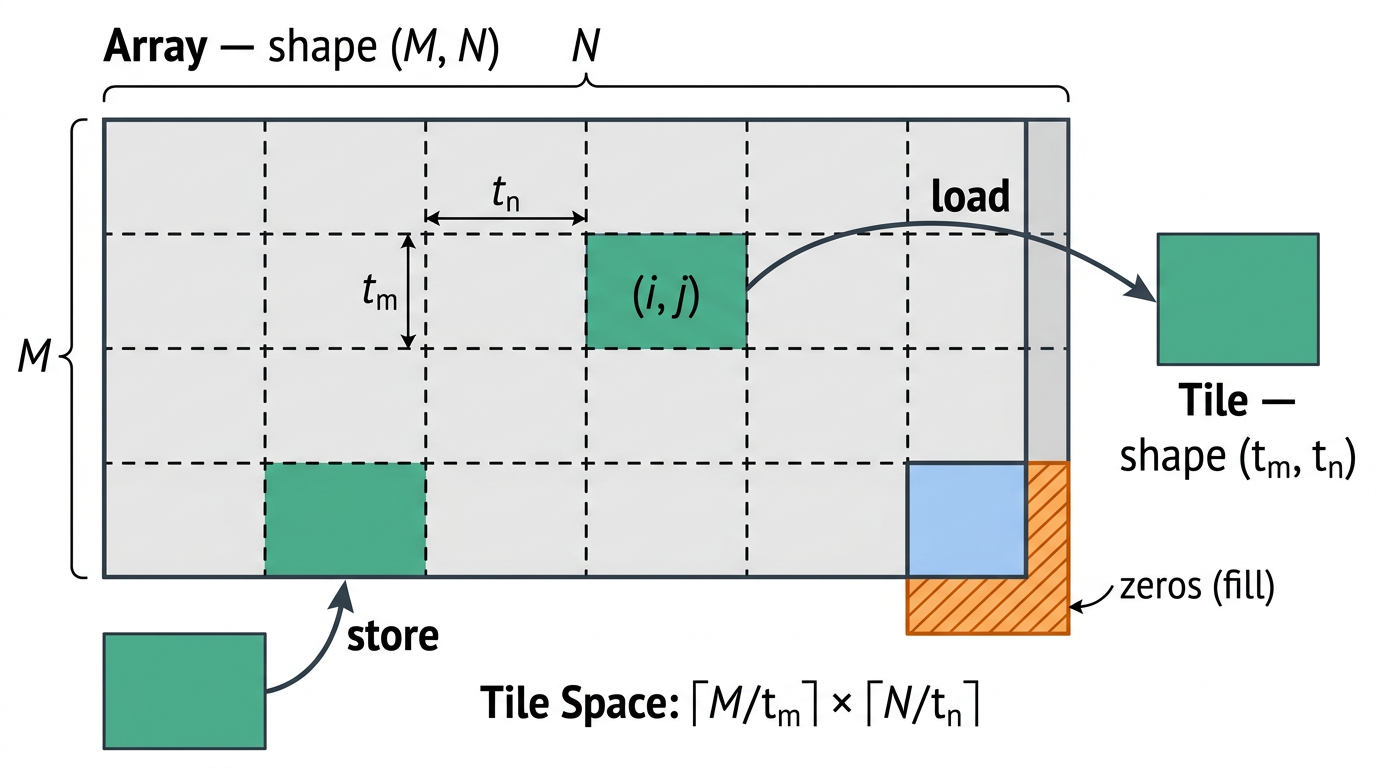
图 9 分块空间与数据移动。形状为 (M, N) 的二维数组在概念上被划分为一个由形状为 (tm, tn) 的分块组成的网格。在分块空间索引 (i, j) 处执行加载操作会返回对应的分块。在数组边界处,落在数组之外的元素可以用零填充。存储操作将分块写回数组中给定分块空间索引处的位置。
图内文字中文对照
Array — shape (M, N)- 数组,形状 (M, N)
load- 加载
store- 存储
Tile Space: ⌈M/tₘ⌉ × ⌈N/tₙ⌉- 分块空间:⌈M/tₘ⌉ × ⌈N/tₙ⌉
Tile — shape (tₘ, tₙ)- 分块,形状 (tₘ, tₙ)
zeros (fill)- 零(填充)
存储操作执行相反的过程:给定一个分块和一个分块空间索引,它会将该分块的元素写入数组的对应区域。任何超出数组边界的写入都会被静默丢弃。分块程序还支持聚集和散布操作,用于从数组中的任意位置加载数据或向其中存储数据。
1.2.2.3.3. 分块操作
分块程序提供了一组作用于分块的内置操作,包括逐元素算术运算、矩阵乘法、沿一个或多个轴的归约(例如求和和求最大值)、形状操作(例如重塑形状和转置)以及类型转换。当两个不同形状的分块在一个操作中组合使用时,较小的分块会先自动扩展以匹配较大的分块,然后再执行该操作。
1.2.2.3.4. 与 SIMT 编程的关系
分块编程和 SIMT 编程在 CUDA 中共存。应用程序可以同时包含 SIMT 核函数和分块核函数,而且这两类核函数都可以操作设备内存中的相同数据。编程模型的选择是针对每个核函数分别作出的决定。分块编程并不取代 SIMT 编程。SIMT 提供了对各个线程的细粒度控制,这对于某些算法和优化技术仍然是必需的。分块编程提供了更高层级的抽象,可以简化核函数开发。由于线程级别的决策交给了编译器,同一个分块核函数无需更改源代码即可在不同的 GPU 架构上运行。这两种模型都建立在前面各节所介绍的相同底层硬件之上,即 SM、线程块和网格。这两种模型也使用相同的设备内存空间,这些内存空间将在下一节介绍。
1.2.3. GPU 内存
在现代计算系统中,高效利用内存与最大限度地利用执行计算的功能单元同样重要。异构系统具有多个内存空间,GPU 除了缓存之外,还包含各种类型的可编程片上内存。以下各节将更详细地介绍这些内存空间。
1.2.3.1. 异构系统中的 DRAM 内存
GPU 和 CPU 都具有直接连接的 DRAM 芯片。在具有多个 GPU 的系统中,每个 GPU 都有自己的内存。从设备代码的角度看,连接到 GPU 的 DRAM 称为全局内存,因为 GPU 中的所有 SM 都可以访问它。这一术语并不意味着系统中的任何位置都一定能访问它。连接到一个或多个 CPU 的 DRAM 称为系统内存或主机内存。
与 CPU 一样,GPU 使用虚拟内存寻址。在目前支持的所有系统上,CPU 和 GPU 使用单一的统一虚拟内存空间。这意味着,系统中每个 GPU 的虚拟内存地址范围都是唯一的,并且与 CPU 及系统中其他每个 GPU 的地址范围不同。对于给定的虚拟内存地址,可以确定该地址位于 GPU 内存还是系统内存中;在具有多个 GPU 的系统上,还可以确定该地址位于哪个 GPU 的内存中。
CUDA 提供了用于分配 GPU 内存、CPU 内存以及在 CPU 和 GPU 的内存分配之间、在一个 GPU 内部或在多 GPU 系统的 GPU 之间进行复制的 API。需要时,可以显式控制数据的局部性。下文讨论的统一内存允许 CUDA 运行时或系统硬件自动处理内存的放置。
1.2.3.2. 局部性域:
局部性域是一个 GPU 的内存和流式多处理器(SM)的子集。所有 GPU 都至少具有一个局部性域。较大的 GPU 可能具有多个局部性域。在具有多个局部性域的 GPU 上,使用局部化的内存和计算可以提高某些核函数的性能。局部化内存是完全包含在单个局部性域内的内存分配。使用此内存的核函数可以被调度到同一局部性域内的 SM 上。当内存和计算在各局部性域之间划分,并且可以并行地向每个局部性域发出工作时,应用程序就能从局部化中受益。
分配时未指定局部性域的 GPU 内存称为未局部化的内存。除分配量非常小的情况外,未局部化的内存分配会跨越多个局部性域。
在仅有一个局部性域的 GPU 上,GPU 的所有 SM 和内存都属于这一个局部性域。
第 4.7 节介绍了将 GPU 内存和计算局部化到特定局部性域内的机制。局部性域是一项性能特性:未对内存或计算进行局部化的 CUDA 代码仍然能够正确执行。
1.2.3.3. GPU 中的片上内存
除全局内存外,每个 GPU 还具有一些片上内存。每个 SM 都有自己的寄存器文件和共享内存。这些内存是 SM 的一部分,在该 SM 内执行的线程可以极快地访问它们。
寄存器文件存储线程局部变量,这些变量通常由编译器分配。线程块或簇内的所有线程都可以访问共享内存。共享内存可用于在线程块或簇的线程之间交换数据。
SM 中的寄存器文件和统一数据缓存的大小都是有限的。有关 SM 的寄存器文件和统一数据缓存的大小,以及如何配置统一数据缓存以平衡 L1 缓存与共享内存,请参见各计算能力的内存信息。寄存器文件、共享内存空间和 L1 缓存由线程块中的所有线程共享。
要将一个线程块调度到某个 SM,每个线程所需的寄存器总数乘以线程块中的线程数,必须小于或等于该 SM 中可用的寄存器数量。如果一个线程块所需的寄存器数量超过了寄存器文件的大小,则无法启动该核函数,必须减少线程块中的线程数,使该线程块能够启动。
共享内存在线程块级别进行分配。也就是说,与按线程进行的寄存器分配不同,分配的共享内存由整个线程块共用。
1.2.3.3.1. 缓存
除了可编程内存,GPU 还具有 L1 和 L2 缓存。每个 SM 都有一个 L1 缓存,它是统一数据缓存的一部分。一个更大的 L2 缓存由 GPU 内的所有 SM 共享。这可以在图 2的 GPU 框图中看到。每个 SM 还具有一个独立的常量缓存,用于缓存全局内存中已声明在核函数整个生命周期内保持不变的值。编译器也可能将核函数参数放入常量内存。这使核函数参数能够在 SM 中独立于 L1 数据缓存进行缓存,从而可以提高核函数性能。
1.2.3.4. 统一内存
当应用程序显式地在 GPU 或 CPU 上分配内存时,该内存只能由在该设备上运行的代码访问。也就是说,CPU 内存只能由 CPU 代码访问,而 GPU 内存只能由在 GPU 上运行的核函数访问[2]。用于在 CPU 和 GPU 之间复制内存的 CUDA API 可用来在适当的时间将数据显式复制到正确的内存中。
一项称为统一内存的 CUDA 功能允许应用程序分配可由 CPU 或 GPU 访问的内存。CUDA 运行时或底层硬件会在需要时启用访问,或将数据重新放置到正确的位置。即便使用统一内存,也要尽量减少内存迁移,并尽可能从与数据所在内存直接相连的处理器访问数据,才能获得最佳性能。
系统的硬件特性决定了如何实现内存空间之间的数据访问和交换。统一内存一节介绍了统一内存系统的不同类别。统一内存一节包含了在各种情况下使用统一内存及其行为的更多详细信息。