2.3. 编写 SIMT 核函数
针对给定问题,CUDA 核函数的编写方式在很大程度上可以与传统 CPU 代码的编写方式相同。不过,GPU 具有一些可用于提高性能的独特特性。此外,了解 GPU 上的线程如何调度、如何访问内存以及如何执行,可以帮助开发者编写出最大限度利用可用计算资源的核函数。
本章进一步介绍使用SIMT 编程模型在 C++ 和 Python 中编写核函数的一些细节。
2.3.1. SIMT 基础
从开发者的角度来看,CUDA 线程是并行性的基本单位。第 1.2.2.2 节介绍了 GPU 执行的基本 SIMT 模型,SIMT 执行模型则提供了 SIMT 模型的更多细节。SIMT 模型允许每个线程维护自身的状态和控制流。从功能角度来看,每个线程都可以执行独立的代码路径。然而,注意让核函数代码尽量减少同一线程束中的线程采取分歧代码路径的情况,可以显著提高性能。
2.3.2. 线程层次结构
线程组织成线程块,线程块再组织成网格。网格可以是一维、二维或三维的,在核函数内部可以使用内建变量gridDim查询网格的大小。线程块也可以是一维、二维或三维的。在核函数内部可以使用内建变量blockDim查询线程块的大小。可以使用内建变量blockIdx查询线程块的索引。在线程块内部,可以使用内建变量threadIdx获取线程的索引。这些内建变量用于为每个线程计算唯一的全局线程索引,从而使每个线程都能够从全局内存加载特定数据或将特定数据存储到全局内存,并根据需要执行独有的代码路径。
gridDim.[x|y|z]:网格在x、y和z维度上的大小,依次对应。这些值对于所有线程都相同,是核函数启动时设置的执行配置的一部分。blockDim.[x|y|z]:线程块在x、y和z维度上的大小,依次对应。这些值对于所有线程都相同,是核函数启动时设置的执行配置的一部分。blockIdx.[x|y|z]:线程块在x、y和z维度上的索引,依次对应。这些值在线程之间会有所不同,以指示正在执行的是哪个线程块。threadIdx.[x|y|z]:线程在x、y和z维度上的索引,依次对应。这些值在线程之间会有所不同,以指示正在执行的是哪个线程。
cuda.gridDim.[xyz]:网格在x、y和z维度上的大小,依次对应。这些值对于所有线程都相同,是核函数启动时设置的执行配置的一部分。cuda.blockDim.[xyz]:线程块在x、y和z维度上的大小,依次对应。这些值对于所有线程都相同,是核函数启动时设置的执行配置的一部分。cuda.blockIdx.[xyz]:线程块在x、y和z维度上的索引,依次对应。这些值在线程之间会有所不同,以指示正在执行的是哪个线程块。cuda.threadIdx.[xyz]:线程在x、y和z维度上的索引,依次对应。这些值在线程之间会有所不同,以指示正在执行的是哪个线程。
使用多维线程块和网格只是为了方便,并不会影响性能。线程块中的线程以可预测的方式线性化:第一个索引x变化最快,其次是y,然后是z。这意味着,在线程索引的线性化过程中,threadIdx.x的连续值表示连续的线程,threadIdx.y的步长为blockDim.x,而threadIdx.z的步长为blockDim.x * blockDim.y。这会影响线程分配到线程束的方式,详见硬件多线程。
图 11展示了一个由一维线程块构成的二维网格的简单示例。
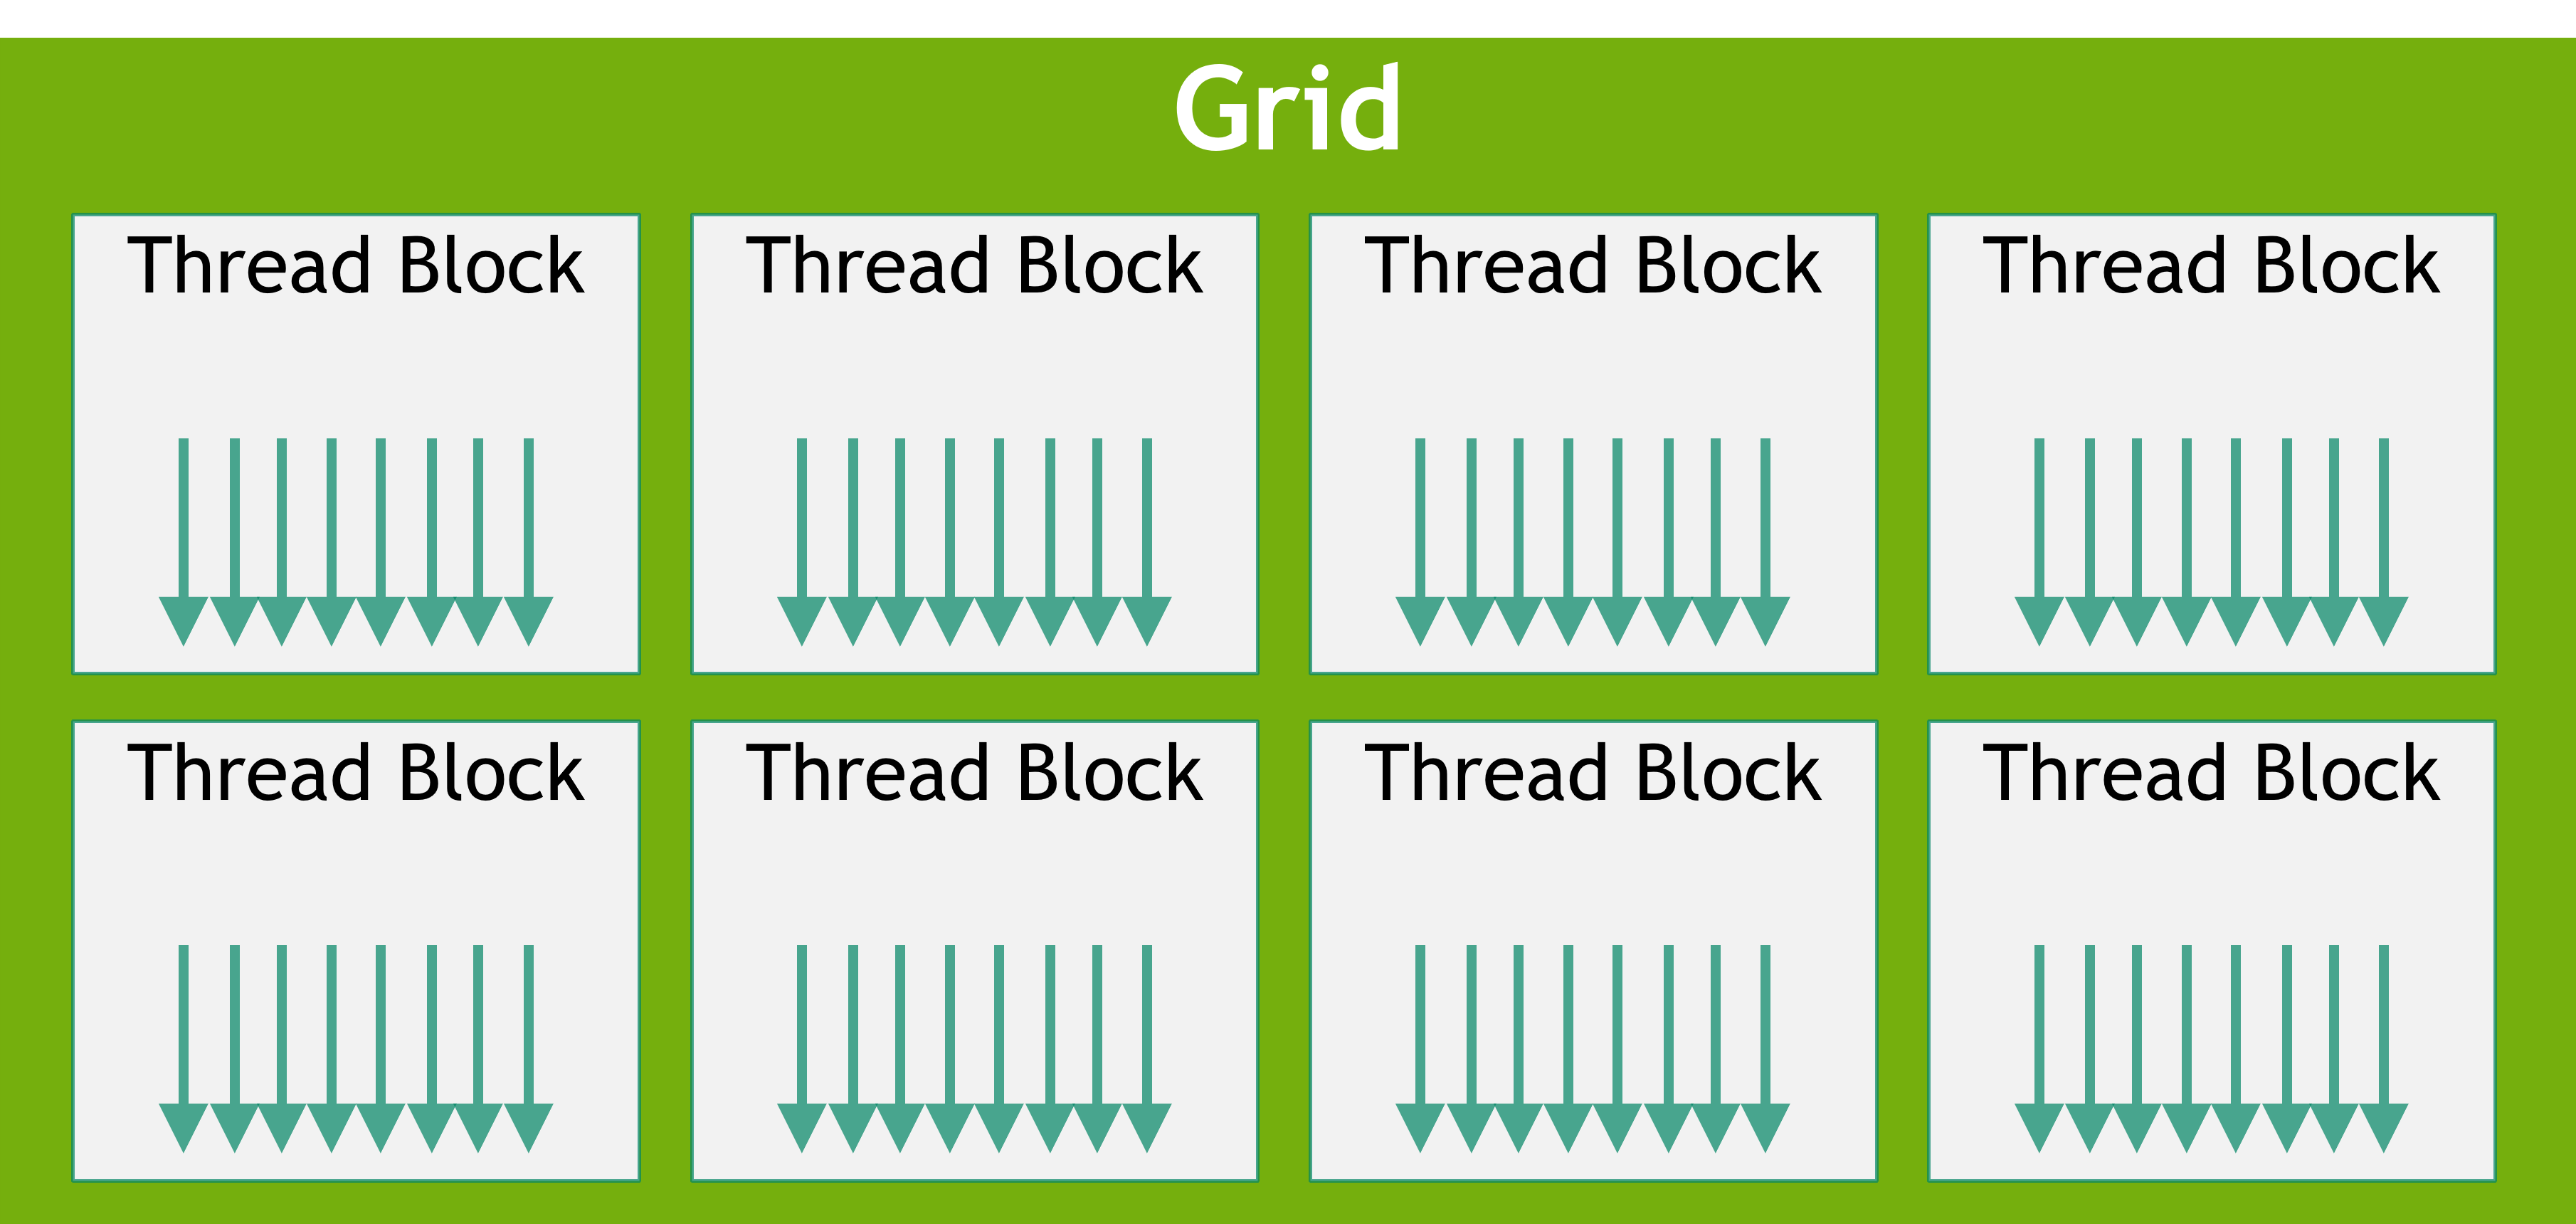
图 11 线程块网格
图内文字中文对照
Grid- 网格
Thread Block- 线程块
2.3.2.1. 线程块同步
在前面给出的示例中,不需要对线程块内的线程进行同步。当线程块内的线程相互协作或访问相同的内存地址时,尤其是访问下文介绍的共享内存时,就需要同步以避免竞态条件和内存冒险。
线程块内最基本的同步形式称为syncthreads
2.3.3. GPU 设备内存空间
CUDA 设备具有多种内存空间,核函数内的 CUDA 线程可以访问这些空间。表 1汇总了常见的内存类型、它们的线程作用域及生命周期。以下各节将更详细地解释这些内存类型。
内存类型 |
作用域 |
生命周期 |
位置 |
|---|---|---|---|
全局 |
网格 |
应用程序 |
设备 |
常量 |
网格 |
应用程序 |
设备 |
共享 |
线程块 |
核函数 |
SM |
局部 |
线程 |
核函数 |
设备 |
寄存器 |
线程 |
核函数 |
SM |
2.3.3.1. 全局内存
全局内存(也称为设备内存)是用于存储核函数中所有线程均可访问的数据的主要内存空间。它类似于 CPU 系统中的 RAM。在 GPU 上运行的核函数可以直接访问全局内存,就像在 CPU 上运行的代码可以访问系统内存一样。
全局内存具有持久性。也就是说,在全局内存中分配的内存及其中存储的数据会一直保留,直到该分配被释放或应用程序终止。cudaDeviceReset也会释放所有已分配的内存。
全局内存通过cudaMalloc和cudaMallocManaged等 CUDA API 调用进行分配。可以使用cudaMemcpy等 CUDA 运行时 API 调用将数据从 CPU 内存复制到全局内存中。使用 CUDA API 分配的全局内存通过cudaFree释放。
在核函数启动之前,通过 CUDA API 调用分配并初始化全局内存。在核函数执行期间,CUDA 线程可以读取全局内存中的数据,并将 CUDA 线程所执行操作的结果写回全局内存。核函数执行完成后,可以将其写入全局内存的结果复制回主机,或供 GPU 上的其他核函数使用。
由于网格中的所有线程都可以访问全局内存,因此必须注意避免线程之间的数据竞争。由于从主机启动的 CUDA 核函数的返回类型为void,因此将核函数计算出的数值结果返回给主机的唯一方法是将这些结果写入全局内存。
下面的核函数是说明全局内存用法的一个简单示例,其中三个数组A、B和C均位于全局内存中,由这个向量加法核函数访问。
__global__ void vecAdd(float* A, float* B, float* C, int vectorLength)
{
    int workIndex = threadIdx.x + blockIdx.x*blockDim.x;
    if(workIndex < vectorLength)
    {
        C[workIndex] = A[workIndex] + B[workIndex];
    }
}
@cuda.jit
def vecadd(A, B, C):
    work_index = cuda.grid(1)
    C[work_index] = A[work_index] + B[work_index]
2.3.3.3. 寄存器
寄存器位于 SM 上,具有线程局部作用域。寄存器的使用由编译器管理,在核函数执行期间用于线程局部存储。可以使用 GPU 的regsPerMultiprocessor和regsPerBlock设备属性查询每个 SM 的寄存器数量以及每个线程块的寄存器数量。
编译 C++ 代码时,NVCC 允许开发者通过-maxrregcount选项为核函数指定寄存器数量上限。使用此选项减少核函数可以使用的寄存器数量,可能会使更多线程块被调度到 SM 上并发执行,但也可能导致更多寄存器溢出。寄存器溢出是指,为了给其他值腾出空间,必须将当前存储在片上寄存器中的值写出到全局内存,然后再在稍后读回。
2.3.3.4. 局部内存
局部内存与寄存器类似,是由 NVCC 管理的线程局部存储,但局部内存的物理位置位于全局内存空间中。“局部”这一名称指的是它的逻辑作用域,而不是物理位置。局部内存在核函数执行期间用于线程局部存储。编译器可能放入局部内存的自动变量包括:
编译器无法确认其索引使用常量的数组,
会占用过多寄存器空间的大型结构体或数组,
当核函数使用的寄存器数量超过可用数量时的任何变量,即发生寄存器溢出。
由于局部内存空间位于设备内存中,局部内存访问具有与全局内存访问相同的延迟和带宽,并且受到合并的全局内存访问中所述的相同内存访问合并要求的约束。不过,局部内存的组织方式使得连续的线程 ID 访问连续的 32 位字。因此,只要线程束中的所有线程访问相同的相对地址,例如数组变量中的同一索引或结构体变量中的同一成员,访问就会完全合并。
2.3.3.5. 常量内存
常量内存具有网格作用域,并且在应用程序的整个生命周期内均可访问。常量内存位于设备上,对核函数而言是只读的。
在 C++ 中,变量或数组使用__constant__说明符在任何核函数或函数之外声明。
在 Python 中,在核函数代码内部指定const_array = numba.cuda.const.array_like(ary)方法,以创建一个常量内存数组,其中包含存储在主机数组ary中的数据
常量内存意味着变量:
位于常量内存空间中,
在每个设备上都有一个独立的对象,
可由网格中的所有线程访问,并且在 C++ 中可由主机通过运行时库(
cudaGetSymbolAddress()/cudaGetSymbolSize()/cudaMemcpyToSymbol()/cudaMemcpyFromSymbol())访问。
在 C++ 中,常量内存的生命周期与创建它的上下文相同。在 Python 中,常量内存的生命周期与声明它的核函数相同。
可以通过totalConstMem设备属性成员查询常量内存的总量。
常量内存适用于每个线程都会以只读方式使用的少量数据。与其他内存相比,常量内存较小,通常每个设备为 64KB。
下面是一个声明和使用常量内存的示例代码片段。
// In your .cu file
__constant__ float coeffs[4];
__global__ void compute(float *out) {
int idx = threadIdx.x;
out[idx] = coeffs[0] * idx + coeffs[1];
}
// In your host code
float h_coeffs[4] = {1.0f, 2.0f, 3.0f, 4.0f};
cudaMemcpyToSymbol(coeffs, h_coeffs, sizeof(h_coeffs));
compute<<<1, 10>>>(device_out);
from numba import cuda
import numpy as np
host_array = np.zeros(128, dtype=np.float32)
## fill host_array with other data
@cuda.jit
def kernel(args):
...
const_array = cuda.const.array_like(a)
# this access now goes through constant memory
a = const_array[cuda.threadIdx.x]
2.3.3.6. 缓存
GPU 设备具有多级缓存结构,其中包括 L2 和 L1 缓存。
L2 缓存位于设备上,由所有 SM 共享。可以通过cudaGetDeviceProperties函数返回的l2CacheSize设备属性成员查询 L2 缓存的大小。
如上文共享内存中所述,L1 缓存在物理上位于每个 SM 上,与共享内存使用的是同一物理空间。如果核函数未使用任何共享内存,则整个物理空间都将由 L1 缓存使用。
可以通过一些函数控制 L2 和 L1 缓存,这些函数允许开发者指定各种缓存行为。有关这些函数的详细信息,请参阅配置 L1/共享内存平衡、L2 缓存控制和低级加载和存储函数。
如果不使用这些提示,编译器和运行时将尽力高效地利用缓存。
2.3.3.7. 纹理和表面内存
注意
一些较旧的 CUDA 代码可能会使用纹理内存,因为在较旧的 NVIDIA GPU 上,这样做在某些场景下可以带来性能收益。在当前所有受支持的 GPU 上,这些场景可以使用直接加载和存储指令来处理,使用纹理和表面内存指令对于非纹理加载不再提供任何性能收益。
GPU 可能具有专用指令,用于从图像中加载数据,作为 3D 渲染中的纹理使用。CUDA 通过纹理对象 API和表面对象 API公开这些指令以及使用这些指令的机制。
在当前任何受支持的 NVIDIA GPU 上,纹理和表面内存都不会为 CUDA 中的非图形应用程序提供任何性能优势。在为渲染读取纹理或表面数据时,这些 API 仍然有用,例如为NVIDIA OptiX编写命中着色器,NVIDIA OptiX 使用 CUDA 作为其着色器语言。
对于正在维护仍使用这些 API 进行非纹理加载的现有代码库的开发者,仍可在旧版CUDA C++ 编程指南中找到这些 API 的说明。
2.3.4. 内存性能
确保正确使用内存是 CUDA 核函数实现高性能的关键。本节讨论在 CUDA 核函数中从全局内存和共享内存获得高内存吞吐量的一些一般原则和示例。对于大多数核函数,全局内存性能是首要的性能考虑因素。当线程操作并非由其显式加载或创建的数据时,通常会使用共享内存,因此理解共享内存与性能相关的特征也很重要。
以下各小节将通过逐步改进一个矩阵转置示例核函数对全局内存和共享内存的访问,说明内存访问的重要方面。
2.3.4.1. 合并的全局内存访问
全局内存通过 32 字节的内存事务进行访问。当 CUDA 线程从全局内存请求一个字的数据时,相关线程束会根据每个线程访问的字的大小以及各线程所访问内存地址的分布,将该线程束中所有线程的内存请求合并成满足该请求所需数量的内存事务。例如,如果一个线程请求一个 4 字节的字,该线程束实际向全局内存发起的内存事务总计将为 32 字节。为了最高效地使用内存系统,线程束应使用单次内存事务所取回的全部内存。也就是说,如果一个线程正在从全局内存请求一个 4 字节的字,而事务大小为 32 字节,那么,如果该线程束中的其他线程能够使用该 32 字节请求中的其他 4 字节数据字,就能最高效地利用内存系统。
举一个简单的例子,如果线程束中连续的线程请求内存中连续的 4 字节字,那么该线程束总共将请求 128 字节的内存,所需的这 128 字节将通过四个 32 字节的内存事务取回。这使得线程束中的线程对内存事务的利用率达到 100%。图 12展示了这个完全合并的内存访问示例。
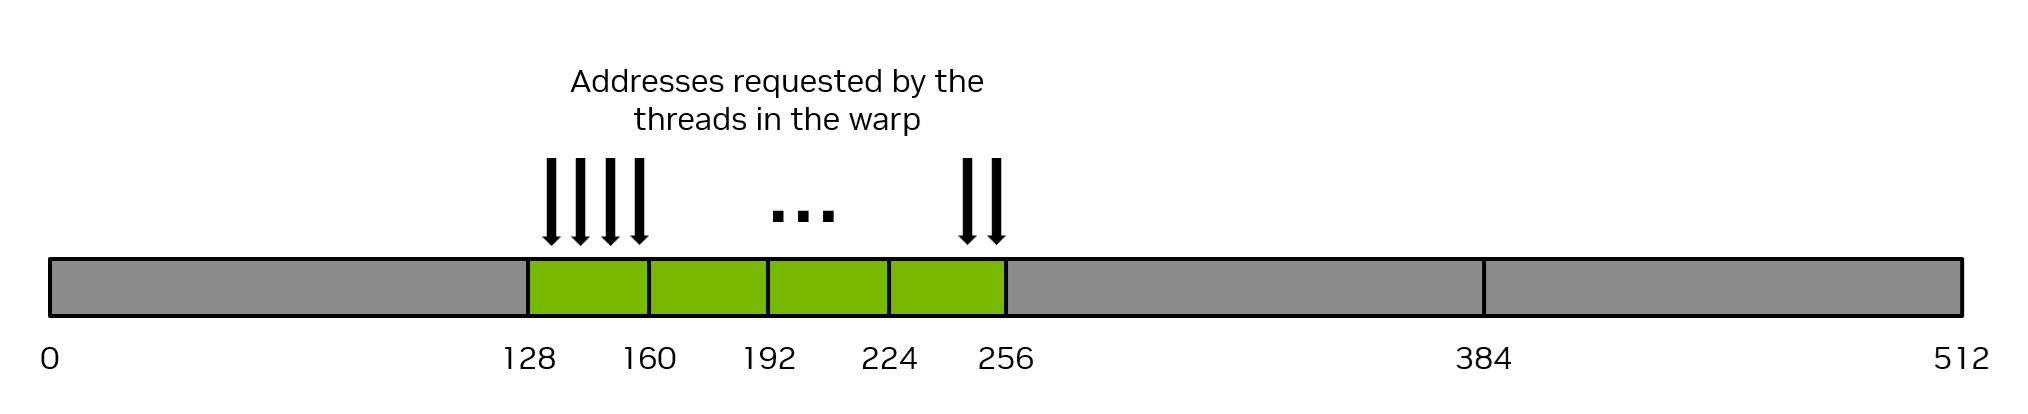
图 12 合并的内存访问
图内文字中文对照
Addresses requested by the threads in the warp- 线程束中的线程请求的地址
相反,极端的最坏情况是连续的线程访问在内存中彼此相隔 32 字节或更多的数据元素。在这种情况下,线程束将被迫为每个线程发起一个 32 字节的内存事务,内存流量的总字节数将为 32 字节乘以 32 线程/线程束 = 1024 字节。然而,实际使用的内存量仅为 128 字节(线程束中每个线程使用 4 字节),因此内存利用率仅为 128 / 1024 = 12.5%。这是一种效率非常低的内存系统使用方式。图 13展示了这个未合并的内存访问示例。
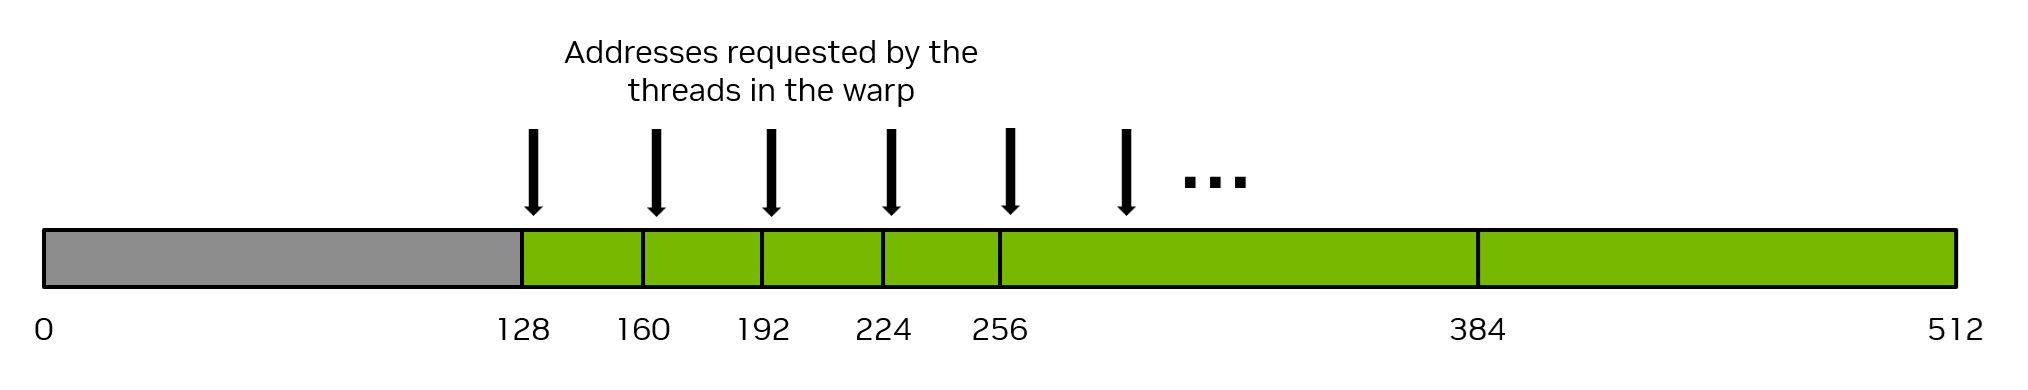
图 13 未合并的内存访问
图内文字中文对照
Addresses requested by the threads in the warp- 线程束中的线程请求的地址
实现合并的内存访问最直接的方法,是让连续的线程访问内存中连续的元素。例如,对于以一维线程块启动的核函数,前面展示的向量加法核函数将实现合并的内存访问。请注意线程访问这三个数组的方式:连续的线程(由workIndex的连续值表示)访问数组中的连续元素。
__global__ void vecAdd(float* A, float* B, float* C, int vectorLength)
{
int workIndex = threadIdx.x + blockIdx.x*blockDim.x;
if(workIndex < vectorLength)
{
C[workIndex] = A[workIndex] + B[workIndex];
}
}
## Defines a CUDA kernel to perform C = A + B vector addition
@cuda.jit
def vecadd(A, B, C):
work_index = cuda.grid(1)
C[work_index] = A[work_index] + B[work_index]
实现合并的内存访问并不要求连续的线程访问连续的内存元素,这仅仅是实现合并的典型方式。只要线程束中的不同线程以某种线性或置换的方式访问同一批 32 字节内存段中的元素,就会发生合并的内存访问。换句话说,实现合并的内存访问的最佳方法,是最大化已使用字节数与已传输字节数的比值。
理解全局内存访问合并的一种等价方式,是考虑需要多少次全局内存事务才能满足单个线程束的一条加载指令所请求的 32 个地址。在可能的最佳情况下,只需一次全局内存事务即可满足所有加载。对于对 4 字节数据元素的完全合并访问,需要 4 次全局内存事务。在最坏情况下,可能需要 32 次全局内存事务才能满足单个线程束的一条加载指令所请求的地址。一般而言,满足一次加载所需的全局内存事务数量尽可能少时,性能最佳。
注意
确保全局内存访问正确合并,是编写高性能 CUDA 核函数时最重要的性能考虑因素之一。应用程序必须尽可能高效地使用内存系统。
2.3.4.1.1. 使用全局内存的矩阵转置示例
举一个简单的例子,考虑一个非原地矩阵转置核函数,它将一个大小为 N x N 的 32 位浮点方阵从矩阵a转置到矩阵c。此示例使用二维网格,并假设启动大小为 32 x 32 个线程的二维线程块,即blockDim.x = 32和blockDim.y = 32,因此每个二维线程块将操作矩阵的一个 32 x 32 分块(tile)。每个线程操作矩阵中的一个唯一元素,因此不需要显式地同步线程。图 14展示了这一矩阵转置操作。核函数源代码位于图后。
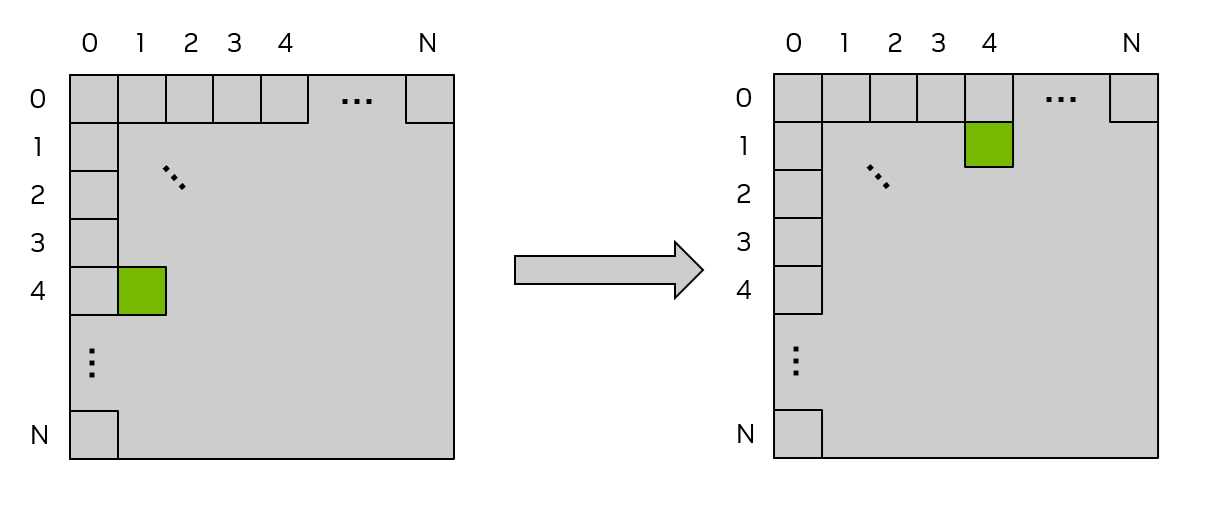
图 14 使用全局内存的矩阵转置
每个矩阵顶部和左侧的标签是二维线程块索引,也可以视为分块索引,其中每个小方格表示矩阵的一个分块,将由一个二维线程块对其进行操作。在此示例中,分块大小为 32 x 32 个元素,因此每个小方格都代表矩阵的一个 32 x 32 分块。绿色阴影方格显示了一个示例分块在转置操作前后的位置。
/* macro to index a 1D memory array with 2D indices in row-major order */
/* ld is the leading dimension, i.e. the number of columns in the matrix */
#define INDX( row, col, ld ) ( ( (row) * (ld) ) + (col) )
/* CUDA kernel for matrix transpose */
__global__ void cuda_transpose(int m, float *a, float *c )
{
int myCol = blockDim.x * blockIdx.x + threadIdx.x;
int myRow = blockDim.y * blockIdx.y + threadIdx.y;
if( myRow < m && myCol < m )
{
c[INDX( myCol, myRow, m )] = a[INDX( myRow, myCol, m )];
} /* end if */
return;
} /* end cuda_transpose */
import numpy as np
from numba import cuda
import cupy as cp
## Matrix transpose kernel, one thread per matrix element launched with
## 2D thread block on 2D grid to match matrix size
@cuda.jit
def transpose(a, c):
col = cuda.blockDim.x * cuda.blockIdx.x + cuda.threadIdx.x
row = cuda.blockDim.y * cuda.blockIdx.y + cuda.threadIdx.y
c[(col,row)] = a[(row,col)]
要确定此核函数是否实现了合并的内存访问,需要确定连续的线程是否正在访问连续的内存元素。在二维线程块中,x索引变化最快,因此threadIdx.x的连续值应当访问连续的内存元素。threadIdx.x出现在myCol中,可以观察到,当myCol是INDX宏的第二个参数时,连续的线程正在读取a的连续值,因此对a的读取是完全合并的。
然而,对c的写入并未合并,因为threadIdx.x的连续值(再次查看myCol)向c写入的元素彼此相隔ld(主维度)个元素。出现这一情况,是因为现在myCol是INDX宏的第一个参数,而当INDX的第一个参数递增 1 时,内存位置就会改变ld。当ld大于 32 时(只要矩阵大小大于 32 就会出现这种情况),这就等同于图 13中所示的极端情况。
为了缓解这些未合并的写入,可以使用共享内存,下一节将对此进行介绍。
2.3.4.2. 共享内存访问模式
共享内存具有 32 个存储体,其组织方式使得连续的 32 位字映射到连续的存储体。每个存储体的带宽为每时钟周期 32 位。
当同一线程束中的多个线程尝试访问同一存储体中的不同元素时,就会发生存储体冲突。在这种情况下,对该存储体中数据的访问将串行化,直到请求该存储体中数据的所有线程都已获得数据。这种访问串行化会导致性能损失。
当同一线程束中的多个线程访问(读取或写入)同一个共享内存位置时,这种情况会出现两种例外。对于读访问,该字会广播给请求它的线程。对于写访问,每个共享内存地址只由其中一个线程写入(由哪个线程执行写入是未定义的)。
图 15展示了一些跨步访问的示例。存储体内的红色方框表示共享内存中的一个唯一位置。
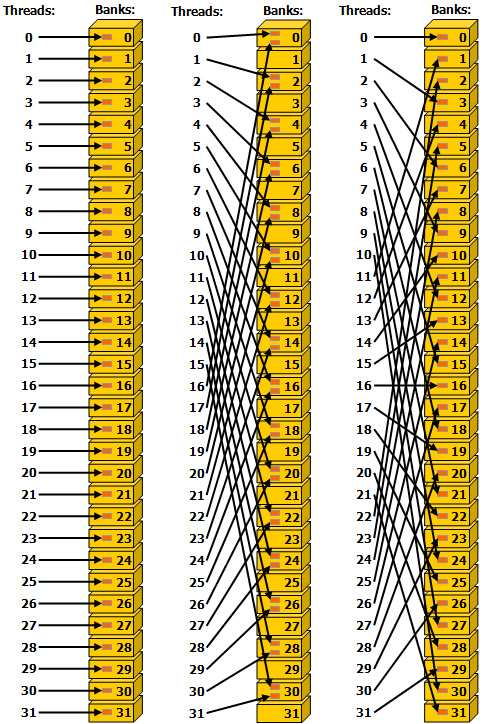
图 15 32 位存储体大小模式下的跨步共享内存访问。
- 左图
步长为一个 32 位字的线性寻址(无存储体冲突)。
- 中图
步长为两个 32 位字的线性寻址(两路存储体冲突)。
- 右图
步长为三个 32 位字的线性寻址(无存储体冲突)。
图内文字中文对照
Threads:- 线程:
Banks:- 存储体:
图 16展示了一些涉及广播机制的内存读访问示例。存储体内的红色方框表示共享内存中的一个唯一位置。如果多个箭头指向同一个位置,数据就会广播给所有请求它的线程。
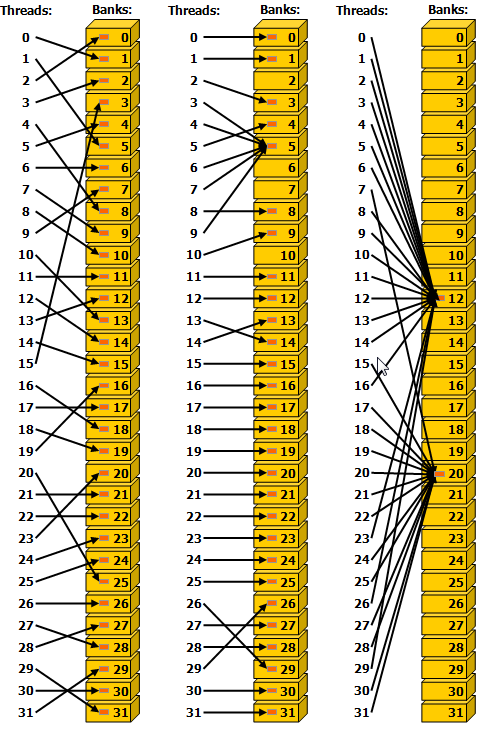
图 16 不规则共享内存访问。
- 左图
通过随机置换实现的无冲突访问。
- 中图
由于线程 3、4、6、7 和 9 访问存储体 5 中的同一个字,因此访问无冲突。
- 右图
无冲突的广播访问(线程访问某个存储体内的同一个字)。
图内文字中文对照
Threads:- 线程:
Banks:- 存储体:
注意
在编写使用共享内存的高性能 CUDA 核函数时,避免存储体冲突是一项重要的性能考量。
2.3.4.2.2. 共享内存存储体冲突
第 2.3.4.2 节介绍了共享内存的存储体结构。在前面的矩阵转置示例中,对全局内存的读写已实现恰当的合并内存访问,但没有考虑是否存在共享内存存储体冲突。考虑以下二维共享内存声明,
__shared__ float smemArray[32][32];
from numba import cuda
import numpy as np

smemArray = cuda.shared.array(shape=(32,32), dtype=np.float32)
假设预期以包含 32 x 32 个线程的二维线程块来启动核函数。由于一个线程束包含 32 个线程,特定线程束中的每个线程都将具有固定的threadIdx.y值,并且具有0 <= threadIdx.x < 32。
图 17的左图展示了线程束中的线程访问smemArray某一列数据时的情况。线程束 0 正在访问从smemArray[0][0]到smemArray[31][0]的内存位置(在 Python 中为从smemArray[(0,0)]到smemArray[(31,0)])。在 C++ 和 Python 的多维数组排列顺序中,最后一个索引变化最快,因此线程束 0 中连续的线程访问的内存位置相隔 32 个元素。如图所示,颜色表示存储体,而线程束 0 沿整列进行的这种访问会导致 32 路存储体冲突。
图 17的右图展示了线程束中的线程沿smemArray某一行访问数据时的情况。线程束 0 正在访问从smemArray[0][0]到smemArray[0][31]的内存位置(在 Python 中为从smemArray[(0,0)]到smemArray[(0,31)])。在这种情况下,线程束 0 中连续的线程访问的是相邻的内存位置。如图所示,颜色表示存储体,而线程束 0 沿整行进行的这种访问不会导致存储体冲突。理想情况是,线程束中的每个线程都访问一种不同颜色所对应的共享内存位置。
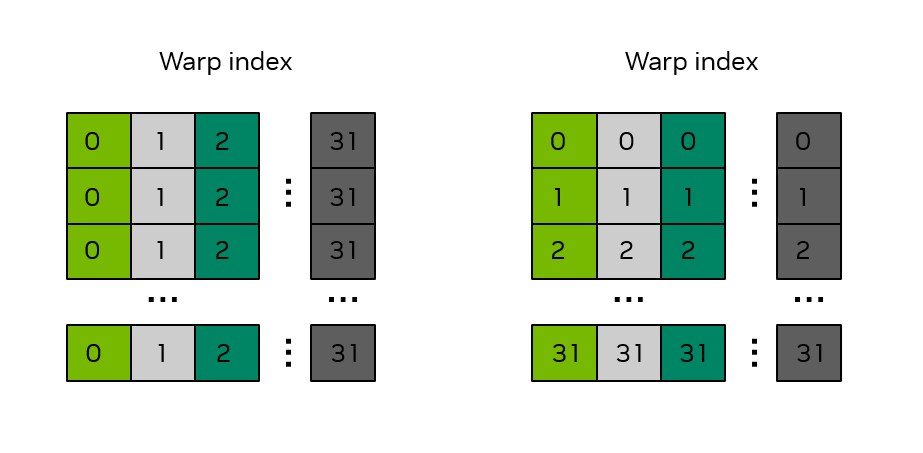
图 17 32 x 32 共享内存数组中的存储体结构。
方框中的数字表示线程束索引。颜色表示该共享内存位置对应哪个存储体。
图内文字中文对照
Warp index- 线程束索引
回到第 2.3.4.2.1 节中的示例,可以检查共享内存的使用方式,以确定是否存在存储体冲突。第一次使用共享内存是在将来自全局内存的数据存储到共享内存时:
smemArray[threadIdx.x][threadIdx.y] = a[INDX( tileRow + threadIdx.y, tileCol + threadIdx.x, m )];
smemArray[(cuda.threadIdx.x, cuda.threadIdx.y)] = a[(tile_row + cuda.threadIdx.y, tile_col + cuda.threadIdx.x)]
由于数组按行优先顺序存储,同一线程束中由threadIdx.x的连续值所表示的连续线程,将以 32 个元素的步长访问smemArray,因为threadIdx.x是数组的第一个索引。这会导致 32 路存储体冲突,如图 17的左图所示。
第二次使用共享内存是在将来自共享内存的数据写回全局内存时:
c[INDX( tileCol + threadIdx.y, tileRow + threadIdx.x, m )] = smemArray[threadIdx.y][threadIdx.x];
c[(tile_col + cuda.threadIdx.y, tile_row + cuda.threadIdx.x)] = smemArray[(cuda.threadIdx.y, cuda.threadIdx.x)]
在这种情况下,由于threadIdx.x是smemArray数组的第二个索引,同一线程束中的连续线程将以 1 个元素的步长访问smemArray。这不会导致存储体冲突,如图 17的右图所示。
第 2.3.4.2.1 节所示的矩阵转置核函数中,有一次共享内存访问不存在存储体冲突,另一次访问则存在 32 路存储体冲突。避免存储体冲突的一种常见修正方法是对共享内存进行填充,将数组的列维度增加 1,如下所示:
__shared__ float smemArray[THREADS_PER_BLOCK_X][THREADS_PER_BLOCK_Y+1];
smemArray = cuda.shared.array(shape=(32, 32 + 1), dtype=np.float32)
对smemArray声明的这一小幅调整将消除存储体冲突。为了说明这一点,请看图 18,其中共享内存数组被声明为 32 x 33 的大小。可以看到,无论同一线程束中的线程是沿整列还是沿整行访问共享内存数组,存储体冲突都已消除,即同一线程束中的线程访问的是不同颜色所对应的位置。
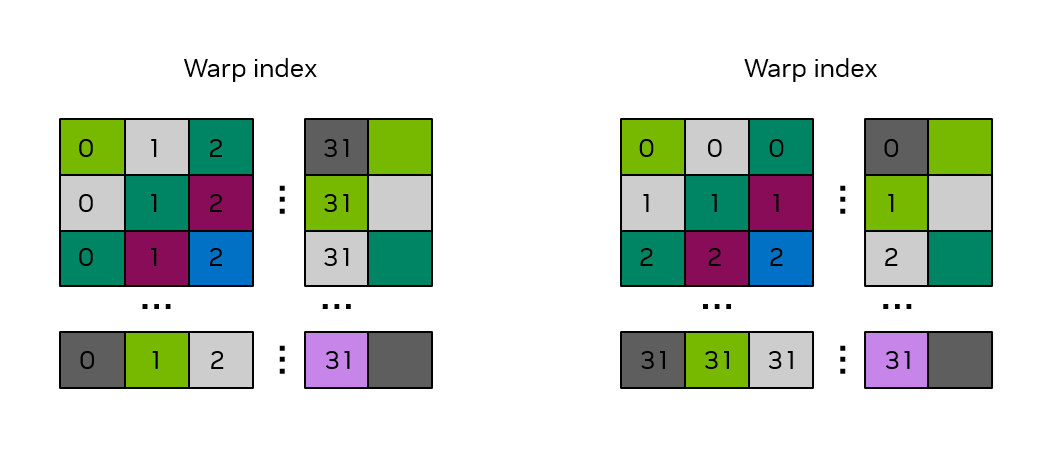
图 18 32 x 33 共享内存数组中的存储体结构。
方框中的数字表示线程束索引。颜色表示该共享内存位置对应哪个存储体。
图内文字中文对照
Warp index- 线程束索引
2.3.5. 原子操作
高性能 CUDA 核函数依赖于尽可能充分地表达算法并行性。GPU 核函数执行的异步性质要求线程尽可能独立地运行。线程并不总能完全独立,正如我们在共享内存中所见,存在一种机制,可让同一线程块中的线程交换数据并进行同步。
在整个网格层面上,没有这种机制来同步网格中的所有线程。不过,有一种机制可以通过使用原子函数来提供对全局内存位置的同步访问。原子函数允许线程获取某个全局内存位置上的锁,并对该位置执行读-修改-写操作。在持有锁期间,其他任何线程都无法访问同一位置。
2.3.5.1. 类似于 C++ std::atomic 的原子操作
在 C++ 中,CUDA 提供了与名称相似的 C++ 标准库原子类型cuda::std::atomic和cuda::std::atomic_ref类似的语法与行为。CUDA 还提供了扩展的 C++ 原子类型cuda::atomic和cuda::atomic_ref,允许用户指定原子操作的线程作用域。原子函数的详细信息在原子函数中介绍。
下面是使用cuda::atomic_ref执行设备范围原子加法的示例,其中array是一个浮点数数组,result是一个指向全局内存中某个位置的 float 指针,数组的总和将存储在该位置。
__global__ void sumReduction(int n, float *array, float *result) {
...
tid = threadIdx.x + blockIdx.x * blockDim.x;

cuda::atomic_ref<float, cuda::thread_scope_device> result_ref(result);
result_ref.fetch_add(array[tid]);
...
}
应谨慎、少量地使用原子函数,因为它们会强制线程同步,这可能影响性能。
2.3.5.2. Python 中的内存原子操作
在 Python 中,原子内存操作由numba.cuda.atomic命名空间中可供 GPU 代码使用的函数提供。可用的典型操作包括add、sub、max、min和compare_and_swap。受支持原子操作的完整列表见Numba CUDA 文档。
以下代码展示了一个使用原子内存访问来计算数组中所有值之和的核函数示例。每个线程块都将数组的一个切片加载到共享内存中。每个线程块中的一个线程计算局部和,并对结果数组s执行原子加法。由于数据位于共享内存中,而共享内存靠近 SM 的计算资源,因此让单个线程执行求和通常仍能获得相当不错的性能。
import numpy as np
from numba import cuda
import cupy as cp


@cuda.jit
def sum_reduce(a, s):
    ## create a shared array to support a block size up to 512 threads
    ## even though we'll use fewer in this example
    shared_staging = cuda.shared.array(shape=512, dtype=np.float32)

    ## Load values into shared memory and then synchronize to make sure all loads completed
    shared_staging[cuda.threadIdx.x] = a[cuda.blockIdx.x*cuda.blockDim.x + cuda.threadIdx.x]
    cuda.syncthreads()

    ## only thread 0 of each block does the local additions, followed by a single
    ## atomic operation per thread block
    local_sum = float(0.0)
    if cuda.threadIdx.x == 0:
        for i in range(cuda.blockDim.x):
            local_sum = local_sum + shared_staging[i]
        cuda.atomic.add(s, 0, local_sum)


array_length = 2**18

a = cp.ones(array_length)
s = cp.zeros(1, dtype=np.float32)

block_size = 256
grid_size = int(array_length/block_size)
sum_reduce[grid_size, block_size](a, s)

s_host = cp.asnumpy(s)
print(f"Sum is {int(s_host[0])}, expected {array_length}")
在这个简单示例中,输入数组的元素全为 1,因此正确的总和与array_length相同。
如果将这一行
cuda.atomic.add(s, 0, local_sum)
替换为非原子加法
s[0] = s[0] + local_sum
则对s[0]的访问将不是原子的,s[0]的最终值将小于array_length。此外,该值可能会随着每次运行以及在具有不同 SM 数量的 GPU 上运行而变化。这说明了在此代码中,必须使用原子内存访问才能保证正确性。
注意
此示例虽然能够正常工作,但并非旨在演示如何在 GPU 上编写具有峰值性能的归约操作。NVIDIA 的CUDA Core Compute Libraries (CCCL)为包括归约在内的许多操作提供了高性能原语。出于开发效率和性能两方面的考虑,开发者应尽可能优先使用这些经过高度调优的实现,而不是重新实现相同的算法。通过cuda.coop 包可以在 Python 中使用这些原语。
C++ 中也提供了类似的原子操作,第 5.4.5.1 节对此进行了讨论,但建议使用类似于std::atomic的原子操作,这被视为 CUDA C++ 中的最佳实践。
2.3.6. 协作组
协作组是 CUDA C++ 中提供的一种软件工具,它允许应用程序定义能够相互同步的线程组,即使该线程组跨越多个线程块、单个 GPU 上的多个网格,甚至跨越多个 GPU。CUDA 编程模型通常允许线程块或线程块簇中的线程高效地同步,但不提供指定小于一个线程块或簇的线程组的机制。同样,CUDA 编程模型也不提供支持跨线程块同步的机制或保证。
协作组通过软件提供上述两种能力。协作组允许应用程序创建跨越线程块和簇边界的线程组,不过这样做会带来一些语义限制和性能影响,介绍协作组的特性一节对此作了详细说明。
2.3.7. 核函数启动与占用率
当 CUDA 核函数启动时,CUDA 线程会根据核函数启动时指定的执行配置,组织为线程块和一个网格。核函数启动后,调度器会将线程块分配给 SM。应用程序无法控制或查询哪些线程块被调度到哪些 SM 上执行的细节,而且调度器不提供任何顺序保证,因此程序不能依赖特定的调度顺序或方案来保证正确执行。
一个 SM 上能够调度的线程块数量取决于给定线程块所需的硬件资源,以及该 SM 上可用的硬件资源。核函数刚启动时,调度器开始将线程块分配给 SM。只要 SM 有足够的、未被其他线程块占用的硬件资源,调度器就会继续向 SM 分配线程块。如果在某个时刻没有任何 SM 有能力接纳另一个线程块,调度器就会等待,直到 SM 完成先前分配的线程块。一旦完成,SM 就可以接纳更多工作,调度器便会向它们分配线程块。这个过程会持续进行,直到所有线程块都已被调度并执行完毕。
cudaGetDeviceProperties函数允许应用程序通过设备属性查询每个 SM 的限制。请注意,每个 SM 和每个线程块都有相应的限制。
maxBlocksPerMultiProcessor:每个 SM 的最大驻留块数。sharedMemPerMultiprocessor:每个 SM 的可用共享内存量,以字节为单位。regsPerMultiprocessor:每个 SM 的可用 32 位寄存器数。maxThreadsPerMultiProcessor:每个 SM 的最大驻留线程数。sharedMemPerBlock:一个线程块可分配的最大共享内存量,以字节为单位。regsPerBlock:一个线程块可分配的最大 32 位寄存器数。maxThreadsPerBlock:每个线程块的最大线程数。
CUDA 核函数的占用率是活跃线程束数与 SM 所支持的最大活跃线程束数之比。一般来说,尽可能提高占用率是一种良好做法,这可以隐藏延迟并提高性能。
要计算占用率,需要了解刚才介绍的 SM 资源限制,还需要了解所考察的 CUDA 核函数需要哪些资源。要确定每个核函数的资源使用情况,可以在程序编译期间使用nvcc的--resource-usage选项,它会显示核函数所需的寄存器数和共享内存量。
为便于说明,以计算能力为 10.0 的设备为例,其设备属性列于表 2。
资源 |
值 |
|---|---|
|
32 |
|
233472 |
|
65536 |
|
2048 |
|
49152 |
|
65536 |
|
1024 |
如果以testKernel<<<512, 768>>>()的方式启动核函数,即每个块有 768 个线程,则每个 SM 一次只能执行 2 个线程块。由于maxThreadsPerMultiProcessor为 2048,调度器无法为每个 SM 分配超过 2 个线程块。因此,占用率为 (768 * 2) / 2048,即 75%。
如果以testKernel<<<512, 32>>>()的方式启动核函数,即每个块有 32 个线程,则每个 SM 不会达到maxThreadsPerMultiProcessor的限制,但由于maxBlocksPerMultiProcessor为 32,调度器只能为每个 SM 分配 32 个线程块。由于块中的线程数为 32,SM 上的驻留线程总数为 32 个块 * 每个块 32 个线程,即总共 1024 个线程。由于计算能力为 10.0 的 SM 上,每个 SM 的最大驻留线程数为 2048,因此这种情况下的占用率为 1024 / 2048,即 50%。
对共享内存也可以进行同样的分析。例如,如果一个核函数使用 100KB 的共享内存,调度器就只能为每个 SM 分配 2 个线程块,因为该 SM 上的第三个线程块会再需要 100KB 的共享内存,总计 300KB,这超过了每个 SM 可用的 233472 字节。
每个块的线程数和每个块的共享内存使用量均由程序员显式控制,可以通过调整来达到期望的占用率。程序员对寄存器使用情况的控制有限,因为编译器和运行时会尝试优化寄存器使用。不过,程序员可以通过nvcc的--maxrregcount选项指定每个线程块的最大寄存器数。如果核函数所需的寄存器数超过此指定数量,核函数很可能会溢出到局部内存,从而改变核函数的性能特性。在某些情况下,即使发生溢出,限制寄存器数也能让更多线程块得到调度,进而提高占用率,并可能使性能获得净提升。