2.6. 统一内存与系统内存
异构系统具有多个可存储数据的物理内存。主机 CPU 连接有 DRAM,系统中的每个 GPU 也都连接有各自的 DRAM。当数据驻留在访问它的处理器的内存中时,性能最佳。CUDA 提供了用于显式管理内存放置的 API,但这可能使代码冗长,并使软件设计复杂化。CUDA 提供的功能和能力旨在简化不同物理内存之间的数据分配、放置和迁移。
本章旨在介绍并解释这些功能,以及它们在功能和性能方面对应用程序开发者的意义。统一内存有几种不同的表现形式,具体取决于所使用的操作系统、驱动程序版本和 GPU。本章将展示如何确定适用的统一内存范式,以及统一内存的各项功能在每种范式下的行为。后面的统一内存章节将更详细地解释统一内存。
本章将定义并解释以下概念:
统一虚拟地址空间:CPU 内存和每个 GPU 的内存在同一个虚拟地址空间中各自拥有不同的范围
统一内存:一种 CUDA 功能,支持可在 CPU 和 GPU 之间自动迁移的托管内存
有限统一内存:一种具有某些限制的统一内存范式
完整统一内存:对统一内存功能的完整支持
具有硬件相干性的完整统一内存:利用硬件能力提供对统一内存的完整支持
统一内存提示:用于指导特定内存分配的统一内存行为的 API
页锁定主机内存:不可分页的系统内存,某些 CUDA 操作需要使用此类内存
映射内存:一种从核函数直接访问主机内存的机制(不同于统一内存)
此外,这里还介绍讨论统一内存和系统内存时使用的以下术语:
异构托管内存(HMM):Linux 内核的一项功能,为完整统一内存提供软件相干性
地址转换服务(ATS):一项硬件功能,当 GPU 通过 NVLink Chip-to-Chip(C2C)互连连接到 CPU 时可用,为完整统一内存提供硬件相干性
2.6.1. 统一虚拟地址空间
在单个操作系统进程内,系统中的所有主机内存以及所有 GPU 上的全部全局内存都使用同一个虚拟地址空间。主机和所有设备上的全部内存分配都位于此虚拟地址空间中。无论使用 CUDA API(例如cudaMalloc、cudaMallocHost)还是系统分配 API(例如new、malloc、mmap)进行分配,都是如此。CPU 和每个 GPU 在统一虚拟地址空间中都拥有各自独有的范围。
这意味着:
可以使用
cudaPointerGetAttributes()根据指针的值确定任意内存的位置(即它位于 CPU 内存还是哪个 GPU 的内存中)可以将
cudaMemcpy*()的cudaMemcpyKind参数设置为cudaMemcpyDefault,以便根据指针自动确定复制类型
2.6.2. 统一内存
统一内存是一项 CUDA 内存功能,它允许在 CPU 或 GPU 上运行的代码访问称为托管内存的内存分配。C++ 中的 CUDA 入门中展示过统一内存。所有受 CUDA 支持的系统都可使用统一内存。
在某些系统上,必须显式分配托管内存。在 CUDA 中,可以通过几种不同的方式显式分配托管内存:
CUDA API
cudaMallocManagedCUDA API
cudaMallocFromPoolAsync,使用创建时将allocType设置为cudaMemAllocationTypeManaged的内存池带有
__managed__说明符的全局变量(请参阅内存空间说明符)
在具有HMM或ATS的系统上,所有系统内存都隐式地属于托管内存,无论其分配方式如何。无需特殊的分配方式。
2.6.2.1. 统一内存范式
统一内存的功能和行为会因操作系统、Linux 内核版本、GPU 硬件以及 GPU 与 CPU 之间的互连而异。可以使用cudaDeviceGetAttribute查询几个属性,以确定可用的统一内存形式:
cudaDevAttrConcurrentManagedAccess:1 表示完整的统一内存支持,0 表示有限支持cudaDevAttrPageableMemoryAccess:1 表示所有系统内存都是获得完整支持的统一内存,0 表示只有显式分配为托管内存的内存才是获得完整支持的统一内存cudaDevAttrPageableMemoryAccessUsesHostPageTables:指示 CPU/GPU 相干性的实现机制:1 表示硬件,0 表示软件。
图 21直观地展示了如何确定统一内存范式,其后给出了实现相同逻辑的代码示例。
统一内存的运行有四种范式:
当提供完整支持时,可能需要显式分配,也可能所有系统内存都隐式地属于统一内存。当所有内存都隐式地属于统一内存时,相干性机制可以是软件机制,也可以是硬件机制。Windows 和某些 Tegra 设备对统一内存的支持有限。
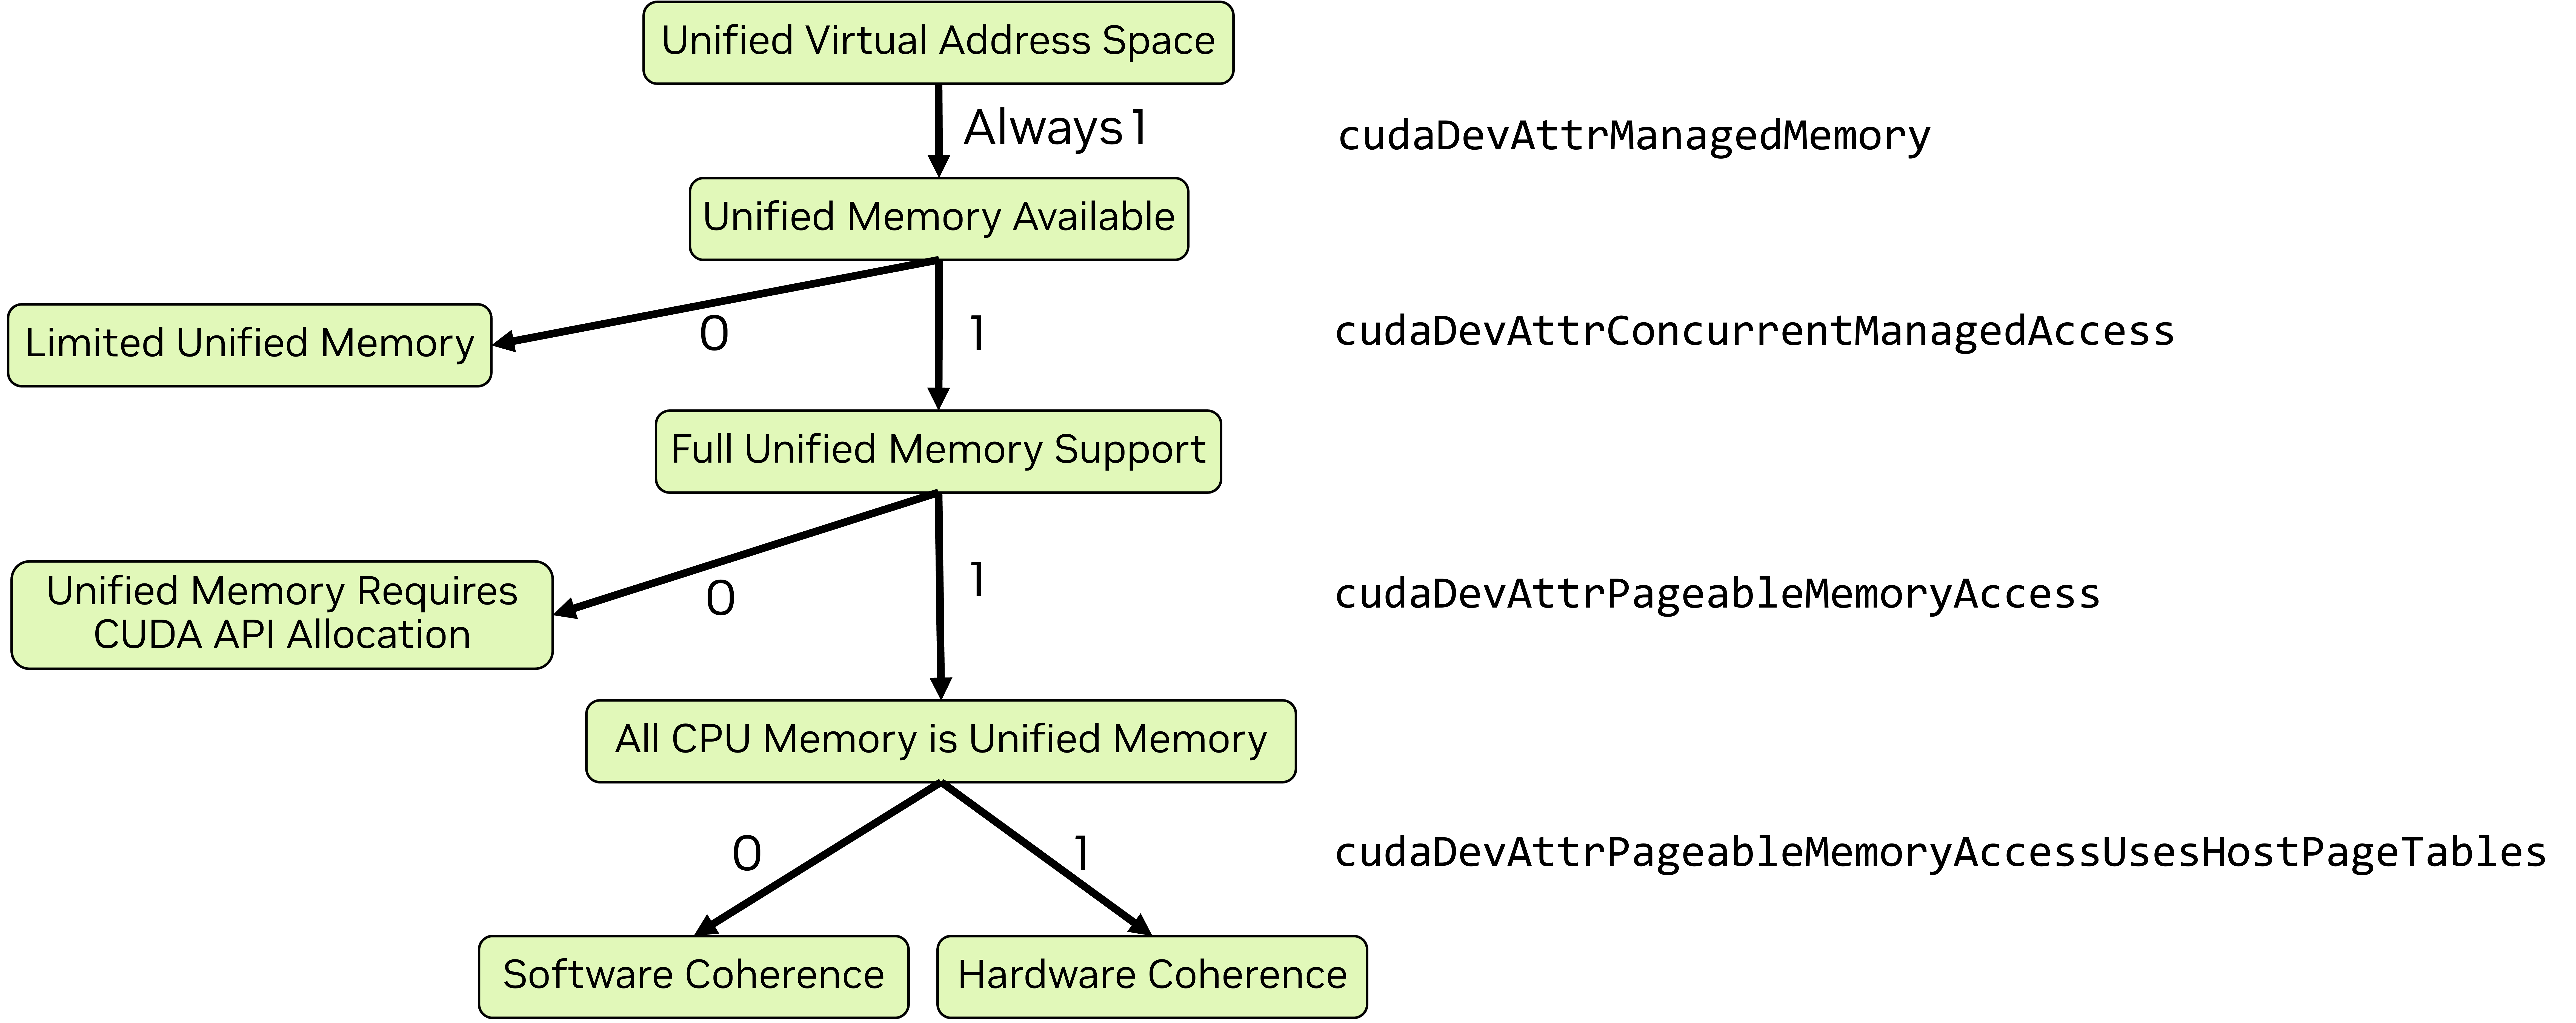
图 21 当前所有 GPU 都使用统一虚拟地址空间,并且都可使用统一内存。当cudaDevAttrConcurrentManagedAccess为 1 时,可获得完整的统一内存支持,否则只能获得有限支持。当提供完整支持时,如果cudaDevAttrPageableMemoryAccess也为 1,则所有系统内存都是统一内存。否则,只有使用 CUDA API(例如cudaMallocManaged)分配的内存才是统一内存。当所有系统内存都是统一内存时,cudaDevAttrPageableMemoryAccessUsesHostPageTables指示相干性是由硬件提供(值为 1 时)还是由软件提供(值为 0 时)。
图内文字中文对照
Unified Virtual Address Space- 统一虚拟地址空间
Always 1- 始终为 1
Unified Memory Available- 统一内存可用
Limited Unified Memory- 有限的统一内存
Full Unified Memory Support- 完整的统一内存支持
Unified Memory Requires CUDA API Allocation- 统一内存要求通过 CUDA API 分配
All CPU Memory is Unified Memory- 所有 CPU 内存均为统一内存
Software Coherence- 软件相干性
Hardware Coherence- 硬件相干性
表 3以表格形式呈现了与图 21相同的信息,并提供了指向本章相关小节以及本指南后续章节中更完整文档的链接。
统一内存范式 |
设备属性 |
完整文档 |
|---|---|---|
cudaDevAttrConcurrentManagedAccess为 0 |
||
cudaDevAttrPageableMemoryAccess为 0且
cudaDevAttrConcurrentManagedAccess为 1 |
||
cudaDevAttrPageableMemoryAccessUsesHostPageTables为 0且
cudaDevAttrPageableMemoryAccess为 1且
cudaDevAttrConcurrentManagedAccess为 1 |
||
cudaDevAttrPageableMemoryAccessUsesHostPageTables为 1且
cudaDevAttrPageableMemoryAccess为 1且
cudaDevAttrConcurrentManagedAccess为 1 |
2.6.2.1.1. 统一内存范式:代码示例
以下代码示例演示了如何按照图 21中的逻辑,针对系统中的每个 GPU 查询设备属性并确定统一内存范式。
void queryDevices()
{
    int numDevices = 0;
    cudaGetDeviceCount(&numDevices);
    for(int i=0; i<numDevices; i++)
    {
        cudaSetDevice(i);
        cudaInitDevice(0, 0, 0);
        int deviceId = i;

        int concurrentManagedAccess = -1;
        cudaDeviceGetAttribute (&concurrentManagedAccess, cudaDevAttrConcurrentManagedAccess, deviceId);
        int pageableMemoryAccess = -1;
        cudaDeviceGetAttribute (&pageableMemoryAccess, cudaDevAttrPageableMemoryAccess, deviceId);
        int pageableMemoryAccessUsesHostPageTables = -1;
        cudaDeviceGetAttribute (&pageableMemoryAccessUsesHostPageTables, cudaDevAttrPageableMemoryAccessUsesHostPageTables, deviceId);

        printf("Device %d has ", deviceId);
        if(concurrentManagedAccess){
            if(pageableMemoryAccess){
                printf("full unified memory support");
                if( pageableMemoryAccessUsesHostPageTables)
                    { printf(" with hardware coherency\n");  }
                else
                    { printf(" with software coherency\n"); }
            }
            else
                { printf("full unified memory support for CUDA-made managed allocations\n"); }
        }
        else
        {   printf("limited unified memory support: Windows, WSL, or Tegra\n");  }
    }
}
2.6.2.2. 统一内存功能的完整支持
大多数 Linux 系统都完整支持统一内存。如果设备属性cudaDevAttrPageableMemoryAccess为 1,则所有系统内存,无论是通过 CUDA API 还是系统 API 分配的,都作为具有完整功能支持的统一内存运行。这包括使用mmap创建的文件后备内存分配。
如果cudaDevAttrPageableMemoryAccess为 0,则只有由 CUDA 分配为托管内存的内存才具有统一内存的行为。通过系统 API 分配的内存不是托管内存,GPU 核函数不一定能够访问它。
一般而言,对于获得完整支持的统一内存分配:
托管内存通常分配在首次访问它的处理器的内存空间中
当托管内存被其当前所在处理器之外的处理器使用时,通常会发生迁移
托管内存以内存页(软件相干性)或缓存行(硬件相干性)为粒度进行迁移或访问
允许超额分配:应用程序分配的托管内存可以超过 GPU 上实际可用的物理内存容量
分配和迁移行为可能与上述情况不同。程序员可以使用提示和预取影响这些行为。有关完整统一内存支持的全面介绍,请参阅完整支持 CUDA 统一内存的设备上的统一内存。
2.6.2.2.1. 具有硬件相干性的完整统一内存
在 Grace Hopper 和 Grace Blackwell 等硬件上,使用的是 NVIDIA CPU,且 CPU 与 GPU 之间的互连为 NVLink Chip-to-Chip(C2C),因此可使用地址转换服务(ATS)。当 ATS 可用时,cudaDevAttrPageableMemoryAccessUsesHostPageTables为 1。
使用 ATS 时,除了为所有主机内存分配提供完整的统一内存支持之外,还具备以下能力:
驻留在 GPU 上的托管内存分配(例如
cudaMallocManaged)无需迁移即可从 CPU 访问(cudaDevAttrDirectManagedMemAccessFromHost将为 1)CPU 与 GPU 之间的链路支持原生原子操作(
cudaDevAttrHostNativeAtomicSupported将为 1)与软件相干性相比,硬件对相干性的支持可以提高性能
ATS 提供HMM的所有能力。当 ATS 可用时,HMM 会自动禁用。有关硬件相干性与软件相干性的进一步讨论,请参阅CPU 和 GPU 页表:硬件相干性与软件相干性。
注意
硬件相干性并不使主机能够访问仅供 GPU 使用的内存分配,例如使用cudaMalloc进行的分配。
2.6.2.2.2. HMM:具有软件相干性的完整统一内存
异构内存管理(HMM)是 Linux 操作系统(具有适当的内核版本)上提供的一项功能,可实现具有软件相干性的完整统一内存支持。异构内存管理为通过 PCIe 连接的 GPU 带来了 ATS 所提供的部分能力和便利。
在使用至少为 Linux 内核 6.1.24、6.2.11 或 6.3 或更高版本的 Linux 系统上,异构内存管理(HMM)可能可用。可以使用以下命令确定寻址模式是否为HMM。
$ nvidia-smi -q | grep Addressing
Addressing Mode : HMM
当 HMM 可用时,系统支持完整统一内存,且所有系统内存分配都隐式地属于统一内存。如果系统还具有ATS,则会禁用 HMM 并使用 ATS,因为 ATS 提供了 HMM 的全部能力以及更多能力。
2.6.2.3. 有限的统一内存支持
在 Windows(包括 Windows Subsystem for Linux,WSL)以及某些 Tegra 系统上,只能使用统一内存功能的一个有限子集。在这些系统上,托管内存可用,但 CPU 与 GPU 之间的迁移行为有所不同。
托管内存首先在 CPU 的物理内存中分配
托管内存以比虚拟内存页更大的粒度迁移
当 GPU 开始执行时,托管内存会迁移到 GPU
在 GPU 处于活动状态时,CPU 不得访问托管内存
当对 GPU 进行同步时,托管内存会迁移回 CPU
不允许超额分配 GPU 内存
只有由 CUDA 显式分配为托管内存的内存才是统一内存
有关此范式的全面介绍,请参阅Windows、WSL 和 Tegra 上的统一内存。
2.6.2.4. 内存建议和预取
程序员可以向管理统一内存的 NVIDIA 驱动程序提供提示,以帮助其最大限度地提高应用程序性能。CUDA APIcudaMemAdvise允许程序员指定内存分配的属性,这些属性会影响内存分配的放置位置,以及从另一个设备访问时内存是否迁移。
cudaMemPrefetchAsync允许程序员建议启动将特定内存分配异步迁移到另一位置的操作。一种常见用途是在核函数启动之前,开始传输该核函数将要使用的数据。这样,便可在其他 GPU 核函数执行期间复制数据。
性能提示一节介绍了可以传递给cudaMemAdvise的各种提示,并展示了使用cudaMemPrefetchAsync的示例。
2.6.3. 页锁定主机内存
在入门代码示例中,使用了cudaMallocHost在 CPU 上分配内存。这会在主机上分配页锁定内存(也称为页锁定内存)。通过malloc、new或mmap等传统分配机制进行的主机内存分配不是页锁定的,这意味着操作系统可能将其换出到磁盘,或改变其物理位置。
CPU 与 GPU 之间的异步复制需要使用页锁定主机内存。页锁定主机内存还可以提高同步复制的性能。页锁定内存可以映射到 GPU,以供 GPU 核函数直接访问。
CUDA 运行时提供了用于分配页锁定主机内存或对现有内存分配进行页锁定的 API:
cudaMallocHost分配页锁定主机内存cudaHostAlloc的默认行为与cudaMallocHost相同,但还接受用于指定其他内存参数的标志cudaFreeHost释放使用cudaMallocHost或cudaHostAlloc分配的内存cudaHostRegister对在 CUDA API 之外分配的一段现有内存进行页锁定,例如使用malloc或mmap分配的内存
cudaHostRegister允许对第三方库或开发者无法控制的其他代码所分配的主机内存进行页锁定,以便将其用于异步复制或进行映射。
注意
系统中的所有 GPU 都可以使用页锁定主机内存进行异步复制和内存映射。
在不具备 I/O 相干性的 Tegra 设备上,页锁定主机内存不会被缓存。此外,不具备 I/O 相干性的 Tegra 设备不支持cudaHostRegister()。
2.6.3.1. 映射内存
在具有HMM或ATS的系统上,可以在 GPU 上使用主机指针直接访问所有主机内存。当 ATS 或 HMM 不可用时,可以通过将主机内存映射到 GPU 的内存空间,使 GPU 能够访问主机内存分配。映射内存始终是页锁定的。
后面的代码示例将展示以下数组复制核函数如何直接操作映射的主机内存。
__global__ void copyKernel(float* a, float* b)
{
        int idx = threadIdx.x + blockDim.x * blockIdx.x;
        a[idx] = b[idx];
}
在某些情况下,需要从核函数访问未复制到 GPU 的特定数据,此时映射内存可能有用,但在核函数中访问映射内存需要通过 CPU 与 GPU 之间的互连(PCIe 或 NVLink C2C)进行事务。与访问设备内存相比,这些操作的延迟更高、带宽更低。对于核函数的大部分内存需求,不应将映射内存视为统一内存或显式内存管理的高性能替代方案。
2.6.3.1.1. cudaMallocHost 和 cudaHostAlloc
使用cudaMallocHost或cudaHostAlloc分配的主机内存会自动映射。这些 API 返回的指针可以直接用于核函数代码,以访问主机上的内存。对主机内存的访问通过 CPU 与 GPU 之间的互连进行。
void usingMallocHost() {
  float* a = nullptr;
  float* b = nullptr;

  CUDA_CHECK(cudaMallocHost(&a, vLen*sizeof(float)));
  CUDA_CHECK(cudaMallocHost(&b, vLen*sizeof(float)));

  initVector(b, vLen);
  memset(a, 0, vLen*sizeof(float));

  int threads = 256;
  int blocks = vLen/threads;
  copyKernel<<<blocks, threads>>>(a, b);
  CUDA_CHECK(cudaGetLastError());
  CUDA_CHECK(cudaDeviceSynchronize());

  printf("Using cudaMallocHost: ");
  checkAnswer(a,b);
}
void usingCudaHostAlloc() {
  float* a = nullptr;
  float* b = nullptr;

  CUDA_CHECK(cudaHostAlloc(&a, vLen*sizeof(float), cudaHostAllocMapped));
  CUDA_CHECK(cudaHostAlloc(&b, vLen*sizeof(float), cudaHostAllocMapped));

  initVector(b, vLen);
  memset(a, 0, vLen*sizeof(float));

  int threads = 256;
  int blocks = vLen/threads;
  copyKernel<<<blocks, threads>>>(a, b);
  CUDA_CHECK(cudaGetLastError());
  CUDA_CHECK(cudaDeviceSynchronize());

  printf("Using cudaHostAlloc: ");
  checkAnswer(a, b);
}
2.6.3.1.2. cudaHostRegister
当 ATS 和 HMM 不可用时,仍可使用cudaHostRegister对系统分配器分配的内存进行映射,以便 GPU 核函数直接访问。不过,与使用 CUDA API 创建的内存不同,核函数不能使用主机指针访问这类内存。必须使用cudaHostGetDevicePointer()获取设备内存区域中的指针,并且必须使用该指针在核函数代码中进行访问。
void usingRegister() {
  float* a = nullptr;
  float* b = nullptr;
  float* devA = nullptr;
  float* devB = nullptr;

  a = (float*)malloc(vLen*sizeof(float));
  b = (float*)malloc(vLen*sizeof(float));
  CUDA_CHECK(cudaHostRegister(a, vLen*sizeof(float), 0 ));
  CUDA_CHECK(cudaHostRegister(b, vLen*sizeof(float), 0  ));

  CUDA_CHECK(cudaHostGetDevicePointer((void**)&devA, (void*)a, 0));
  CUDA_CHECK(cudaHostGetDevicePointer((void**)&devB, (void*)b, 0));

  initVector(b, vLen);
  memset(a, 0, vLen*sizeof(float));

  int threads = 256;
  int blocks = vLen/threads;
  copyKernel<<<blocks, threads>>>(devA, devB);
  CUDA_CHECK(cudaGetLastError());
  CUDA_CHECK(cudaDeviceSynchronize());

  printf("Using cudaHostRegister: ");
  checkAnswer(a, b);
}
2.6.3.1.3. 统一内存与映射内存的比较
映射内存使 GPU 能够访问 CPU 内存,但并不保证所有系统都支持所有类型的访问,例如原子操作。统一内存保证支持所有访问类型。
映射内存始终位于 CPU 内存中,这意味着所有 GPU 访问都必须通过 CPU 与 GPU 之间的连接,即 PCIe 或 NVLink。通过这些链路进行访问的延迟显著高于访问 GPU 内存的延迟,而且可用的总带宽也更低。因此,所有核函数内存访问都使用映射内存不太可能充分利用 GPU 计算资源。
统一内存通常会迁移到访问它的处理器的物理内存中。首次迁移之后,核函数对同一内存页或缓存行的重复访问可以充分利用 GPU 内存带宽。
注意
在以前的文档中,映射内存也被称为零拷贝内存。
在所有 CUDA 应用程序都使用统一虚拟地址空间之前,需要额外的 API 来启用内存映射(cudaSetDeviceFlags搭配cudaDeviceMapHost)。这些 API 现在已不再需要。
从主机或其他 GPU 的角度来看,对映射主机内存执行操作的原子函数(参见原子函数)并不具有原子性。
CUDA 运行时要求,从主机和其他设备的角度来看,由设备发起的对主机内存的 1 字节、2 字节、4 字节、8 字节和 16 字节自然对齐的加载和存储必须保持为单次访问。在某些平台上,对内存的原子操作可能会被硬件拆分为独立的加载和存储操作。这些组成部分中的加载和存储操作在保持自然对齐访问方面有同样的要求。CUDA 运行时不支持 PCI Express 桥接器会拆分 8 字节自然对齐操作的 PCI Express 总线拓扑,并且 NVIDIA 尚不知道有任何拓扑会拆分 16 字节自然对齐的操作。
2.6.4. 总结
在具有异构内存管理(HMM)或地址转换服务(ATS)的 Linux 平台上,所有由系统分配的内存都是托管内存
在没有 HMM 或 ATS 的 Linux 平台、Tegra 处理器以及所有 Windows 平台上,必须使用 CUDA 分配托管内存:
cudaMallocManaged或cudaMallocFromPoolAsync搭配使用allocType=cudaMemAllocationTypeManaged创建的内存池带有
__managed__说明符的全局变量
在 Windows 和 Tegra 处理器上,统一内存存在限制
在具有 ATS 且通过 NVLINK C2C 连接的系统上,CPU 或其他 GPU 可以直接访问使用
cudaMallocManaged分配的设备内存