3.1. 高级 CUDA API 和特性
本节将介绍更高级的 CUDA API 和特性的使用。这些主题涵盖的技术或特性通常不需要修改 CUDA 核函数,但仍然可以从主机端影响应用程序级别的行为,既涉及 GPU 工作的执行和性能,也涉及 CPU 端的性能。
3.1.1. cudaLaunchKernelEx
在最初的版本中引入三重尖括号表示法时,核函数的核函数配置只有四个可编程参数:
线程块维度
网格维度
动态共享内存(可选,未指定时为 0)
流(未指定时使用默认流)
某些 CUDA 特性可以受益于随核函数启动一起提供的附加属性和提示。cudaLaunchKernelEx使程序能够通过cudaLaunchConfig_t结构设置上述执行配置参数。此外,cudaLaunchConfig_t结构允许程序传入零个或多个cudaLaunchAttributes,以控制核函数启动的其他参数或为这些参数提供建议。例如,本章稍后讨论的cudaLaunchAttributePreferredSharedMemoryCarveout(请参阅配置 L1/共享内存平衡)使用cudaLaunchKernelEx指定。本章稍后讨论的cudaLaunchAttributeClusterDimension属性用于指定核函数启动所需的簇大小。
支持的属性的完整列表及其含义记录在CUDA 运行时 API 参考文档中。
3.1.2. 启动簇:
前面各节介绍的线程块簇是在计算能力 9.0 及更高版本中提供的一种可选线程块组织层级,使应用程序能够保证一个簇中的线程块在单个 GPC 上同时执行。这使得规模超过单个 SM 容量的线程组能够相互交换数据并同步。
第 2.1.10.1 节这一节展示了如何使用三重尖括号表示法指定并启动使用簇的核函数。在该节中,使用__cluster_dims__注解指定了启动核函数时必须使用的簇维度。使用三重尖括号表示法时,簇的大小是隐式确定的。
3.1.2.1. 使用 cudaLaunchKernelEx 以簇方式启动
与使用三重尖括号表示法以簇方式启动核函数不同,线程块簇的大小可以针对每次启动进行配置。下面的代码示例展示了如何使用cudaLaunchKernelEx启动簇核函数。
// Kernel definition
// No compile time attribute attached to the kernel
__global__ void cluster_kernel(float *input, float* output)
{

}

int main()
{
    float *input, *output;
    dim3 threadsPerBlock(16, 16);
    dim3 numBlocks(N / threadsPerBlock.x, N / threadsPerBlock.y);

    // Kernel invocation with runtime cluster size
    {
        cudaLaunchConfig_t config = {0};
        // The grid dimension is not affected by cluster launch, and is still enumerated
        // using number of blocks.
        // The grid dimension should be a multiple of cluster size.
        config.gridDim = numBlocks;
        config.blockDim = threadsPerBlock;

        cudaLaunchAttribute attribute[1];
        attribute[0].id = cudaLaunchAttributeClusterDimension;
        attribute[0].val.clusterDim.x = 2; // Cluster size in X-dimension
        attribute[0].val.clusterDim.y = 1;
        attribute[0].val.clusterDim.z = 1;
        config.attrs = attribute;
        config.numAttrs = 1;

        cudaLaunchKernelEx(&config, cluster_kernel, input, output);
    }
}
有两种cudaLaunchAttribute类型与线程块簇簇相关:cudaLaunchAttributeClusterDimension和cudaLaunchAttributePreferredClusterDimension。
属性 IDcudaLaunchAttributeClusterDimension指定执行簇时所需的维度。该属性的值clusterDim是一个三维值。网格的对应维度(x、y 和 z)必须能够被指定簇维度的相应维度整除。设置该属性类似于编译时在核函数定义上使用__cluster_dims__属性,如使用三重尖括号表示法以簇方式启动所示,但可以在运行时针对同一核函数的不同启动进行更改。
在计算能力为 10.0 及更高版本的 GPU 上,另一个属性 IDcudaLaunchAttributePreferredClusterDimension允许应用程序额外为簇指定首选维度。首选维度必须是核函数上的__cluster_dims__属性或传给cudaLaunchKernelEx的cudaLaunchAttributeClusterDimension属性所指定的最小簇维度的整数倍。也就是说,除了首选簇维度之外,还必须指定最小簇维度。网格的对应维度(x、y 和 z)必须能够被指定的首选簇维度的相应维度整除。
所有线程块都将在维度至少为最小簇维度的簇中执行。在可能的情况下,将使用首选维度的簇,但并不保证所有簇都以首选维度执行。所有线程块都将在具有最小簇维度或首选簇维度的簇中执行。对于使用首选簇维度的核函数,编写时必须确保它们在最小簇维度或首选簇维度下都能正确运行。
3.1.2.2. 将线程块视为簇
使用__cluster_dims__注解定义核函数时,网格中的簇数是隐式的,可以通过将网格大小除以指定的簇大小来计算。
__cluster_dims__((2, 2, 2)) __global__ void foo();

// 8x8x8 clusters each with 2x2x2 thread blocks.
foo<<<dim3(16, 16, 16), dim3(1024, 1, 1)>>>();
在上面的示例中,核函数作为一个包含 16x16x16 个线程块的网格启动,这意味着使用了一个包含 8x8x8 个簇的网格。
核函数也可以使用__block_size__注解,该注解在定义核函数时同时指定所需的线程块大小和簇大小。使用此注解时,三重尖括号启动中的网格维度将以簇而不是线程块为单位,如下所示。
// Implementation detail of how many threads per block and blocks per cluster
// is handled as an attribute of the kernel.
__block_size__((1024, 1, 1), (2, 2, 2)) __global__ void foo();

// 8x8x8 clusters.
foo<<<dim3(8, 8, 8)>>>();
__block_size__需要两个字段,每个字段都是一个包含 3 个元素的元组。第一个元组表示线程块维度,第二个元组表示簇大小。如果未传递第二个元组,则假定其为(1,1,1)。在核函数启动期间指定动态共享内存大小和/或流时,<<<>>>中的第二个参数必须是占位符1。任何其他值都会导致未定义行为。
注意,不允许同时指定__block_size__的第二个元组和__cluster_dims__。也不允许将__block_size__与空的__cluster_dims__一起使用。指定__block_size__的第二个元组时,意味着启用了“将线程块视为簇”,编译器会将<<<>>>中的第一个参数识别为簇数,而不是线程块数。
3.1.3. 关于流和事件的更多内容
CUDA 流介绍了 CUDA 流的基础知识。默认情况下,在给定 CUDA 流上提交的操作是串行化的:一个操作必须等到前一个操作完成后才能开始执行。唯一的例外是最近添加的程序化依赖启动与同步特性。使用多个 CUDA 流是启用并发执行的一种方式;另一种方式是使用CUDA 图。这两种方法也可以结合使用。
在不同 CUDA 流上提交的工作,在特定情况下可能会并发执行,例如,不存在事件依赖、不存在隐式同步、资源充足等。
如果在来自不同 CUDA 流的独立操作之间向 NULL 流提交了任何 CUDA 操作,则这些独立操作无法并发运行,除非这些流是非阻塞 CUDA 流。非阻塞 CUDA 流是使用带有cudaStreamNonBlocking标志的cudaStreamCreateWithFlags()运行时 API 创建的流。为了提高 GPU 工作并发执行的可能性,建议用户创建非阻塞 CUDA 流。
还建议用户选择足以解决其问题且适用范围最小的同步选项。例如,如果要求 CPU 等待(阻塞),直到特定 CUDA 流上的所有工作完成,那么对该流使用cudaStreamSynchronize()会优于使用cudaDeviceSynchronize(),因为后者会不必要地等待该设备所有 CUDA 流上的 GPU 工作完成。如果要求 CPU 以非阻塞方式等待,那么使用cudaStreamQuery()并在轮询循环中检查其返回值可能更为合适。
使用 CUDA 事件(CUDA 事件)也可以实现类似的同步效果,例如,在该流上记录一个事件,然后调用cudaEventSynchronize()以阻塞方式等待该事件所捕获的工作完成。同样,与使用cudaDeviceSynchronize()相比,这样做更合适,也更有针对性。调用cudaEventQuery()并检查其返回值(例如在轮询循环中)则是一种非阻塞的替代方式。
如果此操作位于应用程序的关键路径上,显式同步方法的选择就尤为重要。表 4概要总结了与主机同步的各种选项。
等待特定流 |
等待特定事件 |
等待设备上的所有工作 |
|
|---|---|---|---|
非阻塞(需要轮询循环) |
cudaStreamQuery() |
cudaEventQuery() |
N/A |
阻塞 |
cudaStreamSynchronize() |
cudaEventSynchronize() |
cudaDeviceSynchronize() |
对于 CUDA 流之间的同步,即表达依赖关系,建议使用不计时的 CUDA 事件,如CUDA 事件中所述。用户可以调用cudaStreamWaitEvent(),强制以后在特定流上提交的操作等待先前记录的事件(例如,在另一个流上记录的事件)完成。注意,对于任何等待或查询事件的 CUDA API,用户都有责任确保已经调用了 cudaEventRecord API,因为未记录的事件将始终返回成功。
CUDA 事件默认带有计时信息,因为它们可以用于cudaEventElapsedTime()API 调用。然而,仅用于表达跨流依赖关系的 CUDA 事件不需要计时信息。对于此类情况,建议在创建事件时禁用计时信息,以提高性能。可以通过使用带有cudaEventDisableTiming标志的cudaEventCreateWithFlags()API 来实现这一点。
3.1.3.1. 流优先级
可以在创建流时使用cudaStreamCreateWithPriority()指定流的相对优先级。可以使用cudaDeviceGetStreamPriorityRange()函数获取允许的优先级范围,其顺序为 [最高优先级,最低优先级]。在运行时,GPU 调度器利用流优先级来确定任务执行顺序,但这些优先级只是提示,而非保证。在选择要启动的工作时,较高优先级流中等待执行的任务优先于较低优先级流中的任务。较高优先级任务不会抢占已经在运行的较低优先级任务。GPU 在任务执行期间不会重新评估工作队列,提高流的优先级也不会中断正在进行的工作。流优先级会影响任务执行,但不会强制实施严格的顺序,因此用户可以利用流优先级来影响任务执行,而不依赖严格的顺序保证。
以下代码示例获取当前设备允许的优先级范围,并创建两个非阻塞 CUDA 流,分别具有可用的最高和最低优先级。
// get the range of stream priorities for this device
int leastPriority, greatestPriority;
cudaDeviceGetStreamPriorityRange(&leastPriority, &greatestPriority);

// create streams with highest and lowest available priorities
cudaStream_t st_high, st_low;
cudaStreamCreateWithPriority(&st_high, cudaStreamNonBlocking, greatestPriority));
cudaStreamCreateWithPriority(&st_low, cudaStreamNonBlocking, leastPriority);
3.1.3.2. 显式同步
如前所述,流可以通过多种方式与其他流同步。下面给出了不同粒度下的常见方法:
cudaDeviceSynchronize()等待,直到所有主机线程的所有流中先前的命令全部完成。cudaStreamSynchronize()接受一个流作为参数,并等待,直到给定流中先前的命令全部完成。它可用于使主机与特定流同步,同时允许其他流继续在设备上执行。cudaStreamWaitEvent()接受一个流和一个事件作为参数(有关事件的说明,请参阅CUDA 事件),并使调用cudaStreamWaitEvent()之后添加到给定流中的所有命令延迟执行,直到给定事件完成。cudaStreamQuery()为应用程序提供了一种了解流中先前的命令是否已全部完成的方法。
3.1.3.3. 隐式同步
如果主机线程在来自不同流的两个命令之间发出了以下任一操作,则这两个命令无法并发运行:
分配页锁定主机内存
分配设备内存
设置设备内存
在同一设备内存的两个地址之间进行内存复制
向 NULL 流发出的任何 CUDA 命令
在 L1/共享内存配置之间切换
需要依赖检查的操作包括:与所检查的启动位于同一流中的任何其他命令,以及对该流的任何cudaStreamQuery()调用。因此,应用程序应遵循以下准则,以提高核函数并发执行的可能性:
所有独立操作都应在依赖操作之前发出,
任何类型的同步都应尽可能推迟。
3.1.4. 程序化依赖核函数启动
如前所述,CUDA 流的语义要求核函数按顺序执行。这样一来,如果有两个连续的核函数,其中第二个核函数依赖第一个核函数的结果,程序员就可以确信,当第二个核函数开始执行时,所依赖的数据已经可用。然而,可能存在这样的情况:第一个核函数已经将后续核函数所依赖的数据写入全局内存,但它仍有更多工作要做。同样,具有依赖关系的第二个核函数在需要第一个核函数的数据之前,也可能有一些独立的工作。在这种情况下,两个核函数的执行可以部分重叠(假设硬件资源可用)。这种重叠也可以使第二个核函数的启动开销重叠。除了硬件资源的可用性之外,可以达到的重叠程度还取决于核函数的具体结构,例如
第一个核函数在其执行过程中的何时完成第二个核函数所依赖的工作?
第二个核函数在其执行过程中的何时开始处理来自第一个核函数的数据?
由于这在很大程度上取决于所涉及的具体核函数,因此很难完全自动化,所以 CUDA 提供了一种机制,允许应用程序开发者指定两个核函数之间的同步点。这是通过一种称为可编程依赖核函数启动的技术实现的。下图展示了这种情况。
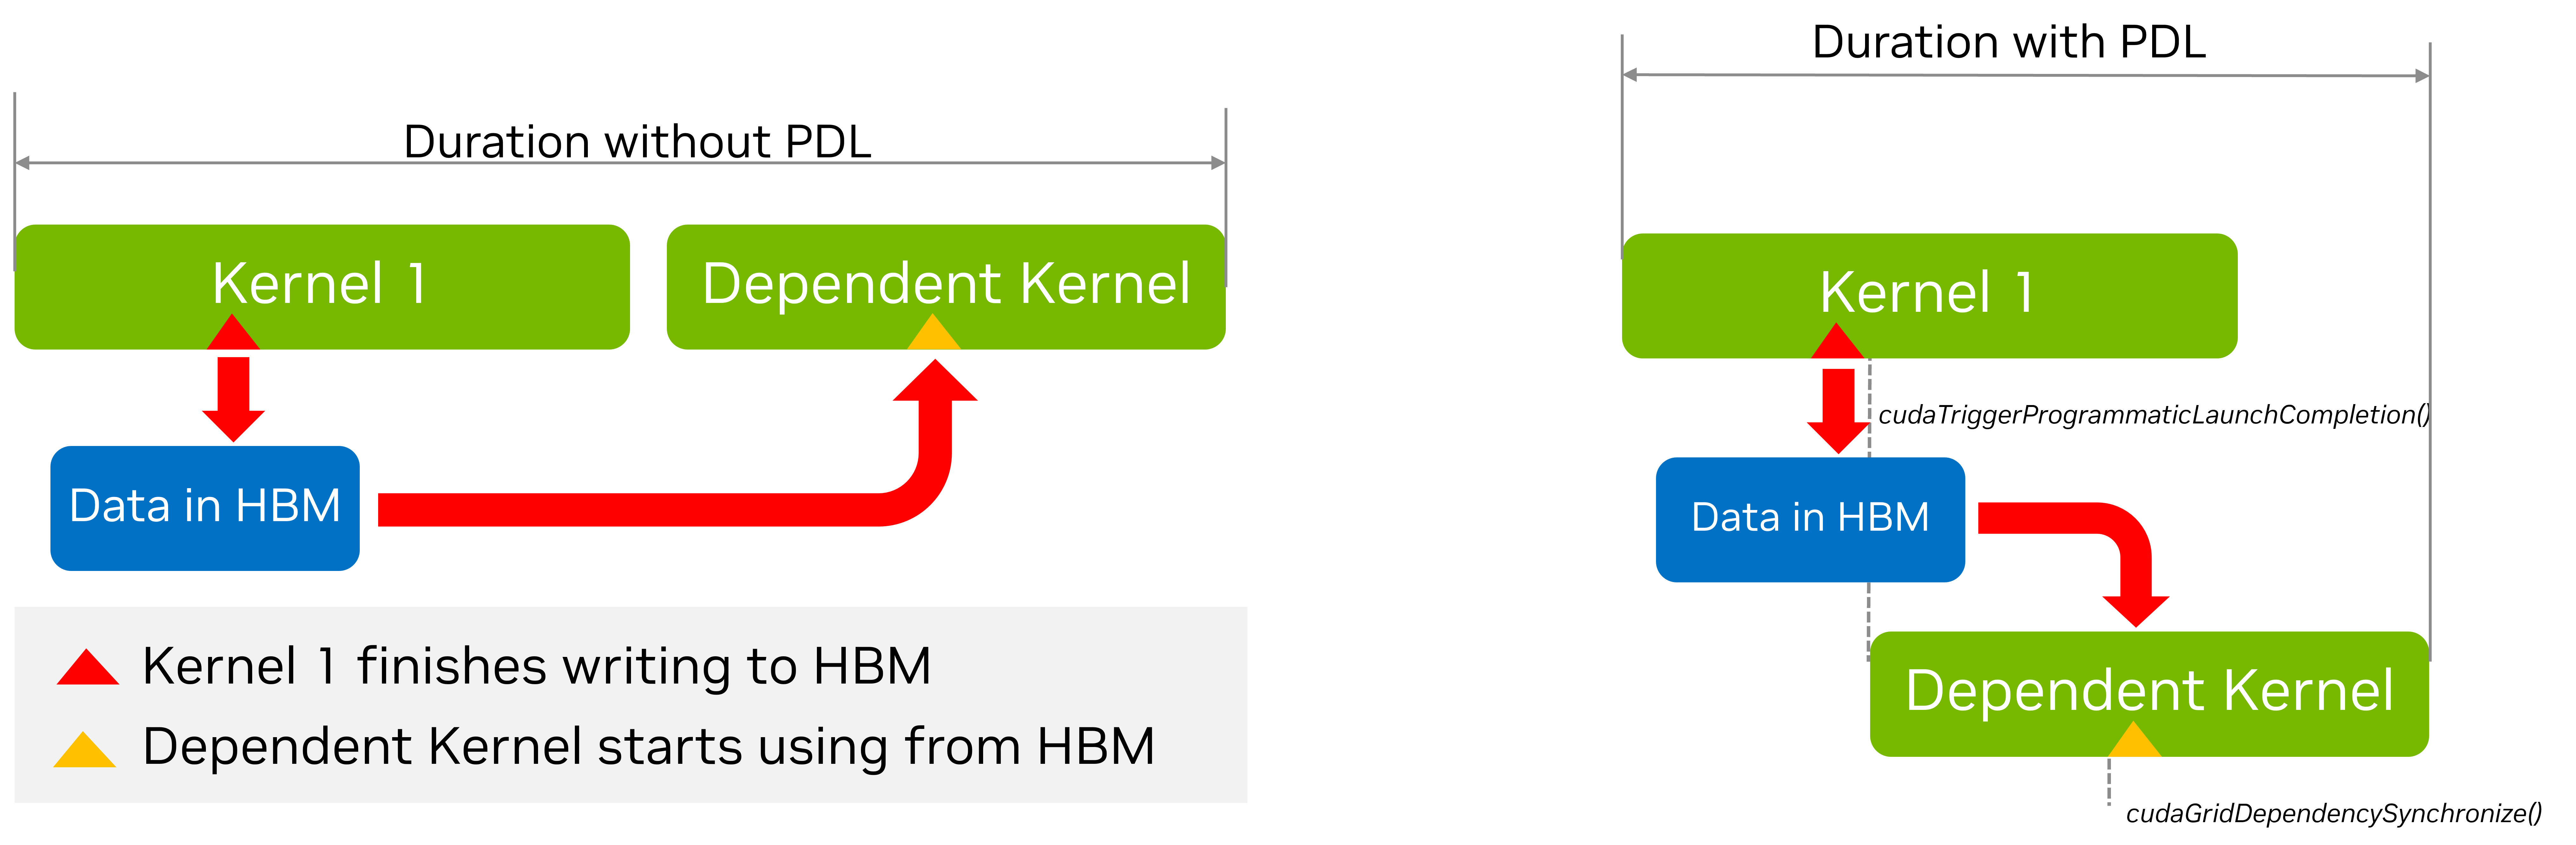
图内文字中文对照
Duration without PDL- 不使用 PDL 时的持续时间
Duration with PDL- 使用 PDL 时的持续时间
Kernel 1- 核函数 1
Dependent Kernel- 依赖核函数
Data in HBM- HBM 中的数据
Kernel 1 finishes writing to HBM- 核函数 1 完成向 HBM 写入
Dependent Kernel starts using from HBM- 依赖核函数开始使用 HBM 中的数据
PDL 有三个主要组成部分。
第一个核函数(即所谓的主核函数)需要调用一个特殊函数,以表明它已完成后续具有依赖关系的核函数(也称为次级核函数)所需的全部工作。这通过调用函数
cudaTriggerProgrammaticLaunchCompletion()来完成。相应地,具有依赖关系的次级核函数需要表明,它已执行到其工作中独立于主核函数的部分,并且现在正在等待主核函数完成它所依赖的工作。这通过函数
cudaGridDependencySynchronize()来完成。第二个核函数需要使用特殊属性cudaLaunchAttributeProgrammaticStreamSerialization启动,并将该属性的programmaticStreamSerializationAllowed字段设置为“1”。
以下代码片段展示了如何实现这一点的示例。
__global__ void primary_kernel() {
    // Initial work that should finish before starting secondary kernel

    // Trigger the secondary kernel
    cudaTriggerProgrammaticLaunchCompletion();

    // Work that can coincide with the secondary kernel
}

__global__ void secondary_kernel()
{
    // Initialization, Independent work, etc.

    // Will block until all primary kernels the secondary kernel is dependent on have
    // completed and flushed results to global memory
    cudaGridDependencySynchronize();

    // Dependent work
}

// Launch the secondary kernel with the special attribute

// Set Up the attribute
cudaLaunchAttribute attribute[1];
attribute[0].id = cudaLaunchAttributeProgrammaticStreamSerialization;
attribute[0].val.programmaticStreamSerializationAllowed = 1;

// Set the attribute in a kernel launch configuration
 cudaLaunchConfig_t config = {0};

// Base launch configuration
config.gridDim = grid_dim;
config.blockDim = block_dim;
config.dynamicSmemBytes= 0;
config.stream = stream;

// Add special attribute for PDL
config.attrs = attribute;
config.numAttrs = 1;

// Launch primary kernel
primary_kernel<<<grid_dim, block_dim, 0, stream>>>();

// Launch secondary (dependent) kernel using the configuration with
// the attribute
cudaLaunchKernelEx(&config, secondary_kernel);
3.1.5. 批量内存传输
CUDA 开发中的一种常见模式是使用批处理技术。宽泛地说,批处理是指将若干个(通常较小的)任务组合成一个(通常较大的)操作。一批任务中的各个组成部分不一定都必须相同,尽管它们通常是相同的。cuBLAS 提供的批量矩阵乘法操作就是这一思路的一个示例。
一般而言,与 CUDA Graphs 和 PDL 一样,批处理的目的是减少分别调度一批任务中的各个任务所带来的开销。对于内存传输,启动一次内存传输可能会产生一些 CPU 和驱动程序开销。此外,当前形式的常规cudaMemcpyAsync()函数不一定能为驱动程序提供足够的信息来优化传输,例如有关源和目标的提示。在 Tegra 平台上,可以选择使用 SM 或复制引擎(CE)执行传输。目前,具体选择哪一种由驱动程序中的启发式方法决定。这可能很重要,因为使用 SM 可能会使传输更快,但也会占用一部分可用的计算能力。另一方面,使用 CE 可能会使传输较慢,但应用程序的整体性能更高,因为这样可让 SM 空闲出来执行其他工作。
这些考虑促成了cudaMemcpyBatchAsync()函数(及其相关函数cudaMemcpyBatch3DAsync())的设计。这些函数允许优化批量内存传输。除了源指针和目标指针列表外,该 API 还使用内存复制属性来指定对顺序的预期,并提供源位置和目标位置的提示,以及是否倾向于使传输与计算重叠的提示(目前仅在具有 CE 的 Tegra 平台上支持这一点)。
首先考虑最简单的情况,即将数据从页锁定主机内存简单地批量传输到页锁定设备内存
std::vector<void *> srcs(batch_size);
std::vector<void *> dsts(batch_size);
std::vector<size_t> sizes(batch_size);

// Allocate the source and destination buffers
// initialize with the stream number
for (size_t i = 0; i < batch_size; i++) {
    cudaMallocHost(&srcs[i], sizes[i]);
    cudaMalloc(&dsts[i], sizes[i]);
    cudaMemsetAsync(srcs[i], sizes[i], stream);
}

// Setup attributes for this batch of copies
cudaMemcpyAttributes attrs = {};
attrs.srcAccessOrder = cudaMemcpySrcAccessOrderStream;

// All copies in the batch have same copy attributes.
size_t attrsIdxs = 0;  // Index of the attributes

// Launch the batched memory transfer
cudaMemcpyBatchAsync(&dsts[0], &srcs[0], &sizes[0], batch_size,
    &attrs, &attrsIdxs, 1 /*numAttrs*/, nullptr /*failIdx*/, stream);
cudaMemcpyBatchAsync()函数的前几个参数看起来很容易理解。它们由包含源指针和目标指针以及传输大小的数组组成。每个数组都必须有 batch_size 个元素。新的信息来自属性。该函数需要一个指向属性数组的指针,以及一个与之对应的属性索引数组。原则上,还可以传入一个size_t数组,用于记录任何失败传输的索引,不过,在此处传入nullptr也是安全的,在这种情况下,只是不记录失败的索引。
再来看属性,在此示例中,传输是同构的。因此,我们仅使用一个属性,它将应用于所有传输。这由attrIndex参数控制。原则上,它可以是一个数组。数组的第i个元素包含属性数组中第i个元素所适用的第一个传输的索引。在本例中,attrIndex被视为一个单元素数组,其值为“0”,表示attribute[0]将应用于索引为 0 及以上的所有传输,换句话说,就是所有传输。
最后,请注意,我们已将srcAccessOrder属性设置为cudaMemcpySrcAccessOrderStream。这意味着将按照常规的流顺序访问源数据。换句话说,memcpy 将阻塞,直到先前处理这些源指针和目标指针中任意指针所指向数据的核函数完成为止。
在下一个示例中,我们将考虑一种更复杂的异构批量传输情况。
std::vector<void *> srcs(batch_size);
std::vector<void *> dsts(batch_size);
std::vector<size_t> sizes(batch_size);

// Allocate the src and dst buffers
for (size_t i = 0; i < batch_size - 10; i++) {
    cudaMallocHost(&srcs[i], sizes[i]);
    cudaMalloc(&dsts[i], sizes[i]);
}

int buffer[10];

for (size_t i = batch_size - 10; i < batch_size; i++) {
    srcs[i] = &buffer[10 - (batch_size - i];
    cudaMalloc(&dsts[i], sizes[i]);
}

// Setup attributes for this batch of copies
cudaMemcpyAttributes attrs[2] = {};
attrs[0].srcAccessOrder = cudaMemcpySrcAccessOrderStream;
attrs[1].srcAccessOrder = cudaMemcpySrcAccessOrderDuringApiCall;

size_t attrsIdxs[2];
attrsIdxs[0] = 0;
attrsIdxs[1] = batch_size - 10;

// Launch the batched memory transfer
cudaMemcpyBatchAsync(&dsts[0], &srcs[0], &sizes[0], batch_size,
    &attrs, &attrsIdxs, 2 /*numAttrs*/, nullptr /*failIdx*/, stream);
这里有两种传输:从页锁定主机内存到页锁定设备内存的batch_size-10次传输,以及从主机数组到页锁定设备内存的 10 次传输。此外,buffer数组不仅位于主机上,而且仅存在于当前作用域内,其地址就是所谓的临时指针。此指针在 API 调用完成后可能不再有效(该调用是异步的)。要使用此类临时指针执行复制,必须将属性中的srcAccessOrder设置为cudaMemcpySrcAccessOrderDuringApiCall。
现在我们有两个属性,第一个属性适用于索引从 0 开始且小于batch_size-10的所有传输。第二个属性适用于索引从batch_size-10开始且小于batch_size的所有传输。
如果我们不是从栈上分配buffer数组,而是使用malloc从堆上分配它,那么数据就不再是临时的。它会一直有效,直到该指针被显式释放。在这种情况下,如何暂存复制的最佳选择将取决于系统是否具有硬件托管内存,或者 GPU 是否能通过地址转换以相干方式访问主机内存;如果具备这些条件,则最好使用流顺序,否则立即暂存传输才最为合理。在这种情况下,应将属性的srcAccessOrder设为值cudaMemcpyAccessOrderAny。
cudaMemcpyBatchAsync函数还允许程序员提供有关源位置和目标位置的提示。这通过设置cudaMemcpyAttributes结构的srcLocation和dstLocation字段来完成。这两个srcLocation``and ``dstLocation字段的类型均为cudaMemLocation,它是一个包含位置类型和位置 ID 的结构。这与使用cudaMemPrefetchAsync()时可用于向运行时提供预取提示的cudaMemLocation结构相同。下面的代码示例展示了如何为从设备到主机特定 NUMA 节点的传输设置提示:
// Allocate the source and destination buffers
std::vector<void *> srcs(batch_size);
std::vector<void *> dsts(batch_size);
std::vector<size_t> sizes(batch_size);

// cudaMemLocation structures we will use tp provide location hints
// Device device_id
cudaMemLocation srcLoc = {cudaMemLocationTypeDevice, dev_id};

// Host with numa Node numa_id
cudaMemLocation dstLoc = {cudaMemLocationTypeHostNuma, numa_id};

// Allocate the src and dst buffers
for (size_t i = 0; i < batch_size; i++) {
    cudaMallocManaged(&srcs[i], sizes[i]);
    cudaMallocManaged(&dsts[i], sizes[i]);

    cudaMemPrefetchAsync(srcs[i], sizes[i], srcLoc, 0, stream);
    cudaMemPrefetchAsync(dsts[i], sizes[i], dstLoc, 0, stream);
    cudaMemsetAsync(srcs[i], sizes[i], stream);
}

// Setup attributes for this batch of copies
cudaMemcpyAttributes attrs = {};

// These are managed memory pointers so Stream Order is appropriate
attrs.srcAccessOrder = cudaMemcpySrcAccessOrderStream;

// Now we can specify the location hints here.
attrs.srcLocHint = srcLoc;
attrs.dstlocHint = dstLoc;

// All copies in the batch have same copy attributes.
size_t attrsIdxs = 0;

// Launch the batched memory transfer
cudaMemcpyBatchAsync(&dsts[0], &srcs[0], &sizes[0], batch_size,
    &attrs, &attrsIdxs, 1 /*numAttrs*/, nullptr /*failIdx*/, stream);
最后要介绍的是用于提示我们希望使用 SM 还是 CE 进行传输的标志。用于此目的的字段是cudaMemcpyAttributesflags::flags,可能的取值如下:
cudaMemcpyFlagDefault:默认行为cudaMemcpyFlagPreferOverlapWithCompute:这提示系统应优先使用 CE 进行传输,使传输与计算重叠。
总之,关于“cudaMemcpyBatchAsync”的要点如下:
cudaMemcpyBatchAsync函数(及其 3D 变体)允许程序员指定一批内存传输,从而分摊传输设置开销。除了源指针、目标指针和传输大小之外,该函数还可以接受一个或多个内存复制属性,用于提供有关所传输内存的类型及源指针对应的流顺序行为的信息、有关源位置和目标位置的提示,以及是否优先选择让传输与计算重叠(如果可能),或者是否使用 SM 进行传输的提示。
根据上述信息,运行时可以尝试尽最大可能优化传输。
3.1.6. 环境变量
CUDA 提供了各种环境变量(参见第 5.2 节),这些变量可能会影响执行和性能。如果未显式设置它们,CUDA 会为其使用合理的默认值,但可能需要根据具体情况进行特殊处理,例如用于调试或提高性能。
例如,可能需要增大CUDA_DEVICE_MAX_CONNECTIONS环境变量的值,以降低来自不同 CUDA 流的独立工作因伪依赖而被串行化的可能性。当使用相同的底层资源时,可能会引入此类伪依赖。建议先使用默认值,仅在出现性能问题时才探索此环境变量的影响(例如,不同 CUDA 流中的独立工作出现了意外的串行化,而且无法归因于缺少可用 SM 资源等其他因素)。值得注意的是,在 MPS 情况下,此环境变量的默认值有所不同(更低)。
类似地,对于延迟敏感的应用程序,将CUDA_MODULE_LOADING环境变量设置为EAGER可能更为合适,以便将模块加载引起的所有开销移至应用程序的初始化阶段,避开其关键阶段。当前默认模式是延迟模块加载。在此默认模式下,可以在应用程序的初始化阶段添加对各个核函数的“预热”调用,强制模块加载更早发生,从而实现与立即模块加载类似的效果。
有关各种 CUDA 环境变量的更多详细信息,请参阅CUDA 环境变量。建议在启动应用程序之前将环境变量设置为新值;尝试在应用程序内部设置它们可能不会生效。