3.2. 高级核函数编程
本章将首先更深入地探讨 NVIDIA GPU 的硬件模型,然后介绍 CUDA 核函数代码中可用的一些旨在提高核函数性能的更高级功能。本章将介绍与线程作用域、异步执行以及相关同步原语有关的一些概念。这些概念性讨论为核函数代码中可用的一些高级性能功能提供了必要的基础。
本编程指南下一部分中专门介绍这些功能的章节,包含其中一些功能的详细说明。
3.2.1. 使用 PTX
并行线程执行(PTX)是 CUDA 用于抽象硬件 ISA 的虚拟机指令集架构(ISA),已在第 1.3.3 节中介绍。直接使用 PTX 编写代码是一项非常高级的优化技术,对大多数开发者而言并无必要,应将其视为最后才使用的手段。尽管如此,在某些情况下,直接编写 PTX 所提供的细粒度控制能够提高特定应用程序的性能。这些情况通常出现在应用程序中对性能非常敏感的部分,在这些部分中,任何不足百分之一的性能提升都会带来显著收益。所有可用的 PTX 指令均列于PTX ISA 文档中。
cuda::ptx命名空间
在代码中直接使用 PTX 的一种方法是使用libcu++中的cuda::ptx命名空间。该命名空间提供了直接映射到 PTX 指令的 C++ 函数,从而简化了在 C++ 应用程序中使用这些指令的方式。有关更多信息,请参阅cuda::ptx 命名空间文档。
内联 PTX
在代码中包含 PTX 的另一种方法是使用内联 PTX。相应的文档中详细描述了此方法。这与在 CPU 上编写汇编代码非常相似。
3.2.2. 硬件实现
流式多处理器(SM,参见GPU 硬件模型)旨在并发执行数百个线程。为了管理如此大量的线程,它采用了一种独特的并行计算模型,称为单指令、多线程,或SIMT,该模型在SIMT 执行模型中进行了说明。指令采用流水线执行,既利用单个线程内的指令级并行性,也通过同时硬件多线程利用广泛的线程级并行性,详见硬件多线程。与 CPU 核心不同,SM 按顺序发出指令,不执行分支预测或推测执行。
SIMT 执行模型和硬件多线程两节描述了所有设备共有的 SM 架构特性。计算能力一节提供了不同计算能力设备的具体信息。
NVIDIA GPU 架构使用小端表示法。
3.2.2.1. SIMT 执行模型
每个 SM 都以一组 32 个并行线程为单位创建、管理、调度和执行线程,这样的一组线程称为线程束。组成一个线程束的各个线程从相同的程序地址一起开始执行,但它们具有各自的指令地址计数器和寄存器状态,因此可以自由地独立分支和执行。线程束一词源于编织,这是最早的并行线技术。半线程束是一个线程束的前半部分或后半部分。四分之一线程束是一个线程束的第一个、第二个、第三个或第四个四分之一部分。
线程束一次执行一条共同的指令,因此,当线程束中的全部 32 个线程遵循相同的执行路径时,就能实现完全的执行效率。如果线程束中的线程通过依赖数据的条件分支发生分歧,线程束就会执行所采取的每条分支路径,并禁用不在该路径上的线程。分支分歧仅发生在线程束内部;不同线程束独立执行,无论它们执行的是相同的代码路径还是互不相交的代码路径。
SIMT 架构与 SIMD(单指令、多数据)向量组织方式相似,都是由一条指令控制多个处理单元。一个关键区别在于,SIMD 向量组织方式向软件暴露 SIMD 宽度,而 SIMT 指令则指定单个线程的执行和分支行为。与 SIMD 向量机不同,SIMT 既使程序员能够为独立的标量线程编写线程级并行代码,也能够为相互协调的线程编写数据并行代码。就正确性而言,程序员基本上可以忽略 SIMT 行为;但是,注意使代码很少要求线程束中的线程发生分歧,可以显著提高性能。在实践中,这类似于缓存行的作用:以正确性为目标进行设计时,可以放心地忽略缓存行大小,但以峰值性能为目标进行设计时,则必须在代码结构中考虑缓存行大小。另一方面,向量架构要求软件将加载合并为向量,并手动管理分歧。
3.2.2.1.1. 独立线程调度
在计算能力低于 7.0 的 GPU 上,线程束使用一个由线程束中全部 32 个线程共享的程序计数器,以及一个用于指定线程束中活跃线程的活跃掩码。因此,同一线程束中处于分歧区域或不同执行状态的线程无法相互发送信号或交换数据,而需要对由锁或互斥量保护的数据进行细粒度共享的算法可能导致死锁,具体取决于发生竞争的线程来自哪个线程束。
在计算能力为 7.0 及更高的 GPU 中,独立线程调度允许线程之间实现完全并发,而不受线程束的限制。使用独立线程调度时,GPU 为每个线程维护执行状态,包括程序计数器和调用栈,并且可以按单个线程的粒度让出执行权,以便更好地利用执行资源,或者允许一个线程等待另一个线程生成数据。调度优化器决定如何将同一线程束中的活跃线程组合为 SIMT 单元。这保留了此前 NVIDIA GPU 中 SIMT 执行的高吞吐量,但具有大得多的灵活性:线程现在可以在线程束以下的粒度上发生分歧和重新汇合。
独立线程调度可能破坏依赖以往 GPU 架构中隐式线程束同步行为的代码。线程束同步代码假定同一线程束中的线程在每条指令上都锁步执行,但线程能够在线程束以下的粒度上发生分歧和重新汇合,使得这些假定不再成立。这可能导致参与代码执行的线程集合与预期不同。应重新检查为计算能力 7.0 之前的 GPU 开发的所有线程束同步代码(例如无需同步的线程束内归约),以确保兼容性。开发者应使用__syncwarp()对此类代码进行显式同步,以确保它在所有代际的 GPU 上都能正确运行。
注意
线程束中参与当前指令的线程称为活跃线程,而不处于当前指令上的线程则是非活跃的(已禁用)。线程可能由于多种原因而处于非活跃状态,包括比其所在线程束中的其他线程更早退出,采取了不同于线程束当前所执行分支路径的分支路径,或者是线程数并非线程束大小整数倍的线程块中的最后几个线程。
如果线程束执行的一条非原子指令使该线程束中的多个线程写入全局内存或共享内存中的同一位置,那么对该位置发生的串行化写入次数可能因设备的计算能力而异。但是,对于所有计算能力,由哪个线程执行最后一次写入都是未定义的。
如果线程束执行的一条原子指令使该线程束中的多个线程读取、修改并写入全局内存中的同一位置,那么对该位置的每次读取/修改/写入都会发生,并且它们全部串行化,但发生的顺序是未定义的。
3.2.2.2. 硬件多线程
当一个 SM 被分配一个或多个线程块来执行时,它会将这些线程块划分为线程束,每个线程束由一个线程束调度器调度执行。线程块划分为线程束的方式始终相同;每个线程束包含线程 ID 连续递增的线程,第一个线程束包含线程 0。线程层次结构介绍了线程 ID 与线程块内线程索引之间的关系。
线程块中的线程束总数定义如下:
T是每个线程块中的线程数,
Wsize是线程束大小,等于 32,
ceil(x, y) 等于将 x 向上舍入到最近的 y 的整数倍。
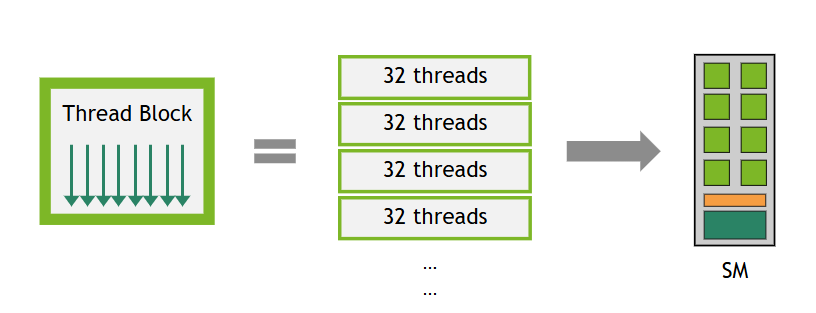
图 22一个线程块被划分为多个各含 32 个线程的线程束。
图内文字中文对照
Thread Block- 线程块
32 threads- 32 个线程
SM- 流式多处理器
SM 所处理的每个线程束的执行上下文(程序计数器、寄存器等)在该线程束的整个生命周期内都保留在芯片上。因此,在线程束之间切换不会产生任何开销。在每个指令发射周期,线程束调度器选择一个线程束,该线程束中有线程已准备好执行下一条指令(即线程束中的活跃线程),并向这些线程发射该指令。
每个 SM 都有一组在线程束之间分配的 32 位寄存器,以及一块在线程块之间分配的共享内存。对于给定的核函数,能够驻留在 SM 上并被并发处理的线程块数和线程束数,取决于核函数使用的寄存器和共享内存的数量,以及 SM 上可用的寄存器和共享内存的数量。每个 SM 上的驻留线程块数和线程束数也有最大值。这些限制以及 SM 上可用的寄存器和共享内存数量都取决于设备的计算能力,具体规定见计算能力。如果每个 SM 上没有足够的可用资源来处理至少一个线程块,核函数将无法启动。可以通过占用率一节中介绍的几种方式来确定为一个线程块分配的寄存器总数和共享内存总量。
3.2.2.3. 异步执行特性
近几代 NVIDIA GPU 都包含了异步执行能力,以便在 GPU 内部实现更多的数据移动、计算和同步重叠。这些能力使从 GPU 代码中调用的某些操作能够相对于同一线程块中的其他 GPU 代码异步执行。不应将这种异步执行与第 2.5 节中讨论的异步 CUDA API 混淆,后者使 GPU 核函数启动或内存操作能够相对于彼此或相对于 CPU 异步进行。
计算能力 8.0(NVIDIA Ampere GPU 架构)引入了由硬件加速的从全局内存到共享内存的异步数据复制,以及异步屏障(参见NVIDIA A100 张量核心 GPU 架构)。
计算能力 9.0(NVIDIA Hopper GPU 架构)通过张量内存加速器(TMA)单元、异步事务屏障和异步矩阵乘加操作扩展了异步执行特性,其中 TMA 单元可以将大块数据和多维张量从全局内存传输到共享内存,也可以反向传输(详情请参见深入剖析 Hopper 架构博文。)。
CUDA 提供了可由线程从设备代码中调用的 API,以使用这些特性。异步编程模型定义了异步操作相对于 CUDA 线程的行为。
异步操作是由一个 CUDA 线程发起、但以异步方式执行的操作,就像由另一个线程执行一样,我们将这个线程称为异步线程。在格式良好的程序中,一个或多个 CUDA 线程会与异步操作同步。发起异步操作的 CUDA 线程不必属于参与同步的线程。异步线程始终与发起该操作的 CUDA 线程相关联。
异步操作使用同步对象来发出其完成的信号,该对象可以是屏障,也可以是流水线。高级同步原语详细介绍了这些同步对象,异步数据复制则展示了它们在执行异步内存操作中的作用。
3.2.2.3.1. 异步线程与异步代理
异步操作访问内存的方式可能与常规操作不同。为了区分这些不同的内存访问方式,CUDA 引入了异步线程、通用代理和异步代理的概念。普通操作(加载和存储)通过通用代理进行。一些异步指令,例如LDGSTS和STAS/REDAS,使用在通用代理中运行的异步线程来建模。其他异步指令,例如使用 TMA 的批量异步复制以及某些张量核心操作(tcgen05.*、wgmma.mma_async.*),则使用在异步代理中运行的异步线程来建模。
在通用代理中运行的异步线程。发起异步操作时,该操作会与一个异步线程关联,该线程不同于发起操作的 CUDA 线程。保证对同一地址的先前通用代理(普通)加载和存储在顺序上位于该异步操作之前。但是,不保证对同一地址的后续普通加载和存储保持其顺序,因此在异步线程完成之前,可能产生竞争条件。
在异步代理中运行的异步线程。发起异步操作时,该操作会与一个异步线程关联,该线程不同于发起操作的 CUDA 线程。不保证对同一地址的先前和后续普通加载和存储保持其顺序。需要使用代理栅栏在不同代理之间同步这些操作,以确保正确的内存顺序。使用张量内存加速器(TMA)一节展示了如何使用代理栅栏,确保使用 TMA 执行异步复制时的正确性。
有关这些概念的更多详细信息,请参阅PTX ISA文档。
3.2.3. 线程作用域
CUDA 线程构成了一个线程层次结构,利用这一层次结构对于编写既正确又高性能的 CUDA 核函数至关重要。在这一层次结构中,内存操作的可见性和同步作用域可能各不相同。为处理这种非均一性,CUDA 编程模型引入了线程作用域的概念。线程作用域定义了哪些线程能够观察到某个线程的加载和存储,并规定了哪些线程能够使用原子操作和屏障等同步原语相互同步。每个作用域在内存层次结构中都有一个关联的相干点。
线程作用域在CUDA PTX中公开,也以扩展的形式在libcu++库中提供。下表定义了可用的线程作用域:
CUDA C++ 线程作用域 |
CUDA PTX 线程作用域 |
描述 |
内存层次结构中的相干点 |
|---|---|---|---|
|
内存操作仅对本线程可见。 |
|
|
|
|
内存操作对同一线程块中的其他线程可见。 |
L1 |
|
内存操作对同一线程块簇中的其他线程可见。 |
L2 |
|
|
|
内存操作对同一 GPU 设备中的其他线程可见。 |
L2 |
|
|
内存操作对同一系统中的其他线程(CPU、其他 GPU)可见。 |
L2 + 相连接的缓存 |
3.2.4. 高级同步原语
本节介绍三类同步原语:
限定作用域的原子操作,它将 C++ 内存顺序与 CUDA 线程作用域相结合,以在线程块、簇、设备或系统作用域内在线程之间安全地通信(参见线程作用域)。
异步屏障,它将同步分为到达和等待阶段,并且可用于跟踪异步操作的进度。
3.2.4.1. 限定作用域的原子操作
第 5.4.5 节概述了 CUDA 中可用的原子函数。在本节中,我们将重点介绍支持C++ 标准原子内存语义的限定作用域的原子操作,这些操作可通过libcu++库或编译器内建函数使用。限定作用域的原子操作提供了在 CUDA 线程层次结构的适当层级实现高效同步的工具,从而兼顾复杂并行算法的正确性和性能。
3.2.4.1.1. 线程作用域与内存顺序
限定作用域的原子操作结合了两个关键概念:
线程作用域:定义哪些线程能够观察到原子操作的效果(参见线程作用域)。
内存顺序:定义相对于其他内存操作的顺序约束(参见C++ 标准原子内存语义)。
#include <cuda/atomic>

__global__ void block_scoped_counter() {
    // Shared atomic counter visible only within this block
    __shared__ cuda::atomic<int, cuda::thread_scope_block> counter;

    // Initialize counter (only one thread should do this)
    if (threadIdx.x == 0) {
        counter.store(0, cuda::memory_order_relaxed);
    }
    __syncthreads();

    // All threads in block atomically increment
    int old_value = counter.fetch_add(1, cuda::memory_order_relaxed);

    // Use old_value...
}
__global__ void block_scoped_counter() {
    // Shared counter visible only within this block
    __shared__ int counter;

    // Initialize counter (only one thread should do this)
    if (threadIdx.x == 0) {
        __nv_atomic_store_n(&counter, 0,
                            __NV_ATOMIC_RELAXED,
                            __NV_THREAD_SCOPE_BLOCK);
    }
    __syncthreads();

    // All threads in block atomically increment
    int old_value = __nv_atomic_fetch_add(&counter, 1,
                                          __NV_ATOMIC_RELAXED,
                                          __NV_THREAD_SCOPE_BLOCK);

    // Use old_value...
}
此示例实现了一个线程块作用域的原子计数器,用于演示限定作用域的原子操作的基本概念:
共享变量:使用
__shared__内存,在线程块的所有线程之间共享单个计数器。原子类型声明:
cuda::atomic<int, cuda::thread_scope_block>创建一个具有线程块级可见性的原子整数。单次初始化:只有线程 0 初始化计数器,以防止在设置期间发生竞争条件。
线程块同步:
__syncthreads()确保所有线程在继续执行之前都能看到已初始化的计数器。原子递增:每个线程都以原子方式递增计数器,并获得其先前的值。
这里选择cuda::memory_order_relaxed,因为我们只需要原子性(不可分割的读-改-写),而不需要对不同内存位置之间的操作施加顺序约束。由于这是一个简单的计数操作,递增操作的顺序不会影响正确性。
对于生产者-消费者模式,获取-释放语义可确保正确的顺序:
__global__ void producer_consumer() {
    __shared__ int data;
    __shared__ cuda::atomic<bool, cuda::thread_scope_block> ready;

    if (threadIdx.x == 0) {
        // Producer: write data then signal ready
        data = 42;
        ready.store(true, cuda::memory_order_release);  // Release ensures data write is visible
    } else {
        // Consumer: wait for ready signal then read data
        while (!ready.load(cuda::memory_order_acquire)) {  // Acquire ensures data read sees the write
            // spin wait
        }
        int value = data;
        // Process value...
    }
}
__global__ void producer_consumer() {
    __shared__ int data;
    __shared__ bool ready; // Only ready flag needs atomic operations

    if (threadIdx.x == 0) {
        // Producer: write data then signal ready
        data = 42;
        __nv_atomic_store_n(&ready, true,
                            __NV_ATOMIC_RELEASE,
                            __NV_THREAD_SCOPE_BLOCK);  // Release ensures data write is visible
    } else {
        // Consumer: wait for ready signal then read data
        while (!__nv_atomic_load_n(&ready,
                                   __NV_ATOMIC_ACQUIRE,
                                   __NV_THREAD_SCOPE_BLOCK)) {  // Acquire ensures data read sees the write
            // spin wait
        }
        int value = data;
        // Process value...
    }
}
3.2.4.1.2. 性能注意事项
尽可能使用最小的作用域:线程块作用域的原子操作比系统作用域的原子操作快得多。
优先使用较弱的顺序约束:只有在确保正确性所必需时,才使用更强的顺序约束。
考虑内存位置:共享内存原子操作比全局内存原子操作更快。
3.2.4.2. 异步屏障
异步屏障与典型的单阶段屏障(__syncthreads())的区别在于,线程发出其已到达屏障的通知(“到达”)与等待其他线程到达屏障的操作(“等待”)是分离的。这种分离允许线程执行与屏障无关的其他操作,从而更有效地利用等待时间,提高执行效率。异步屏障可用于通过 CUDA 线程实现生产者-消费者模式,也可以让复制操作在完成时向屏障发出信号(“到达”屏障),从而支持内存层次结构中的异步数据复制。
计算能力为 7.0 或更高的设备支持异步屏障。计算能力为 8.0 或更高的设备为共享内存中的异步屏障提供硬件加速,并且允许对线程块内 CUDA 线程的任意子集进行硬件加速同步,从而显著提升了同步粒度。此前的架构只能在整个线程束(__syncwarp())或整个线程块(__syncthreads())级别加速同步。
CUDA 编程模型通过cuda::std::barrier提供异步屏障,它是libcu++库中提供的、符合 ISO C++ 标准的屏障。除了实现std::barrier之外,该库还提供了 CUDA 专用扩展,可选择屏障的线程作用域以提升性能,并公开了更底层的cuda::ptx API。cuda::barrier可以通过使用friend函数cuda::device::barrier_native_handle()获取屏障的原生句柄并将其传递给cuda::ptx函数,来与cuda::ptx互操作。CUDA 还为线程块作用域下共享内存中的异步屏障提供了原语 API。
下表概述了可用于在不同线程作用域下进行同步的异步屏障。
线程作用域
内存位置
到达屏障
在屏障处等待
硬件加速
CUDA API
线程块
本地共享内存
允许
允许
是(8.0+)
cuda::barrier、cuda::ptx、原语簇
本地共享内存
允许
允许
是(9.0+)
cuda::barrier,cuda::ptx簇
远程共享内存
允许
不允许
是(9.0+)
cuda::barrier,cuda::ptx设备
全局内存
允许
允许
否
cuda::barrier系统
全局内存/统一内存
允许
允许
否
cuda::barrier
同步在时间上的拆分
如果不使用异步到达-等待屏障,线程块内的同步可通过__syncthreads()实现,或者在使用协作组时通过block.sync()实现。
#include <cooperative_groups.h>

__global__ void simple_sync(int iteration_count) {
    auto block = cooperative_groups::this_thread_block();

    for (int i = 0; i < iteration_count; ++i) {
        /* code before arrive */

         // Wait for all threads to arrive here.
        block.sync();

        /* code after wait */
    }
}
线程会在同步点(block.sync())处阻塞,直到所有线程都到达该同步点。此外,同步点之前发生的内存更新保证在同步点之后对线程块中的所有线程可见。
此模式有三个阶段:
同步之前的代码执行内存更新,这些更新将在同步之后被读取。
同步点。
同步之后的代码能够看到同步之前发生的内存更新。
如果改用异步屏障,在时间上拆分的同步模式如下所示。
#include <cuda/barrier>
#include <cooperative_groups.h>

__device__ void compute(float *data, int iteration);

__global__ void split_arrive_wait(int iteration_count, float *data)
{
  using barrier_t = cuda::barrier<cuda::thread_scope_block>;
  __shared__ barrier_t bar;
  auto block = cooperative_groups::this_thread_block();

  if (block.thread_rank() == 0)
  {
    // Initialize barrier with expected arrival count.
    init(&bar, block.size());
  }
  block.sync();

  for (int i = 0; i < iteration_count; ++i)
  {
    /* code before arrive */

    // This thread arrives. Arrival does not block a thread.
    barrier_t::arrival_token token = bar.arrive();

    compute(data, i);

    // Wait for all threads participating in the barrier to complete bar.arrive().
    bar.wait(std::move(token));

    /* code after wait */
  }
}
|
#include <cuda/ptx>
#include <cooperative_groups.h>

__device__ void compute(float *data, int iteration);

__global__ void split_arrive_wait(int iteration_count, float *data)
{
  __shared__ uint64_t bar;
  auto block = cooperative_groups::this_thread_block();

  if (block.thread_rank() == 0)
  {
    // Initialize barrier with expected arrival count.
    cuda::ptx::mbarrier_init(&bar, block.size());
  }
  block.sync();

  for (int i = 0; i < iteration_count; ++i)
  {
    /* code before arrive */

    // This thread arrives. Arrival does not block a thread.
    uint64_t token = cuda::ptx::mbarrier_arrive(&bar);

    compute(data, i);

    // Wait for all threads participating in the barrier to complete mbarrier_arrive().
    while(!cuda::ptx::mbarrier_try_wait(&bar, token)) {}

    /* code after wait */
  }
}
|
#include <cuda_awbarrier_primitives.h>
#include <cooperative_groups.h>

__device__ void compute(float *data, int iteration);

__global__ void split_arrive_wait(int iteration_count, float *data)
{
  __shared__ __mbarrier_t bar;
  auto block = cooperative_groups::this_thread_block();

  if (block.thread_rank() == 0)
  {
    // Initialize barrier with expected arrival count.
    __mbarrier_init(&bar, block.size());
  }
  block.sync();

  for (int i = 0; i < iteration_count; ++i)
  {
    /* code before arrive */

    // This thread arrives. Arrival does not block a thread.
    __mbarrier_token_t token = __mbarrier_arrive(&bar);

    compute(data, i);

    // Wait for all threads participating in the barrier to complete __mbarrier_arrive().
    while(!__mbarrier_try_wait(&bar, token, 1000)) {}

    /* code after wait */
  }
}
|
在此模式中,同步点被拆分为到达点(bar.arrive())和等待点(bar.wait(std::move(token)))。线程在首次调用bar.arrive()时开始参与cuda::barrier。当线程调用bar.wait(std::move(token))时,它将被阻塞,直到参与线程完成了预期次数的bar.arrive(),该次数就是传递给init()的预期到达次数参数。参与线程调用bar.arrive()之前发生的内存更新,保证在这些线程调用bar.wait(std::move(token))之后对它们可见。请注意,调用bar.arrive()不会阻塞线程,线程可以继续执行其他工作,只要这些工作不依赖于其他参与线程调用bar.arrive()之前发生的内存更新即可。
到达和等待模式有五个阶段:
到达之前的代码执行内存更新,这些更新将在等待之后被读取。
具有隐式内存栅栏的到达点(即等效于
cuda::atomic_thread_fence(cuda::memory_order_seq_cst, cuda::thread_scope_block))。到达与等待之间的代码。
等待点。
等待之后的代码能够看到到达之前执行的更新。
有关如何使用异步屏障的完整指南,请参阅异步屏障。
3.2.4.3. 流水线
CUDA 编程模型提供了流水线同步对象,作为一种协调机制,将异步内存复制按顺序组织成多个阶段,从而便于实现双缓冲或多缓冲的生产者-消费者模式。流水线是一个具有头端和尾端的双端队列,按先进先出(FIFO)的顺序处理工作。生产者线程将工作提交到流水线的头端,而消费者线程从流水线的尾端提取工作。
流水线通过libcu++库中的cuda::pipeline API 以及原语 API提供。下表描述了这两种 API 的主要功能。
|
描述 |
|---|---|
|
获取流水线内部队列中的一个可用阶段。 |
|
提交在 |
|
等待流水线中最早阶段的异步操作完成。 |
|
将流水线中最早的阶段释放回流水线对象以便重用。随后,生产者可以获取已释放的阶段。 |
原语 API |
描述 |
|---|---|
|
请求提交一次从全局内存到共享内存的内存复制,以便异步执行。 |
|
提交在此调用之前、针对流水线当前阶段发出的异步操作。 |
|
等待除最后 N 次向流水线提交的操作之外的所有异步操作完成。 |
cuda::pipeline API 的接口更丰富,限制更少,而原语 API 仅支持跟踪从全局内存到共享内存的异步复制,并且有特定的大小和对齐要求。原语 API 提供的功能等效于使用cuda::thread_scope_thread的cuda::pipeline对象。
有关详细的使用模式和示例,请参阅流水线。
3.2.5. 异步数据复制
在内存层次结构内高效移动数据,是在 GPU 计算中实现高性能的基础。传统的同步内存操作会迫使线程在数据传输期间空闲等待。GPU 本身会通过并行性隐藏内存延迟。也就是说,在内存操作完成的过程中,SM 会切换去执行另一个线程束。即使通过并行性隐藏了延迟,内存延迟仍然可能成为内存带宽利用率和计算资源效率的瓶颈。为解决这些瓶颈,现代 GPU 架构提供了硬件加速的异步数据复制机制,允许内存传输独立进行,同时线程继续执行其他工作。
异步数据复制通过将内存传输的发起与等待其完成分离开来,使计算与数据移动能够重叠进行。这样,线程就可以在内存延迟期间执行有用的工作,从而提高总体吞吐量和资源利用率。
注意
虽然本节所依据的概念和原理与前面异步执行一章讨论的内容相似,但该章介绍的是核函数和内存传输的异步执行,例如由cudaMemcpyAsync调用的操作。这可以看作应用程序不同组成部分之间的异步性。
本节介绍的异步性,是指在不阻塞 GPU 线程的情况下,支持在 GPU 的 DRAM(即全局内存)与 SM 上的内存(例如共享内存或张量内存)之间传输数据。这是单次核函数启动的执行过程内部的异步性。
要理解异步复制如何提升性能,考察一种常见的 GPU 计算模式会有所帮助。CUDA 应用程序经常采用复制和计算模式,该模式:
从全局内存获取数据,
将数据存储到共享内存,然后
对共享内存中的数据执行计算,并可能将结果写回全局内存。
此模式的复制阶段通常表示为shared[local_idx] = global[global_idx]。编译器会将这种从全局内存到共享内存的复制展开为先从全局内存读取到寄存器,再从寄存器写入共享内存。
当此模式出现在迭代算法中时,每个线程块都需要在shared[local_idx] = global[global_idx]赋值之后进行同步,以确保在计算阶段开始之前,对共享内存的所有写入都已完成。线程块还需要在计算阶段之后再次同步,以防止在所有线程完成计算之前覆盖共享内存。以下代码片段展示了此模式。
#include <cooperative_groups.h>

__device__ void compute(int* global_out, int const* shared_in) {
    // Computes using all values of current batch from shared memory.
    // Stores this thread's result back to global memory.
}

__global__ void without_async_copy(int* global_out, int const* global_in, size_t size, size_t batch_sz) {
  auto grid = cooperative_groups::this_grid();
  auto block = cooperative_groups::this_thread_block();
  assert(size == batch_sz * grid.size()); // Exposition: input size fits batch_sz * grid_size

  extern __shared__ int shared[]; // block.size() * sizeof(int) bytes

  size_t local_idx = block.thread_rank();

  for (size_t batch = 0; batch < batch_sz; ++batch) {
    // Compute the index of the current batch for this block in global memory.
    size_t block_batch_idx = block.group_index().x * block.size() + grid.size() * batch;
    size_t global_idx = block_batch_idx + threadIdx.x;
    shared[local_idx] = global_in[global_idx];

    // Wait for all copies to complete.
    block.sync();

    // Compute and write result to global memory.
    compute(global_out + block_batch_idx, shared);

    // Wait for compute using shared memory to finish.
    block.sync();
  }
}
使用异步数据复制,可以异步地将数据从全局内存移动到共享内存,从而在等待数据到达时更高效地利用 SM。
#include <cooperative_groups.h>
#include <cooperative_groups/memcpy_async.h>

__device__ void compute(int* global_out, int const* shared_in) {
    // Computes using all values of current batch from shared memory.
    // Stores this thread's result back to global memory.
}

__global__ void with_async_copy(int* global_out, int const* global_in, size_t size, size_t batch_sz) {
  auto grid = cooperative_groups::this_grid();
  auto block = cooperative_groups::this_thread_block();
  assert(size == batch_sz * grid.size()); // Exposition: input size fits batch_sz * grid_size

  extern __shared__ int shared[]; // block.size() * sizeof(int) bytes

  size_t local_idx = block.thread_rank();

  for (size_t batch = 0; batch < batch_sz; ++batch) {
    // Compute the index of the current batch for this block in global memory.
    size_t block_batch_idx = block.group_index().x * block.size() + grid.size() * batch;

    // Whole thread-group cooperatively copies whole batch to shared memory.
    cooperative_groups::memcpy_async(block, shared, global_in + block_batch_idx, block.size());

    // Compute on different data while waiting.

    // Wait for all copies to complete.
    cooperative_groups::wait(block);

    // Compute and write result to global memory.
    compute(global_out + block_batch_idx, shared);

    // Wait for compute using shared memory to finish.
    block.sync();
  }
}
cooperative_groups::memcpy_async函数将block.size()个元素从全局内存复制到shared数据中。此操作如同由另一个线程执行,该线程在复制完成后,与当前线程对cooperative_groups::wait的调用同步。在复制操作完成之前,修改全局数据或者读取或写入共享数据都会引发数据竞争。
此示例展示了所有异步复制操作背后的基本概念:它们将内存传输的发起与完成分离开来,允许线程在数据于后台移动的同时执行其他工作。CUDA 编程模型提供了多种 API 来使用这些功能,包括协作组和libcu++库中提供的memcpy_async函数,以及更底层的cuda::ptx和原语 API。这些 API 具有相似的语义:它们将对象从源位置复制到目标位置,如同由另一个线程执行一样,并且在复制完成后,可以通过不同的完成机制与该线程同步。
现代 GPU 架构为异步数据移动提供了多种硬件机制。
LDGSTS(计算能力 8.0+)支持从全局内存到共享内存的高效小规模异步传输。
张量内存加速器(TMA,计算能力 9.0+)扩展了这些功能,提供了针对大规模多维数据传输优化的批量异步复制操作
STAS 指令(计算能力 9.0+)支持从寄存器到簇内分布式共享内存的小规模异步传输。
这些机制支持不同的数据路径、传输大小和对齐要求,使开发者能够针对特定的数据访问模式选择最合适的方法。下表概述了 GPU 内部异步复制所支持的数据路径。
方向 |
复制机制 |
||
|---|---|---|---|
源 |
目标 |
异步复制 |
批量异步复制 |
全局内存 |
全局内存 |
||
shared::cta |
全局内存 |
支持(TMA,9.0+) |
|
全局内存 |
shared::cta |
支持(LDGSTS,8.0+) |
支持(TMA,9.0+) |
全局内存 |
shared::cluster |
支持(TMA,9.0+) |
|
shared::cluster |
shared::cta |
支持(TMA,9.0+) |
|
shared::cta |
shared::cta |
||
寄存器 |
shared::cluster |
支持(STAS,9.0+) |
|
使用 LDGSTS、使用张量内存加速器(TMA)和使用 STAS各节将更详细地介绍每种机制。