4.6. 绿色上下文
绿色上下文(GC)是一种轻量级上下文,从创建时起就与一组特定的 GPU 资源相关联。用户可以在创建绿色上下文时划分 GPU 资源,目前包括流式多处理器(SM)和工作队列(WQ),这样,以某个绿色上下文为目标的 GPU 工作就只能使用为其分配的 SM 和工作队列。这样做有助于减少或更好地控制因使用共同资源而造成的干扰。一个应用程序可以有多个绿色上下文。
使用绿色上下文无需更改任何 GPU 代码(核函数),只需在主机端进行少量更改(例如,创建绿色上下文并为此绿色上下文创建流)。绿色上下文功能在多种场景中都很有用。例如,在没有其他约束的前提下,它可以帮助确保始终有一些 SM 可供延迟敏感的核函数开始执行,或者提供一种无需修改任何核函数即可快速测试使用较少 SM 的效果的方法。
绿色上下文支持最初通过CUDA 驱动程序 API提供。从 CUDA 13.1 开始,CUDA 运行时通过执行上下文(EC)抽象来暴露上下文。目前,执行上下文可以对应于主上下文(运行时 API 用户一直隐式与之交互的上下文),也可以对应于绿色上下文。本节在指代绿色上下文时,将交替使用执行上下文和绿色上下文这两个术语。
随着绿色上下文在运行时中暴露,强烈建议直接使用 CUDA 运行时 API。本节也将仅使用 CUDA 运行时 API。
本节余下内容的组织如下:第 4.6.1 节提供一个说明使用动机的示例,第 4.6.2 节重点说明易用性,第 4.6.3 节介绍设备资源和资源描述符结构体。第 4.6.4 节说明如何创建绿色上下文,第 4.6.5 节说明如何启动以它为目标的工作,第 4.6.6 节重点介绍一些其他绿色上下文 API。最后,第 4.6.7 节以一个示例收尾。
4.6.1. 动机 / 何时使用
启动 CUDA 核函数时,用户无法直接控制该核函数将在多少个 SM 上执行。只能通过更改核函数的启动几何配置,或更改任何可能影响该核函数在每个 SM 上的最大活跃线程块数的因素,来间接影响这一点。此外,当多个核函数在 GPU 上并行执行时(核函数在不同的 CUDA 流中运行,或作为 CUDA 图的一部分运行),它们也可能争用相同的 SM 资源。
然而,在某些使用场景中,用户需要确保始终有可用的 GPU 资源,使延迟敏感的工作能够尽快开始,并由此尽快完成。绿色上下文通过对 SM 资源进行分区,提供了一种实现这一目标的方法,因此,给定的绿色上下文只能使用特定的 SM(即在创建该上下文时为其配置的那些 SM)。
图 45展示了这样一个示例。假设有一个应用程序,其中两个独立的核函数 A 和 B 在两个不同的非阻塞 CUDA 流上运行。核函数 A 先启动,并开始执行,占用所有可用的 SM 资源。随后,当延迟敏感的核函数 B 启动时,已没有可用的 SM 资源。因此,核函数 B 只能在核函数 A 逐渐结束,即核函数 A 中的线程块完成执行后,才能开始执行。第一幅图展示了关键工作 B 被延迟的这一场景。y 轴表示被占用的 SM 的百分比,x 轴表示时间。
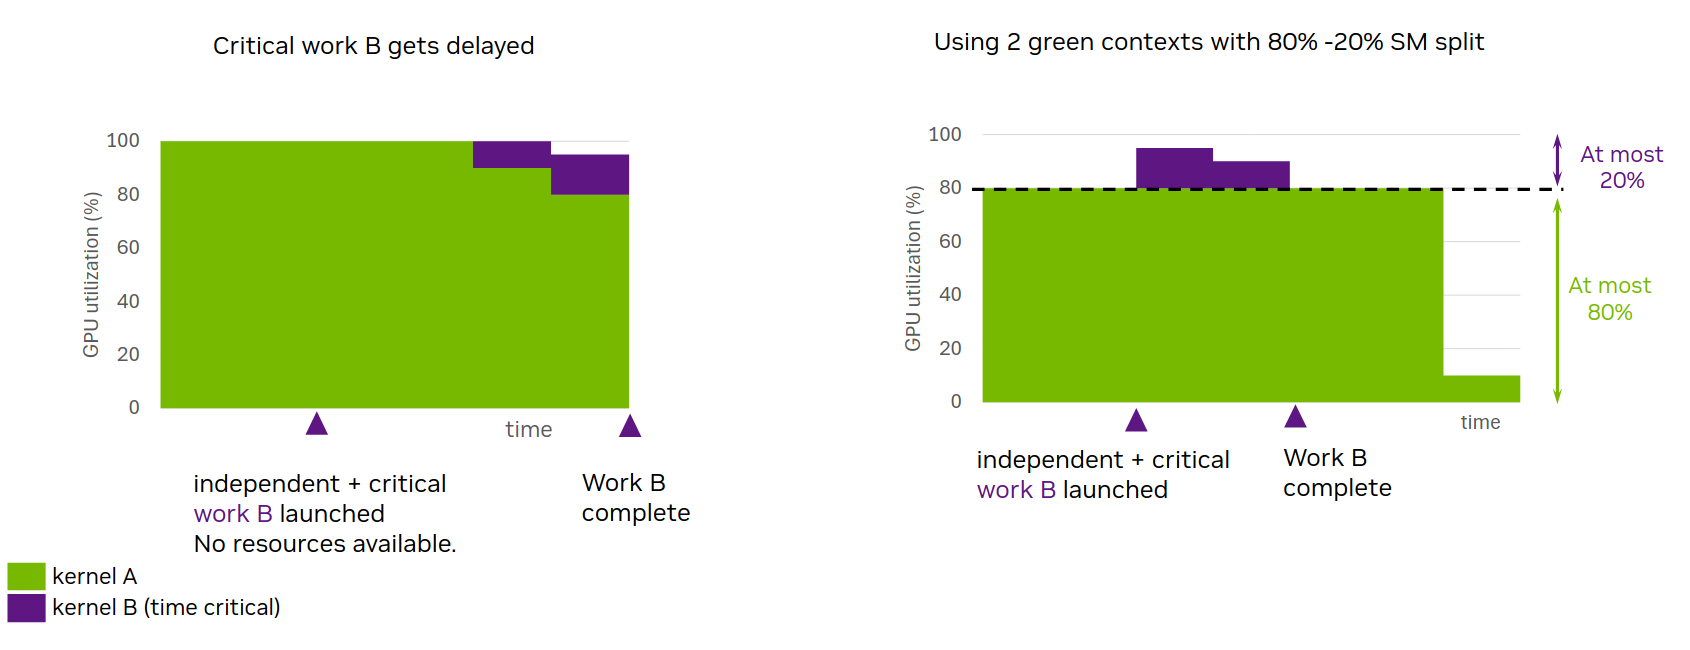
图 45 动机:绿色上下文(GC)的静态资源分区使延迟敏感的工作 B 能够更早开始和完成
图内文字中文对照
Critical work B gets delayed- 关键工作 B 被延迟
GPU utilization (%)- GPU 利用率(%)
independent + critical work B launched- 启动独立且关键的工作 B
No resources available.- 无可用资源。
time- 时间
Work B complete- 工作 B 完成
kernel A- 核函数 A
kernel B (time critical)- 核函数 B(时间关键)
Using 2 green contexts with 80% - 20% SM split- 使用 2 个绿色上下文,按 80% - 20% 划分流式多处理器
At most 20%- 最多 20%
At most 80%- 最多 80%
使用绿色上下文,可以对 GPU 的 SM 进行分区,使核函数 A 所面向的绿色上下文 A 能够访问 GPU 的一部分 SM,而核函数 B 所面向的绿色上下文 B 能够访问其余 SM。在此设置下,无论核函数 A 的启动配置如何,它都只能使用为绿色上下文 A 配置的 SM。因此,当关键核函数 B 启动时,只要没有其他资源限制,就能保证有可用的 SM 供其立即开始执行。正如图 45中的第二幅图所示,尽管核函数 A 的持续时间可能增加,但延迟敏感的工作 B 将不再因没有可用的 SM 而被延迟。为了便于说明,图中为绿色上下文 A 配置的 SM 数量相当于 GPU 的 SM 总数的 80%。
无需对核函数 A 和 B 的代码进行任何修改,就可以实现这种行为。只需确保它们在属于相应绿色上下文的 CUDA 流上启动即可。每个绿色上下文能够访问的 SM 数量应由用户在创建绿色上下文时根据具体情况决定。
工作队列:
流式多处理器是可以为绿色上下文配置的一种资源类型。另一种资源类型是工作队列。可以将工作队列看作一种黑盒资源抽象,它也会与其他因素一起影响 GPU 工作执行的并发性。如果独立的 GPU 工作任务(例如在不同 CUDA 流上提交的核函数)映射到同一个工作队列,则可能在这些任务之间引入伪依赖,从而导致它们串行执行。用户可以通过CUDA_DEVICE_MAX_CONNECTIONS环境变量影响 GPU 上工作队列数量的上限(请参阅第 5.2 节、第 3.1 节)。
在前一个示例的基础上,假设工作 B 与工作 A 映射到同一个工作队列。在这种情况下,即使有可用的 SM 资源(绿色上下文的情况),工作 B 仍可能需要等待工作 A 全部完成。与 SM 类似,用户无法直接控制底层可能使用的具体工作队列。但是,绿色上下文允许用户通过预期的并发流有序工作负载数量,表达其期望的最大并发度。驱动程序随后可以将此值用作提示,尝试避免来自不同执行上下文的工作使用同一个或同一组工作队列,从而防止执行上下文之间出现不必要的干扰。
注意
即使为每个绿色上下文配置了不同的 SM 资源和工作队列,也不能保证独立的 GPU 工作能够并发执行。最好将绿色上下文一节中介绍的所有技术理解为消除可能阻止并发执行的因素(即减少潜在干扰)。
绿色上下文与 MIG 或 MPS 的比较
为求完整,本节简要比较绿色上下文与另外两种资源分区机制:MIG(多实例 GPU)和MPS(多进程服务)。
MIG 将支持 MIG 的 GPU 静态地划分为多个 MIG 实例(“更小的 GPU”)。这种分区必须在应用程序启动之前进行,不同的应用程序可以使用不同的 MIG 实例。对于应用程序始终未能充分利用可用 GPU 资源的用户,使用 MIG 可能会有所帮助;随着 GPU 规模的增大,这一问题会更加突出。借助 MIG,用户可以在不同的 MIG 实例上运行这些不同的应用程序,从而提高 GPU 利用率。MIG 对云服务提供商(CSP)可能很有吸引力,不仅因为它能够提高此类应用程序的 GPU 利用率,还因为它能够为在不同 MIG 实例上运行的客户端提供服务质量(QoS)保障和隔离。有关更多详细信息,请参阅上文链接的 MIG 文档。
但是,使用 MIG 无法解决前面描述的问题场景,即由于同一应用程序中的其他 GPU 工作占用了所有 SM 资源,关键工作 B 被延迟。对于在单个 MIG 实例上运行的应用程序,这一问题仍可能存在。为解决此问题,可以将绿色上下文与 MIG 一起使用。在这种情况下,可用于分区的 SM 资源将是给定 MIG 实例的资源。
MPS 主要面向不同的进程(例如 MPI 程序),使它们无需时间分片就能同时在 GPU 上运行。它要求 MPS 守护进程在应用程序启动之前就已运行。默认情况下,MPS 客户端将争用其所运行的 GPU 或 MIG 实例的所有可用 SM 资源。在这种具有多个客户端进程的设置中,MPS 可以使用活动线程百分比选项支持 SM 资源的动态分区,该选项对 MPS 客户端进程可使用的 SM 百分比设置上限。与绿色上下文不同,MPS 中的活动线程百分比分区是在进程级别进行的,并且该百分比通常在应用程序启动之前通过环境变量指定。MPS 活动线程百分比表示,给定客户端应用程序使用的 SM 不得超过 GPU 的 SM 总数的x%,设此数量为 N 个 SM。然而,这些 SM 可以是 GPU 上的任意 N 个 SM,并且也可以随时间变化。另一方面,在创建时配置了 N 个 SM 的绿色上下文只能使用这 N 个特定的 SM。
从 CUDA 13.1 开始,如果在启动 MPS 控制守护进程时显式启用静态分区,MPS 也支持静态分区。使用静态分区时,用户必须在应用程序启动时指定 MPS 客户端进程可以使用的静态分区。在这种情况下,使用活动线程百分比的动态共享不再适用。静态分区模式下的 MPS 与绿色上下文之间的一个关键区别在于,MPS 面向不同的进程,而绿色上下文也适用于单个进程内部。此外,与绿色上下文不同,使用静态分区的 MPS 不允许超额订阅 SM 资源。
使用 MPS 时,对于通过cuCtxCreate驱动程序 API 创建并具有执行亲和性的 CUDA 上下文,还可以通过编程方式对 SM 资源进行分区。这种编程式分区允许来自一个或多个进程的不同客户端 CUDA 上下文各自使用不超过指定数量的 SM。与活动线程百分比分区一样,这些 SM 可以是 GPU 上的任意 SM,并且可以随时间变化,这与绿色上下文的情况不同。即使存在静态 MPS 分区,也可以使用此选项。请注意,与 MPS 上下文相比,创建绿色上下文要轻量得多,因为许多底层结构由主上下文拥有,因而是共享的。
4.6.2. 绿色上下文:易用性
为了突出绿色上下文的易用性,假设您有以下代码片段,它创建两个 CUDA 流,然后调用一个函数,通过<<<>>>在这些 CUDA 流上启动核函数。如前所述,除了更改核函数的启动几何配置之外,无法影响这些核函数可以使用的 SM 数量。
int gpu_device_index = 0; // GPU ordinal
CUDA_CHECK(cudaSetDevice(gpu_device_index));

cudaStream_t strm1, strm2;
CUDA_CHECK(cudaStreamCreateWithFlags(&strm1, cudaStreamNonBlocking));
CUDA_CHECK(cudaStreamCreateWithFlags(&strm2, cudaStreamNonBlocking));

// No control over how many SMs kernel(s) running on each stream can use
code_that_launches_kernels_on_streams(strm1, strm2); // what is abstracted in this function + the kernels is the vast majority of your code

// cleanup code not shown
从 CUDA 13.1 开始,可以使用绿色上下文控制给定核函数能够访问的 SM 数量。下面的代码片段展示了实现这一点有多么简单。只需增加几行代码,而无需对核函数进行任何修改,就可以控制在这些不同流上启动的核函数能够使用的 SM 资源。
int gpu_device_index = 0; // GPU ordinal
CUDA_CHECK(cudaSetDevice(gpu_device_index));

/* ------------------ Code required to create green contexts --------------------------- */


// Get all available GPU SM resources
cudaDevResource initial_GPU_SM_resources {};
CUDA_CHECK(cudaDeviceGetDevResource(gpu_device_index, &initial_GPU_SM_resources, cudaDevResourceTypeSm));

// Split SM resources. This example creates one group with 16 SMs and one with 8. Assuming your GPU has >= 24 SMs
cudaDevSmResource result[2] {{}, {}};
cudaDevSmResourceGroupParams group_params[2] =  {
        {.smCount=16, .coscheduledSmCount=0, .preferredCoscheduledSmCount=0, .flags=0},
        {.smCount=8,  .coscheduledSmCount=0, .preferredCoscheduledSmCount=0, .flags=0}};
CUDA_CHECK(cudaDevSmResourceSplit(&result[0], 2, &initial_GPU_SM_resources, nullptr, 0, &group_params[0]));

// Generate resource descriptors for each resource
cudaDevResourceDesc_t resource_desc1 {};
cudaDevResourceDesc_t resource_desc2 {};
CUDA_CHECK(cudaDevResourceGenerateDesc(&resource_desc1, &result[0], 1));
CUDA_CHECK(cudaDevResourceGenerateDesc(&resource_desc2, &result[1], 1));

// Create green contexts
cudaExecutionContext_t my_green_ctx1 {};
cudaExecutionContext_t my_green_ctx2 {};
CUDA_CHECK(cudaGreenCtxCreate(&my_green_ctx1, resource_desc1, gpu_device_index, 0));
CUDA_CHECK(cudaGreenCtxCreate(&my_green_ctx2, resource_desc2, gpu_device_index, 0));

/* ------------------ Modified code --------------------------- */

// You just need to use a different CUDA API to create the streams
cudaStream_t strm1, strm2;
CUDA_CHECK(cudaExecutionCtxStreamCreate(&strm1, my_green_ctx1, cudaStreamDefault, 0));
CUDA_CHECK(cudaExecutionCtxStreamCreate(&strm2, my_green_ctx2, cudaStreamDefault, 0));

/* ------------------ Unchanged code --------------------------- */

// No need to modify any code in this function or in your kernel(s).
// Reminder: what is abstracted in this function + kernels is the vast majority of your code
// Now kernel(s) running on stream strm1 will use at most 16 SMs and kernel(s) on strm2 at most 8 SMs.
code_that_launches_kernels_on_streams(strm1, strm2);

// cleanup code not shown
各种执行上下文 API(其中一些已在前面的示例中展示)接受显式的cudaExecutionContext_t句柄,因此会忽略调用线程的当前上下文。在此之前,不使用驱动程序 API 的 CUDA 运行时用户默认情况下只会与主上下文交互,该主上下文通过cudaSetDevice()被隐式设置为线程的当前上下文。转向这种基于显式上下文的编程方式,可以提供更易于理解的语义,并且相比于此前依赖线程局部状态(TLS)的基于隐式上下文的编程方式,还可以带来其他好处。
以下各节将详细解释前一个代码片段中展示的所有步骤。
4.6.3. 绿色上下文:设备资源和资源描述符
绿色上下文的核心是与特定 GPU 设备绑定的设备资源(cudaDevResource)。可以将资源组合并封装到描述符(cudaDevResourceDesc_t)中。绿色上下文只能访问封装在用于创建它的描述符中的资源。
目前,cudaDevResource数据结构定义如下:
struct {
     enum cudaDevResourceType type;
     union {
         struct cudaDevSmResource sm;
         struct cudaDevWorkqueueConfigResource wqConfig;
         struct cudaDevWorkqueueResource wq;
     };
 };
支持的有效资源类型为cudaDevResourceTypeSm、cudaDevResourceTypeWorkqueueConfig和cudaDevResourceTypeWorkqueue,而cudaDevResourceTypeInvalid标识无效的资源类型。
有效的设备资源可以关联:
一组特定的流式多处理器(SM)(资源类型为
cudaDevResourceTypeSm),特定的工作队列配置(资源类型为
cudaDevResourceTypeWorkqueueConfig),或预先存在的工作队列资源(资源类型为
cudaDevResourceTypeWorkqueue)。
可以分别使用cudaExecutionCtxGetDevResource和cudaStreamGetDevResource API,查询给定执行上下文或 CUDA 流是否与给定类型的cudaDevResource资源相关联。执行上下文也可以与不同类型的设备资源(例如 SM 和工作队列)相关联,而流只能与 SM 类型的资源相关联。
默认情况下,给定 GPU 设备具有全部三种设备资源类型:包含 GPU 上所有 SM 的 SM 类型资源、包含所有可用工作队列的工作队列配置资源,以及其对应的工作队列资源。可以通过cudaDeviceGetDevResource API 获取这些资源。
相关设备资源结构体概述
不同资源类型的结构体具有由用户显式设置或由相关 CUDA API 调用设置的字段。建议对所有设备资源结构体进行零初始化。
SM 类型的设备资源(
cudaDevSmResource)具有以下相关字段:unsigned int smCount:此资源中可用的 SM 数量unsigned int minSmPartitionSize:对此资源进行分区所需的最小 SM 数量unsigned int smCoscheduledAlignment:资源中保证被协同调度到同一个 GPU 处理簇上的 SM 数量,这与线程块簇有关。当flags为零时,smCount是此值的倍数。unsigned int flags:支持的标志为 0(默认)、cudaDevSmResourceGroupBackfill和cudaDevSmResourceGroupLocalityDomainId(请参阅cudaDevSmResourceGroup的标志)。
上述字段将通过用于创建此 SM 类型资源的相应拆分 API(
cudaDevSmResourceSplitByCount或cudaDevSmResourceSplit)来设置,或由获取给定 GPU 设备的 SM 资源的cudaDeviceGetDevResourceAPI 填充。用户绝不应直接设置这些字段。有关更多详细信息,请参阅下一节。工作队列配置设备资源(
cudaDevWorkqueueConfigResource)具有以下相关字段:int device:工作队列资源所在的设备unsigned int wqConcurrencyLimit:期望避免伪依赖的流有序工作负载的数量enum cudaDevWorkqueueConfigScope sharingScope:工作队列资源的共享作用域。支持的值为:cudaDevWorkqueueConfigScopeDeviceCtx(默认)和cudaDevWorkqueueConfigScopeGreenCtxBalanced。使用默认选项时,所有工作队列资源在所有上下文之间共享,而使用均衡选项时,驱动程序会以用户指定的wqConcurrencyLimit作为提示,尽可能尝试在不同绿色上下文中使用互不重叠的工作队列资源。
这些字段需要由用户设置。除了由
cudaDeviceGetDevResourceAPI 填充的工作队列配置资源之外,没有类似于拆分 API、能够生成工作队列配置资源的 CUDA API。该 API 可以获取给定 GPU 设备的工作队列配置资源。最后,预先存在的工作队列资源(
cudaDevResourceTypeWorkqueue)没有可由用户设置的字段。与其他资源类型一样,cudaDevGetDevResource可以获取给定 GPU 设备的预先存在的工作队列资源。
4.6.4. 绿色上下文创建示例
创建绿色上下文涉及四个主要步骤:
步骤 1:从一组初始资源开始,例如获取 GPU 的可用资源
步骤 2:将 SM 资源划分为一个或多个分区(使用可用的拆分 API 之一)。
步骤 3:创建资源描述符,并根据需要组合不同的资源
步骤 4:根据描述符创建绿色上下文,为其配置资源
创建绿色上下文后,可以创建属于该绿色上下文的 CUDA 流。随后在这样的流上启动的 GPU 工作(例如通过<<< >>>启动的核函数)将只能访问为此绿色上下文配置的资源。只要用户向库传递属于绿色上下文的流,库也可以轻松利用绿色上下文。有关更多详细信息,请参阅绿色上下文:启动工作。
4.6.4.1. 步骤 1:获取可用的 GPU 资源
创建绿色上下文的第一步是获取可用的设备资源,并填充一个或多个cudaDevResource结构体。目前有三种可能的起点:设备、执行上下文或 CUDA 流。
相关的 CUDA 运行时 API 函数签名如下所示:
对于设备:
cudaError_t cudaDeviceGetDevResource(int device, cudaDevResource* resource, cudaDevResourceType type)对于执行上下文:
cudaError_t cudaExecutionCtxGetDevResource(cudaExecutionContext_t ctx, cudaDevResource* resource, cudaDevResourceType type)对于流:
cudaError_t cudaStreamGetDevResource(cudaStream_t hStream, cudaDevResource* resource, cudaDevResourceType type)
这些 API 都允许使用所有有效的cudaDevResourceType类型,但cudaStreamGetDevResource除外,它仅支持 SM 类型的资源。
通常,起点是 GPU 设备。下面的代码片段展示了如何获取给定 GPU 设备的可用 SM 资源。成功调用cudaDeviceGetDevResource后,用户可以查看此资源中可用的 SM 数量。
int current_device = 0; // assume device ordinal of 0
CUDA_CHECK(cudaSetDevice(current_device));

cudaDevResource initial_SM_resources = {};
CUDA_CHECK(cudaDeviceGetDevResource(current_device /* GPU device */,
                                   &initial_SM_resources /* device resource to populate */,
                                   cudaDevResourceTypeSm /* resource type*/));

std::cout << "Initial SM resources: " << initial_SM_resources.sm.smCount << " SMs" << std::endl; // number of available SMs

// Special fields relevant for partitioning (see Step 3 below)
std::cout << "Min. SM partition size: " <<  initial_SM_resources.sm.minSmPartitionSize << " SMs" << std::endl;
std::cout << "SM co-scheduled alignment: " <<  initial_SM_resources.sm.smCoscheduledAlignment << " SMs" << std::endl;
还可以获取可用的工作队列配置资源,如下面的代码片段所示。
int current_device = 0; // assume device ordinal of 0
CUDA_CHECK(cudaSetDevice(current_device));

cudaDevResource initial_WQ_config_resources = {};
CUDA_CHECK(cudaDeviceGetDevResource(current_device /* GPU device */,
                                   &initial_WQ_config_resources /* device resource to populate */,
                                   cudaDevResourceTypeWorkqueueConfig /* resource type*/));

std::cout << "Initial WQ config. resources: " << std::endl;
std::cout << "  - WQ concurrency limit: " << initial_WQ_config_resources.wqConfig.wqConcurrencyLimit << std::endl;
std::cout << "  - WQ sharing scope: " << initial_WQ_config_resources.wqConfig.sharingScope << std::endl;
成功调用cudaDeviceGetDevResource后,用户可以查看此资源的wqConcurrencyLimit。当起点为 GPU 设备时,wqConcurrencyLimit将与CUDA_DEVICE_MAX_CONNECTIONS环境变量的值或其默认值相同。
4.6.4.2. 步骤 2:划分 SM 资源
创建绿色上下文的第二步是将可用的cudaDevResourceSM 资源静态拆分为一个或多个分区,可能会有一些 SM 留在一个剩余分区中。可以使用cudaDevSmResourceSplitByCount()或cudaDevSmResourceSplit()API 进行这种划分。cudaDevSmResourceSplitByCount()API 只能创建一个或多个同构分区,以及一个可能存在的剩余分区,而cudaDevSmResourceSplit()API 还可以创建异构分区,以及一个可能存在的剩余分区。后续各节将详细介绍这两个 API 的功能。这两个 API 都仅适用于 SM 类型的设备资源。
cudaDevSmResourceSplitByCount API
cudaDevSmResourceSplitByCount运行时 API 的签名为:
cudaError_t cudaDevSmResourceSplitByCount(cudaDevResource* result, unsigned int* nbGroups, const cudaDevResource* input,
cudaDevResource* remaining, unsigned int useFlags, unsigned int minCount)
如图 46所强调的,用户请求将inputSM 类型的设备资源拆分为*nbGroups个同构组,每组包含minCount个 SM。然而,最终结果将包含数量可能经过更新的*nbGroups个同构组,每组包含N个 SM。可能经过更新的*nbGroups将小于或等于最初请求的组数,而N将等于或大于minCount。这些调整可能是由一些特定于架构的粒度和对齐要求引起的。
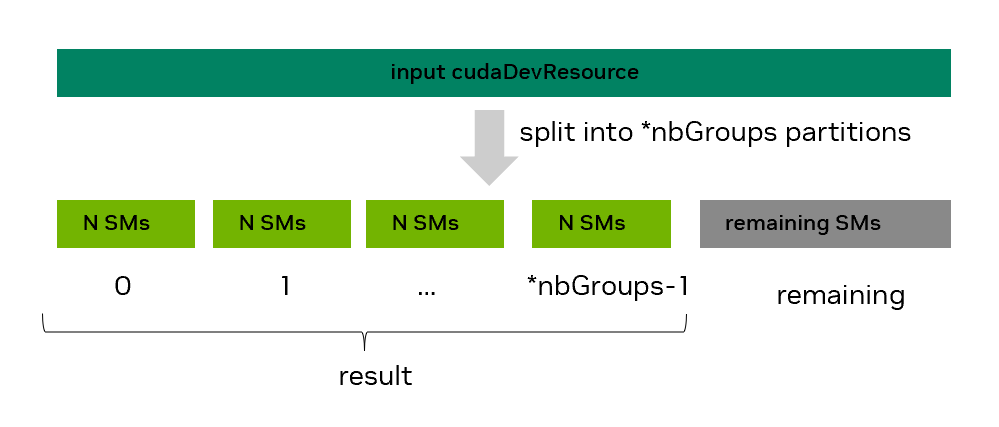
图 46 使用 cudaDevSmResourceSplitByCount API 拆分 SM 资源
图内文字中文对照
input cudaDevResource- 输入 cudaDevResource
split into *nbGroups partitions- 划分为 *nbGroups 个分区
N SMs- N 个流式多处理器
remaining SMs- 剩余流式多处理器
remaining- 剩余部分
result- 结果
表 30列出了在默认useFlags=0情况下,所有当前支持的计算能力的最小 SM 分区大小以及 SM 协同调度的对齐要求。还可以通过cudaDevSmResource的minSmPartitionSize和smCoscheduledAlignment字段获取这些值,如步骤 1:获取可用的 GPU 资源所示。通过使用不同的useFlags值,可以降低其中一些要求。表 14提供了一些相关示例,突出展示了请求与最终结果之间的差异,并附有说明。该表重点介绍计算能力(CC 9.0),在该计算能力下,如果useFlags为零,则每个分区的 SM 数量最少为 8,且 SM 数量必须是 8 的倍数。
请求的结果 |
实际结果(对于具有 132 个 SM 的 GH200) |
||||
|---|---|---|---|---|---|
|
minCount |
useFlags |
|
剩余 SM |
原因 |
2 |
72 |
0 |
1 组,包含 72 个 SM |
60 |
不能超过 132 个 SM |
6 |
11 |
0 |
6 组,每组包含 16 个 SM |
36 |
必须为 8 的倍数的要求 |
6 |
11 |
|
6 组,每组包含 12 个 SM |
60 |
要求降低为必须是 2 的倍数 |
2 |
1 |
0 |
2 组,每组包含 8 个 SM |
116 |
至少包含 8 个 SM 的要求 |
以下代码片段请求将可用的 SM 资源拆分为五组,每组包含8 个 SM:
cudaDevResource avail_resources = {};
// Code that has populated avail_resources not shown

unsigned int min_SM_count = 8;
unsigned int actual_split_groups = 5; // may be updated

cudaDevResource actual_split_result[5] = {{}, {}, {}, {}, {}};
cudaDevResource remaining_partition = {};

CUDA_CHECK(cudaDevSmResourceSplitByCount(&actual_split_result[0],
                                         &actual_split_groups,
                                         &avail_resources,
                                         &remaining_partition,
                                         0 /*useFlags */,
                                         min_SM_count));

std::cout << "Split " << avail_resources.sm.smCount << " SMs into " << actual_split_groups << " groups " \
          << "with " << actual_split_result[0].sm.smCount << " each " \
          << "and a remaining group with " << remaining_partition.sm.smCount << " SMs" << std::endl;
请注意:
可以使用
result=nullptr来查询将要创建的组数如果不关心剩余分区的 SM,可以设置
remaining=nullptrremaining(剩余的)分区不具有与result中同构组相同的功能或性能保证。
在默认情况下,
useFlags应为 0,但也支持cudaDevSmResourceSplitIgnoreSmCoscheduling和cudaDevSmResourceSplitMaxPotentialClusterSize这两个值对于产生的任何
cudaDevResource,必须先用它创建资源描述符和绿色上下文(即下面的步骤 3 和 4),才能重新对其进行划分
有关更多详细信息,请参阅cudaDevSmResourceSplitByCount运行时 API 参考。
cudaDevSmResourceSplit API
如前所述,单次cudaDevSmResourceSplitByCountAPI 调用只能创建同构分区,即具有相同 SM 数量的分区,以及剩余分区。这可能会限制异构工作负载,在这类工作负载中,在不同绿色上下文上运行的工作对 SM 数量有不同的要求。要使用按数量拆分的 API 实现异构分区,通常需要通过(多次)重复步骤 1 至 4 来重新划分现有资源。或者,在某些情况下,可以在步骤 2 中创建同构分区,使每个分区的 SM 数量等于所有异构分区 SM 数量的 GCD(最大公约数),然后在步骤 3 中将所需数量的这些分区合并在一起。不过,不建议采用后一种方法,因为如果一开始就请求较大的分区大小,CUDA 驱动程序可能能够创建更好的分区。
cudaDevSmResourceSplitAPI 旨在解决这些限制,它允许用户在单次调用中创建不重叠的异构分区。cudaDevSmResourceSplit运行时 API 的签名为:
cudaError_t cudaDevSmResourceSplit(cudaDevResource* result, unsigned int nbGroups, const cudaDevResource* input,
cudaDevResource* remainder, unsigned int flags, cudaDevSmResourceGroupParams* groupParams)
此 API 将尝试根据groupParams数组中为每个资源指定的要求,将inputSM 类型资源划分为nbGroups个有效设备资源(组),并将其放入result数组中。也可以选择创建一个剩余分区。拆分成功后,如图 47所示,result中的每个资源可以具有不同数量的 SM,但 SM 数量绝不会为零。
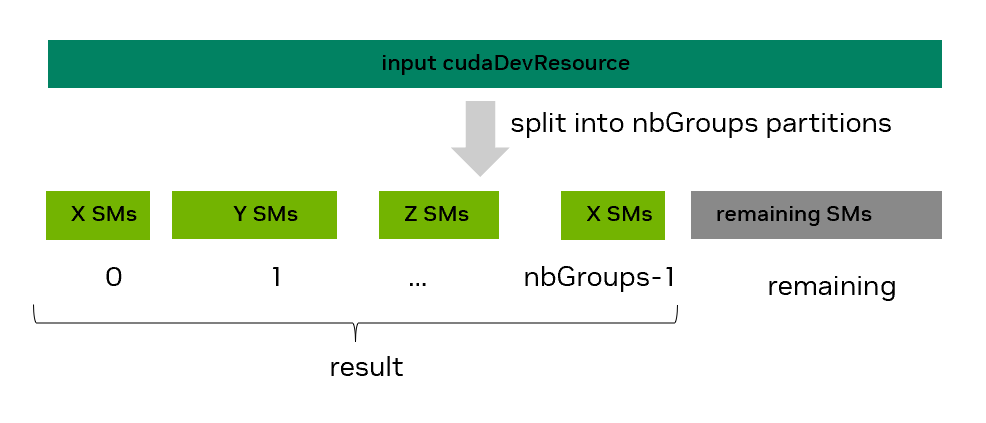
图 47 使用 cudaDevSmResourceSplit API 拆分 SM 资源
图内文字中文对照
input cudaDevResource- 输入 cudaDevResource
split into nbGroups partitions- 划分为 nbGroups 个分区
X SMs- X 个流式多处理器
Y SMs- Y 个流式多处理器
Z SMs- Z 个流式多处理器
remaining SMs- 剩余流式多处理器
remaining- 剩余部分
result- 结果
请求异构拆分时,需要为result中的每个资源指定 SM 数量(相应groupParams条目的smCount字段)。此 SM 数量应始终为 2 的倍数。对于上一幅图中的情形,groupParams[0].smCount将为X,groupParams[1].smCount将为Y,依此类推。但是,如果应用程序使用线程块簇,仅指定 SM 数量是不够的。由于一个簇中的所有线程块都保证会被协同调度,因此用户还需要指定给定资源组应支持的最大簇大小(如果支持簇)。这可以通过相应groupParams条目的coscheduledSmCount字段实现。对于计算能力为 10.0 及更高版本(CC 10.0+)的 GPU,簇还可以具有首选维度,该维度是其默认簇维度的倍数。在受支持系统上的单次核函数启动期间,如果能够使用这个较大的首选簇维度,就会尽可能使用它,否则使用较小的默认簇维度。用户可以通过相应groupParams条目的preferredCoscheduledSmCount字段表达此首选簇维度提示。最后,在某些情况下,用户可能希望放宽 SM 数量要求,将更多可用的 SM 纳入给定组中;用户可以将相应groupParams条目的flags字段设置为其非默认标志值,来表达此回填选项。
此 API 允许一个组以某个局部性域为目标。在cudaDevSmResourceGroupParams.flags字段中设置cudaDevSmResourceGroupLocalityDomainId,并将cudaDevSmResourceGroupParams.localityDomainId设置为该资源的有效局部性域 ID。随后,cudaDevSmResourceSplit会从该局部性域中选择 SM。如果还设置了cudaDevSmResourceGroupBackfill,CUDA 可能会在优先使用目标域之后,使用来自所请求局部性域之外的 SM 填充该组。
有关整体编程模型,请参阅局部性域。
为了提供更大的灵活性,cudaDevSmResourceSplitAPI 还具有发现模式,可在事先不知道一个或多个组的确切 SM 数量时使用。例如,用户可能希望创建一个设备资源,使其在满足某些协同调度要求(例如,允许大小为 4 的簇)的同时,包含尽可能多的 SM。要使用此发现模式,用户可以将相应的一个或多个groupParams条目的smCount字段设置为零。成功调用cudaDevSmResourceSplit后,groupParams的smCount字段将被填入一个有效的非零值;我们将此值称为实际smCount值。如果result不为空(因此这不是试运行),那么result中相应组的smCount也将被设置为相同的值。指定这nbGroups个groupParams条目的顺序很重要,因为它们是从左(索引 0)到右(索引 nbGroups-1)依次求值的。
表 15概述了cudaDevSmResourceSplitAPI 支持的参数。
groupParams 数组;显示条目 i,其中 i [0, nbGroups) |
||||||||
|---|---|---|---|---|---|---|---|---|
result |
nbGroups |
input |
remainder |
flags |
smCount |
coscheduledSmCount |
preferredCoscheduledSmCount |
flags |
进行探索性试运行时为 nullptr;否则为非空指针 |
组数 |
要拆分为 nbGroups 个组的资源 |
如果不需要剩余组,则为 nullptr |
0 |
0 表示发现模式,或为其他有效的 smCount 值 |
0(默认值),或有效的协同调度 SM 数量 |
0(默认值),或有效的首选协同调度 SM 数量(提示) |
0(默认值)、cudaDevSmResourceGroupBackfill 或 cudaDevSmResourceGroupLocalityDomainId |
注意:
cudaDevSmResourceSplitAPI 的返回值取决于result:
result != nullptr:只有在拆分成功且已创建nbGroups个满足指定要求的有效cudaDevResource组时,此 API 才会返回cudaSuccess;否则,它将返回错误。由于不同类型的错误可能返回相同的错误代码(例如cudaErrorInvalidResourceConfiguration),因此建议在开发期间使用CUDA_LOG_FILE环境变量来获取更详尽的错误描述。
result == nullptr:即使某个组产生的smCount为零,此 API 也可能返回cudaSuccess,而在result不为 nullptr 时,这种情况会返回错误。可以将此模式视为探索所支持功能时可使用的试运行测试,尤其是在发现模式下。
当 result != nullptr 且调用成功时,产生的
result[i]设备资源(其中 i 位于[0, nbGroups)中)将具有cudaDevResourceTypeSm类型,并具有一个result[i].sm.smCount,其值将是用户指定的非零groupParams[i].smCount值或发现的值。无论哪种情况,result[i].sm.smCount都将满足以下全部约束:
为
multiple of 2,并且位于
[2, input.sm.smCount]范围内,并且当未设置
cudaDevSmResourceGroupBackfill时,为groupParams[i].coscheduledSmCount的倍数;当设置了回填时,大于或等于该值。
将
coscheduledSmCount和preferredCoscheduledSmCount字段中的任意一个指定为零,表示应使用该字段的默认值;这些默认值可能因 GPU 而异。这两个默认值都等于通过cudaDeviceGetDevResourceAPI 为给定设备获取的 SM 资源的smCoscheduledAlignment(而不是任意 SM 资源的该值)。要查看这些默认值,可以先将它们设置为 0,然后在成功调用cudaDevSmResourceSplit后,检查相应groupParams条目中它们更新后的值;请参阅下文。
int gpu_device_index = 0;
cudaDevResource initial_GPU_SM_resources {};
CUDA_CHECK(cudaDeviceGetDevResource(gpu_device_index, &initial_GPU_SM_resources, cudaDevResourceTypeSm));
std::cout << "Default value will be equal to " << initial_GPU_SM_resources.sm.smCoscheduledAlignment << std::endl;

int default_split_flags = 0;
cudaDevSmResourceGroupParams group_params_tmp = {.smCount=0, .coscheduledSmCount=0, .preferredCoscheduledSmCount=0, .flags=0};
CUDA_CHECK(cudaDevSmResourceSplit(nullptr, 1, &initial_GPU_SM_resources, nullptr /*remainder*/, default_split_flags, &group_params_tmp));
std::cout << "coscheduledSmcount default value: " << group_params.coscheduledSmCount << std::endl;
std::cout << "preferredCoscheduledSmcount default value: " << group_params.preferredCoscheduledSmCount << std::endl;
如果存在剩余组,其 SM 数量或协同调度要求将不受任何约束。这需要由用户自行探索。
在提供各个cudaDevSmResourceGroupParams字段的更详细信息之前,表 16展示了在一些示例用例中这些值可能是什么。假定已经像前面的代码片段一样填充了initial_GPU_SM_resources设备资源,且它就是将要拆分的资源。表中的每一行都具有相同的起点。为简单起见,该表仅展示每个用例的nbGroups值和groupParams字段,这些值和字段可用于如下所示的代码片段。
int nbGroups = 2; // update as needed
unsigned int default_split_flags = 0;
cudaDevResource remainder {}; // update as needed
cudaDevResource result_use_case[2] = {{}, {}}; // Update depending on number of groups planned. Increase size if you plan to also use a workqueue resource
cudaDevSmResourceGroupParams group_params_use_case[2] = {{.smCount = X, .coscheduledSmCount=0, .preferredCoscheduledSmCount = 0, .flags = 0},
                                                         {.smCount = Y, .coscheduledSmCount=0, .preferredCoscheduledSmCount = 0, .flags = 0}}
CUDA_CHECK(cudaDevSmResourceSplit(&result_use_case[0], nbGroups, &initial_GPU_SM_resources, remainder, default_split_flags, &group_params_use_case[0]));
groupParams[i] 字段(i 按升序显示;请参阅最后一列) |
i |
|||||||
|---|---|---|---|---|---|---|---|---|
# |
目标/用例 |
nbGroups |
remainder |
smCount |
coscheduledSmCount |
preferredCoscheduledSmCount |
flags |
|
1 |
具有 16 个 SM 的资源。不关心剩余 SM。可能使用簇。 |
1 |
nullptr |
16 |
0 |
0 |
0 |
0 |
2a |
一个资源具有 16 个 SM,另一个资源包含其余所有 SM。不会使用簇。 (注意:这里展示了两个选项:在选项 (2a) 中,第 2 个资源是 remainder;在选项 (2b) 中,它是 result_use_case[1]。) |
1 (2a) |
非 nullptr |
16 |
2 |
2 |
0 |
0 |
2b |
2 (2b) |
nullptr |
16 |
2 |
2 |
0 |
0 |
|
0 |
2 |
2 |
cudaDevSmResourceGroupBackfill |
1 |
||||
3 |
两个资源分别具有 28 个和 32 个 SM。将使用大小为 4 的簇。 |
2 |
nullptr |
28 |
4 |
4 |
0 |
0 |
32 |
4 |
4 |
0 |
1 |
||||
4 |
一个资源包含尽可能多的 SM,能够运行大小为 8 的簇,另有一个剩余资源。 |
1 |
非 nullptr |
0 |
8 |
8 |
0 |
0 |
5 |
一个资源包含尽可能多的 SM,能够运行大小为 4 的簇,另一个资源具有 8 个 SM。 (注意:顺序很重要!更改 groupParams 数组中条目的顺序,可能意味着没有剩余 SM 可供那个需要 8 个 SM 的组使用) |
2 |
nullptr |
8 |
2 |
2 |
0 |
0 |
0 |
4 |
4 |
0 |
1 |
||||
有关 cudaDevSmResourceGroupParams 结构体各个字段的详细信息
smCount:
控制 result 中相应组的 SM 数量。
取值:0(发现模式),或有效的非零值(非发现模式)
有效的非零
smCount值的要求:(multiple of 2) and in [2, input->sm.smCount] and ((flags == 0) ? multiple of actual coscheduledSmCount : greater than or equal to coscheduledSmCount)
用例:在 SM 数量未知或不固定时,使用发现模式探索可行的情况;使用非发现模式请求特定数量的 SM。
注意:在发现模式下,当 result 不为 nullptr 且拆分调用成功后,实际 SM 数量将满足有效非零值的要求
coscheduledSmCount:
控制分组在一起(“协同调度”)的 SM 数量,以便在计算能力为 9.0 及更高版本的设备上启动不同的簇。因此,它可以影响所产生组中的 SM 数量及其能够支持的簇大小。
取值:0(当前架构的默认值),或有效的非零值
有效非零值的要求:
(multiple of 2),不超过上限
用例:对于簇,使用默认值或手动选择的值,同时要考虑给定架构上的最大可移植簇大小。如果代码不使用簇,可以使用所支持的最小值 2 或默认值。
注意:使用默认值时,成功进行拆分调用后的实际
coscheduledSmCount也将满足有效非零值的要求。如果 flags 不为零,则产生的 smCount 将 >= coscheduledSmCount。可以将 coscheduledSmCount 视为为产生的有效组提供某种有保证的底层“结构”(即在最坏情况下,该组至少可以运行一个大小为 coscheduledSmCount 的簇)。这类结构保证不适用于剩余组;对于剩余组,需要由用户自行探索能够启动哪些大小的簇。
preferredCoscheduledSmCount:
用作给驱动程序的提示,使其在可能的情况下尝试将每组实际包含
coscheduledSmCount个 SM 的组,合并为包含preferredCoscheduledSmCount个 SM 的更大组。这样可以让代码利用计算能力(CC)为 10.0 及更高版本的设备上提供的首选簇维度功能)。请参阅cudaLaunchAttributeValue::preferredClusterDim。取值:0(当前架构的默认值),或有效的非零值
有效非零值的要求:
(multiple of actual coscheduledSmCount)
用例:如果使用首选簇,并且所用设备的计算能力为 10.0(Blackwell)或更高版本,则使用手动选择的大于 2 的值。如果不使用簇,请选择与
coscheduledSmCount相同的值:或者选择所支持的最小值 2,或者两者都使用 0注意:使用默认值时,成功进行拆分调用后的实际
preferredCoscheduledSmCount也将满足有效非零值的要求。
flags:
控制一个组产生的 SM 数量是否为实际协同调度 SM 数量的倍数(默认情况),或者是否可以向该组回填 SM(回填情况)。在回填情况下,产生的 SM 数量(
result[i].sm.smCount)将大于或等于指定的groupParams[i].smCount。取值:0(默认值)或
cudaDevSmResourceGroupBackfill用例:使用零值(默认值),这样,生成的组便能保证具有支持多个大小为 coScheduledSmCount 的簇的灵活性。如果希望在组中获得尽可能多的 SM,则使用回填选项,其中一些 SM(回填的那些 SM)不提供任何协同调度保证。
注意:使用回填标志创建的组仍然可以支持簇(例如,保证至少支持一个大小为 coscheduledSmCount 的簇)。
4.6.4.3. 步骤 2(续):添加工作队列资源
如果还希望指定工作队列资源,则需要显式执行此操作。以下示例展示如何为特定设备创建一个工作队列配置资源,该资源具有均衡的共享作用域,并发上限为四。
cudaDevResource split_result[2] = {{}, {}};
// code to populate split_result[0] not shown; used split API with nbGroups=1

// The last resource will be a workqueue resource.
split_result[1].type = cudaDevResourceTypeWorkqueueConfig;
split_result[1].wqConfig.device = 0; // assume device ordinal of 0
split_result[1].wqConfig.sharingScope = cudaDevWorkqueueConfigScopeGreenCtxBalanced;
split_result[1].wqConfig.wqConcurrencyLimit = 4;
工作队列并发上限为四,是向驱动程序提示用户期望最多有四个并发的流有序工作负载。驱动程序在分配工作队列时,会尽可能尝试遵循这一提示。
4.6.4.4. 步骤 3:创建资源描述符
拆分资源之后,下一步是使用cudaDevResourceGenerateDesc API,为预期可供绿色上下文使用的所有资源生成资源描述符。
相关的 CUDA 运行时 API 函数签名如下:
cudaError_t cudaDevResourceGenerateDesc(cudaDevResourceDesc_t *phDesc, cudaDevResource *resources, unsigned int nbResources)
可以组合多个cudaDevResource资源。例如,下面的代码片段展示如何生成封装了三组资源的资源描述符。只需确保这些资源在resources数组中全部连续分配即可。
cudaDevResource actual_split_result[5] = {};
// code to populate actual_split_result not shown

// Generate resource desc. to encapsulate 3 resources: actual_split_result[2] to [4]
cudaDevResourceDesc_t resource_desc;
CUDA_CHECK(cudaDevResourceGenerateDesc(&resource_desc, &actual_split_result[2], 3));
也支持组合不同类型的资源。例如,可以生成一个同时包含 SM 资源和工作队列资源的描述符。
要使cudaDevResourceGenerateDesc调用成功,需满足以下条件:
所有
nbResources资源都应属于同一 GPU 设备。如果组合多个 SM 类型的资源,它们应由同一次拆分 API 调用生成,并具有相同的
coscheduledSmCount值(如果不属于剩余部分)只能存在一个工作队列配置资源或工作队列类型资源。
4.6.4.5. 步骤 4:创建绿色上下文
最后一步是使用cudaGreenCtxCreate API,根据资源描述符创建绿色上下文。该绿色上下文只能访问其创建时指定的资源描述符中封装的资源(例如,SM、工作队列)。这些资源将在此步骤中进行配置。
相关的 CUDA 运行时 API 函数签名如下:
cudaError_t cudaGreenCtxCreate(cudaExecutionContext_t *phCtx, cudaDevResourceDesc_t desc, int device, unsigned int flags)
flags参数应设置为 0。此外,建议在创建绿色上下文之前,通过cudaInitDevice API 或cudaSetDevice API 显式初始化设备的主上下文,这也会将主上下文设置为调用线程的当前上下文。这样可确保在创建绿色上下文期间不会产生额外的主上下文初始化开销。
请参见下面的代码片段。
int current_device = 0; // assume single GPU
CUDA_CHECK(cudaSetDevice(current_device)); // Or cudaInitDevice

cudaDevResourceDesc_t resource_desc {};
// Code to generate resource_desc not shown

// Create a green_ctx on GPU with current_device ID with access to resources from resource_desc
cudaExecutionContext_t green_ctx {};
CUDA_CHECK(cudaGreenCtxCreate(&green_ctx, resource_desc, current_device, 0));
成功创建绿色上下文后,用户可以针对每种资源类型,在该执行上下文上调用cudaExecutionCtxGetDevResource来验证其资源。
创建多个绿色上下文
应用程序可以拥有多个绿色上下文,在这种情况下,应重复上述某些步骤。对于大多数用例,每个绿色上下文都将拥有一组单独配置且互不重叠的 SM。例如,对于五个同质的cudaDevResource组(actual_split_result数组)的情况,一个绿色上下文的描述符可以封装 actual_split_result[2] 到 [4] 的资源,而另一个绿色上下文的描述符可以封装 actual_split_result[0] 到 [1]。在这种情况下,一个特定的 SM 将仅为该应用程序的两个绿色上下文之一配置。
不过,SM 超额订阅也是可能的,并且在某些情况下可以使用。例如,让第二个绿色上下文的描述符封装 actual_split_result[0] 到 [2] 可能是可以接受的。在这种情况下,actual_split_resource[2]cudaDevResource的所有 SM 都将被超额订阅,即为两个绿色上下文同时配置,而资源 actual_split_resource[0] 到 [1] 以及 actual_split_resource[3] 到 [4] 只能由这两个绿色上下文之一使用。应根据具体情况审慎使用 SM 超额订阅。
4.6.5. 绿色上下文:启动工作
要针对使用前述步骤创建的绿色上下文启动核函数,首先需要通过cudaExecutionCtxStreamCreate API 为该绿色上下文创建一个流。使用<<< >>>或cudaLaunchKernel API 在该流上启动核函数,将确保核函数只能使用通过该流的执行上下文向其提供的资源(SM、工作队列)。例如:
// Create green_ctx_stream CUDA stream for previously created green_ctx green context
cudaStream_t green_ctx_stream;
int priority = 0;
CUDA_CHECK(cudaExecutionCtxStreamCreate(&green_ctx_stream,
                                        green_ctx,
                                        cudaStreamDefault,
                                        priority));

// Kernel my_kernel will only use the resources (SMs, work queues, as applicable) available to green_ctx_stream's execution context
my_kernel<<<grid_dim, block_dim, 0, green_ctx_stream>>>();
CUDA_CHECK(cudaGetLastError());
鉴于green_ctx是绿色上下文,传递给上述流创建 API 的默认流创建标志等同于cudaStreamNonBlocking。
CUDA 图
对于作为 CUDA 图的一部分启动的核函数(参见CUDA 图),还有一些细微之处需要注意。与核函数不同,启动 CUDA 图所用的 CUDA 流并不决定所使用的 SM 资源,因为该流仅用于依赖关系跟踪。
核函数节点(以及其他适用的节点类型)将在哪个执行上下文上执行,是在创建节点时设置的。如果将使用流捕获来创建 CUDA 图,那么参与捕获的流的执行上下文将决定相关图节点的执行上下文。如果将使用图 API 来创建图,那么用户应为每个相关节点显式设置执行上下文。例如,要添加核函数节点,用户应使用多态cudaGraphAddNode API,将节点类型指定为cudaGraphNodeTypeKernel,并显式指定.kernel下的cudaKernelNodeParamsV2结构体的.ctx字段。cudaGraphAddKernelNode不允许用户指定执行上下文,因此应避免使用。请注意,同一图中的不同图节点可以属于不同的执行上下文。
为了验证,可以在节点跟踪模式(--cuda-graph-trace node)下使用 Nsight Systems,观察特定图节点将在哪些绿色上下文上执行。请注意,在默认的图跟踪模式下,整个图将显示在启动该图的流所属的绿色上下文下,但如前所述,这并不提供有关各个图节点执行上下文的任何信息。
要以编程方式进行验证,可以考虑使用 CUDA 驱动程序 APIcuGraphKernelNodeGetParams(graph_node, &node_params),并将node_params.ctx上下文句柄字段与该图节点的预期上下文句柄进行比较。由于CUgraphNode和cudaGraphNode_t可以互换使用,因此可以使用驱动程序 API,但用户需要包含相关的cuda.h头文件,并直接链接驱动程序(-lcuda)。
线程块簇
包含线程块簇的核函数(参见第 1.2.2.1.1 节)也可以像其他任何核函数一样,在绿色上下文流上启动,从而使用为该绿色上下文配置的资源。第 4.6.4.2 节展示了如何在拆分设备资源时指定需要协同调度的 SM 数量,以便支持簇。不过,与任何使用簇的核函数一样,用户应利用相关的占用率 API 来确定核函数的最大潜在簇大小(通过cudaOccupancyMaxPotentialClusterSize),并在需要时确定最大活跃簇数(cudaOccupancyMaxActiveClusters)。如果用户将绿色上下文流指定为相关cudaLaunchConfig的stream字段,则这些占用率 API 会将为该绿色上下文配置的 SM 资源纳入考虑。这一用例尤其适用于可能由用户传入绿色上下文 CUDA 流的库,以及使用剩余设备资源创建绿色上下文的情况。
下面的代码片段展示了如何使用这些 API。
// Assume cudaStream_t gc_stream  has already been created and a __global__ void cluster_kernel exists.

// Uncomment to support non portable cluster size, if possible
// CUDA_CHECK(cudaFuncSetAttribute(cluster_kernel, cudaFuncAttributeNonPortableClusterSizeAllowed, 1))

cudaLaunchConfig_t config = {0};
config.gridDim          = grid_dim; // has to be a multiple of cluster dim.
config.blockDim         = block_dim;
config.dynamicSmemBytes = expected_dynamic_shared_mem;

cudaLaunchAttribute attribute[1];
attribute[0].id = cudaLaunchAttributeClusterDimension;
attribute[0].val.clusterDim.x = 1;
attribute[0].val.clusterDim.y = 1;
attribute[0].val.clusterDim.z = 1;
config.attrs = attribute;
config.numAttrs = 1;

config.stream=gc_stream; // Need to pass the CUDA stream that will be used for that kernel

int max_potential_cluster_size = 0;
// the next call will ignore cluster dims in launch config
CUDA_CHECK(cudaOccupancyMaxPotentialClusterSize(&max_potential_cluster_size, cluster_kernel, &config));
std::cout << "max potential cluster size is " << max_potential_cluster_size << " for CUDA stream gc_stream" << std::endl;

// Could choose to update launch config's clusterDim with max_potential_cluster_size.
// Doing so would result in a successful cudaLaunchKernelEx call for the same kernel and launch config.

int num_clusters= 0;
CUDA_CHECK(cudaOccupancyMaxActiveClusters(&num_clusters, cluster_kernel, &config));
std::cout << "Potential max. active clusters count is " << num_clusters << std::endl;
验证绿色上下文的使用
除了通过实测观察绿色上下文资源配置对核函数执行时间的影响之外,用户还可以利用Nsight Systems或Nsight Compute CUDA 开发者工具,在一定程度上验证绿色上下文是否得到正确使用。
例如,在属于不同绿色上下文的 CUDA 流上启动的核函数,将显示在Nsight Systems报告的 CUDA 硬件时间线部分下不同的绿色上下文行中。Nsight Compute在其会话页面中提供绿色上下文资源概览,并在详细信息部分的启动统计信息下提供更新后的SM 数量。前者提供已配置资源的可视化位掩码。如果应用程序使用不同的绿色上下文,这一点尤其有用,因为用户可以确认不同 GC 之间的重叠情况是否符合预期(没有重叠,或者在 SM 被超额订阅时存在预期的非零重叠)。
图 48以一个示例描绘了这些资源,其中有两个绿色上下文,分别配置了 112 个和 16 个 SM,彼此之间没有 SM 重叠。所提供的视图可以帮助用户验证为每个绿色上下文配置的 SM 资源数量。它还有助于确认没有任何 SM 被超额订阅,因为没有任何方框在两个绿色上下文中都被标记为绿色(表示为该 GC 配置)。

图 48Nsight Compute 中的绿色上下文资源部分
图内文字中文对照
Green Context Resources- 绿色上下文资源
Overview of all Green Contexts with their respective resources included in the report.- 报告中包含的所有绿色上下文及其各自资源的概览。
Green Context ID- 绿色上下文 ID
Result IDs- 结果 ID
# TPCs- TPC 数量
Enabled TPCs- 已启用的 TPC
启动统计信息部分还显式列出了为该绿色上下文配置的 SM 数量,因此这些 SM 可供该核函数使用。请注意,这些是给定核函数在执行期间可以访问的 SM,而不是该核函数实际运行所用的 SM 数量。前面展示的资源概览也是如此。核函数实际使用的 SM 数量可能取决于多种因素,包括核函数本身(启动的几何配置等)、同时在 GPU 上运行的其他工作等。
4.6.6. 其他执行上下文 API
本节简要介绍一些其他绿色上下文 API。有关完整列表,请参阅 CUDA 运行时 API 的相关章节。
要使用 CUDA 事件进行同步,可以利用cudaError_t cudaExecutionCtxRecordEvent(cudaExecutionContext_t ctx, cudaEvent_t event)和cudaError_t cudaExecutionCtxWaitEvent(cudaExecutionCtxWaitEvent(cudaExecutionContext_t ctx, cudaEvent_t event) API。cudaExecutionCtxRecordEvent记录一个 CUDA 事件,捕获指定执行上下文在此调用时的所有工作/活动,而cudaExecutionCtxWaitEvent则使今后提交到该执行上下文的所有工作等待指定事件中捕获的工作。
如果执行上下文具有多个 CUDA 流,使用cudaExecutionCtxRecordEvent比cudaEventRecord更方便。若不使用此执行上下文 API 而要实现等效行为,则需要在该执行上下文的每个流上通过cudaEventRecord记录一个单独的 CUDA 事件,然后让依赖这些工作的工作分别等待所有这些事件。同样,如果需要该执行上下文的所有流等待某个事件完成,则cudaExecutionCtxWaitEvent比cudaStreamWaitEvent更方便。替代方法是为此执行上下文中的每个流分别调用cudaStreamWaitEvent。
要在 CPU 端进行阻塞同步,可以使用cudaError_t cudaExecutionCtxSynchronize(cudaExecutionContext_t ctx)。此调用将一直阻塞,直到指定的执行上下文完成其所有工作。如果指定的执行上下文不是通过cudaGreenCtxCreate创建的,而是通过cudaDeviceGetExecutionCtx获取的,因此是设备的主上下文,则调用该函数还将同步在同一设备上创建的所有绿色上下文。
要获取给定执行上下文所关联的设备,可以使用cudaExecutionCtxGetDevice。要获取给定执行上下文的唯一标识符,可以使用cudaExecutionCtxGetId。
最后,可以通过cudaError_t cudaExecutionCtxDestroy(cudaExecutionContext_t ctx) API 销毁显式创建的执行上下文。
4.6.7. 绿色上下文示例
本节说明绿色上下文如何使关键工作更早开始和完成。与第 4.6.1 节中使用的场景类似,该应用程序有两个核函数,将在两个不同的非阻塞 CUDA 流上运行。从 CPU 端来看,时间线如下。首先在 CUDA 流strm1上启动一个长时间运行的核函数(delay_kernel_us),它在整个 GPU 上需要多个波次才能完成。然后,在短暂等待(短于该核函数的持续时间)之后,在流strm2上启动一个持续时间较短但很关键的核函数(critical_kernel)。测量这两个核函数的 GPU 持续时间以及从 CPU 启动到完成的时间。
使用一个延迟核函数来代替长时间运行的核函数,其中每个线程块运行固定的微秒数,并且线程块数量超过 GPU 可用的 SM 数量。
起初不使用绿色上下文,但关键核函数会在优先级高于长时间运行的核函数所用流的 CUDA 流上启动。由于其流具有较高优先级,长时间运行的核函数的某些线程块一旦完成,关键核函数就可以开始执行。但是,它仍然需要等待一些可能长时间运行的线程块完成,这将推迟其开始执行的时间。
图 49在 Nsight Systems 报告中展示了这一场景。长时间运行的核函数在流 13 上启动,而持续时间较短但很关键的核函数在具有更高流优先级的流 14 上启动。如图中突出显示的那样,关键核函数要等待 0.9 毫秒(在本例中)才能开始执行。如果这两个流具有相同的优先级,关键核函数的执行时间就会晚得多。
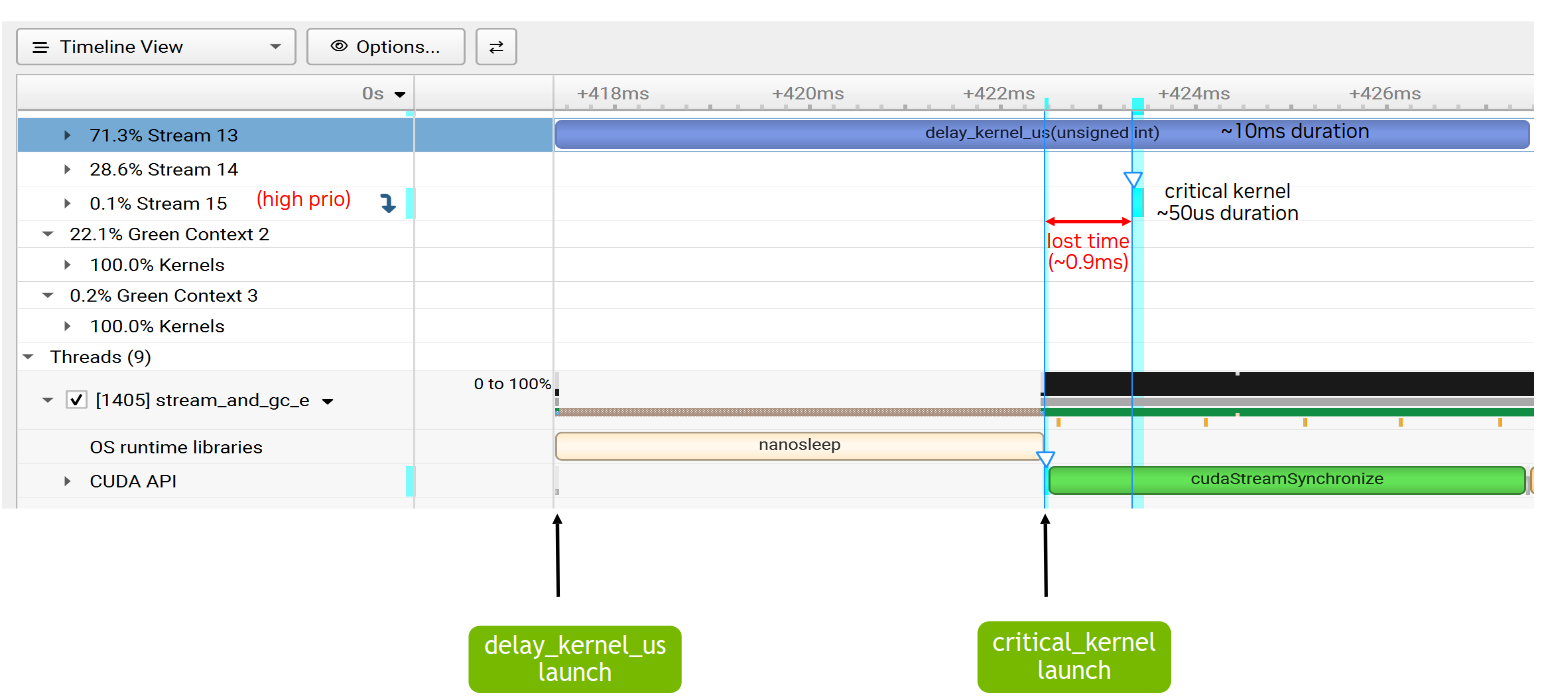
图 49不使用绿色上下文时的 Nsight Systems 时间线
图内文字中文对照
Timeline View- 时间线视图
Options...- 选项
71.3% Stream 13- 71.3% 流 13
28.6% Stream 14- 28.6% 流 14
0.1% Stream 15- 0.1% 流 15
(high prio)- (高优先级)
22.1% Green Context 2- 22.1% 绿色上下文 2
0.2% Green Context 3- 0.2% 绿色上下文 3
100.0% Kernels- 100.0% 核函数
Threads (9)- 线程(9)
OS runtime libraries- 操作系统运行时库
~10ms duration- 持续时间约 10 毫秒
critical kernel ~50us duration- 关键核函数持续时间约 50 微秒
lost time (~0.9ms)- 损失的时间(约 0.9 毫秒)
delay_kernel_us launch- 启动 delay_kernel_us
critical_kernel launch- 启动 critical_kernel
为了利用绿色上下文功能,创建了两个绿色上下文,并为每个上下文配置了一组彼此独立、互不重叠的 SM。在本例中,为了便于说明,对具有 132 个 SM 的 H100 采用的具体 SM 拆分方式是:为关键核函数(绿色上下文 3)配置 16 个 SM,为长时间运行的核函数(绿色上下文 2)配置 112 个 SM。如图 50所示,关键核函数现在几乎可以立即开始,因为有一些 SM 只能由绿色上下文 3 使用。
与单独运行时的持续时间相比,短核函数的持续时间可能会增加,因为它现在可使用的 SM 数量受到了限制。长时间运行的核函数也是如此,它无法再使用 GPU 的所有 SM,而是受到其绿色上下文所配置资源的约束。不过,关键结果在于,与之前相比,关键核函数的工作现在可以显著更早地开始和完成。这是在没有其他任何限制的前提下而言的,因为如前所述,无法保证并行执行。
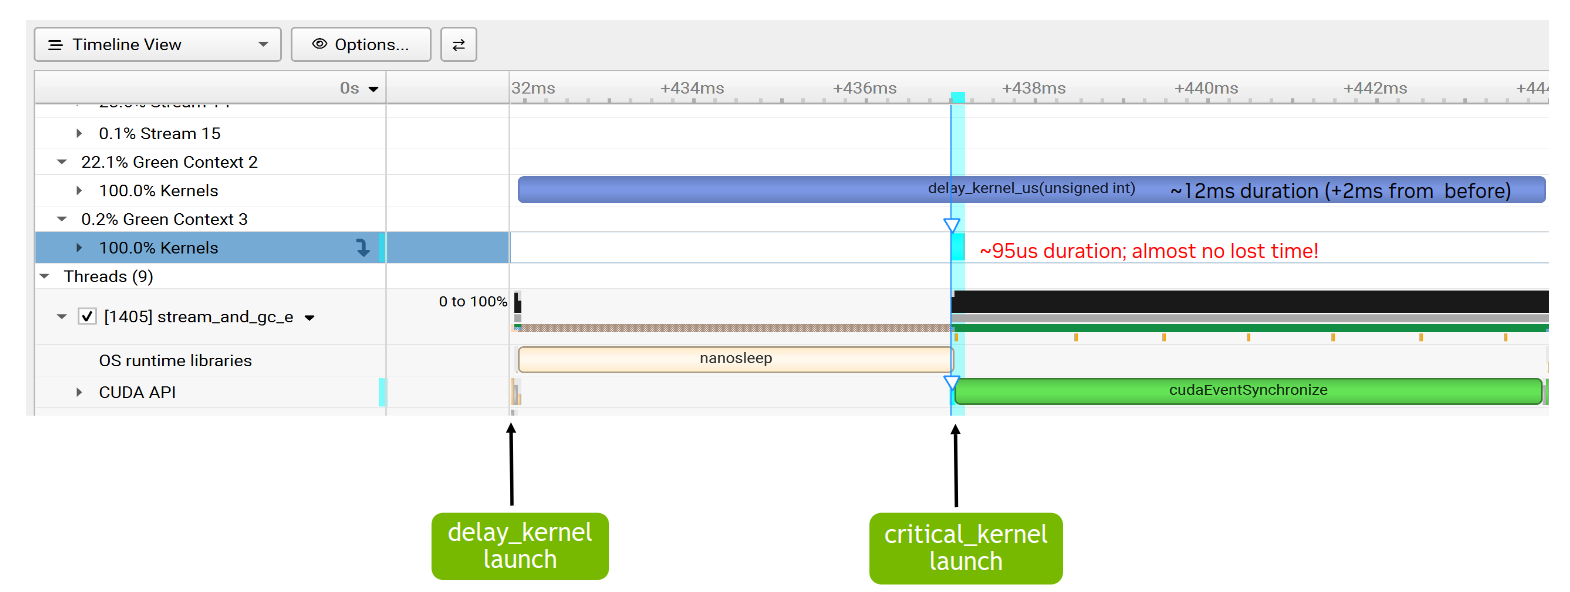
图 50使用绿色上下文时的 Nsight Systems 时间线
图内文字中文对照
Timeline View- 时间线视图
Options...- 选项
0.1% Stream 15- 0.1% 流 15
22.1% Green Context 2- 22.1% 绿色上下文 2
0.2% Green Context 3- 0.2% 绿色上下文 3
100.0% Kernels- 100.0% 核函数
Threads (9)- 线程(9)
OS runtime libraries- 操作系统运行时库
~12ms duration (+2ms from before)- 持续时间约 12 毫秒(比之前增加 2 毫秒)
~95us duration; almost no lost time!- 持续时间约 95 微秒;几乎没有时间损失!
delay_kernel launch- 启动 delay_kernel
critical_kernel launch- 启动 critical_kernel
在所有情况下,都应在实验之后,根据具体情况决定确切的 SM 拆分方式。