5.5. 浮点计算
5.5.1. 浮点数简介
自 1985 年二进制浮点算术IEEE-754 标准获采纳以来,几乎所有主流计算系统,包括 NVIDIA 的 CUDA 架构,都已实现该标准。IEEE-754 标准规定了应如何对浮点算术的结果进行近似。
要获得准确的结果,并在满足所需精度的同时实现最高性能,考虑浮点行为的多个方面很重要。这在运算由不同类型硬件执行的异构计算环境中尤为重要。
以下各节回顾浮点计算的基本属性,并介绍融合乘加(FMA)运算和点积。这些示例说明了不同的实现选择如何影响准确性。
5.5.1.1. 浮点格式
浮点格式和功能由IEEE-754 标准定义。
该标准规定,二进制浮点数据必须编码在三个字段中:
符号:用一位表示正数或负数。
指数:对加上数值偏置后的以 2 为底的指数进行编码。
有效数(也称为尾数或小数部分):对该数的小数值进行编码。

图内文字中文对照
Sign- 符号
Exponent- 指数
Mantissa- 尾数
最新的 IEEE-754 标准定义了以下二进制格式的编码和属性:
16 位,也称为半精度,对应于 CUDA 中的
__half数据类型。32 位,也称为单精度,对应于 C、C++ 和 CUDA 中的
float数据类型。64 位,也称为双精度,对应于 C、C++ 和 CUDA 中的
double数据类型。128 位,也称为四倍精度,对应于 CUDA 中的
__float128或_Float128数据类型。
这些类型具有以下位长:
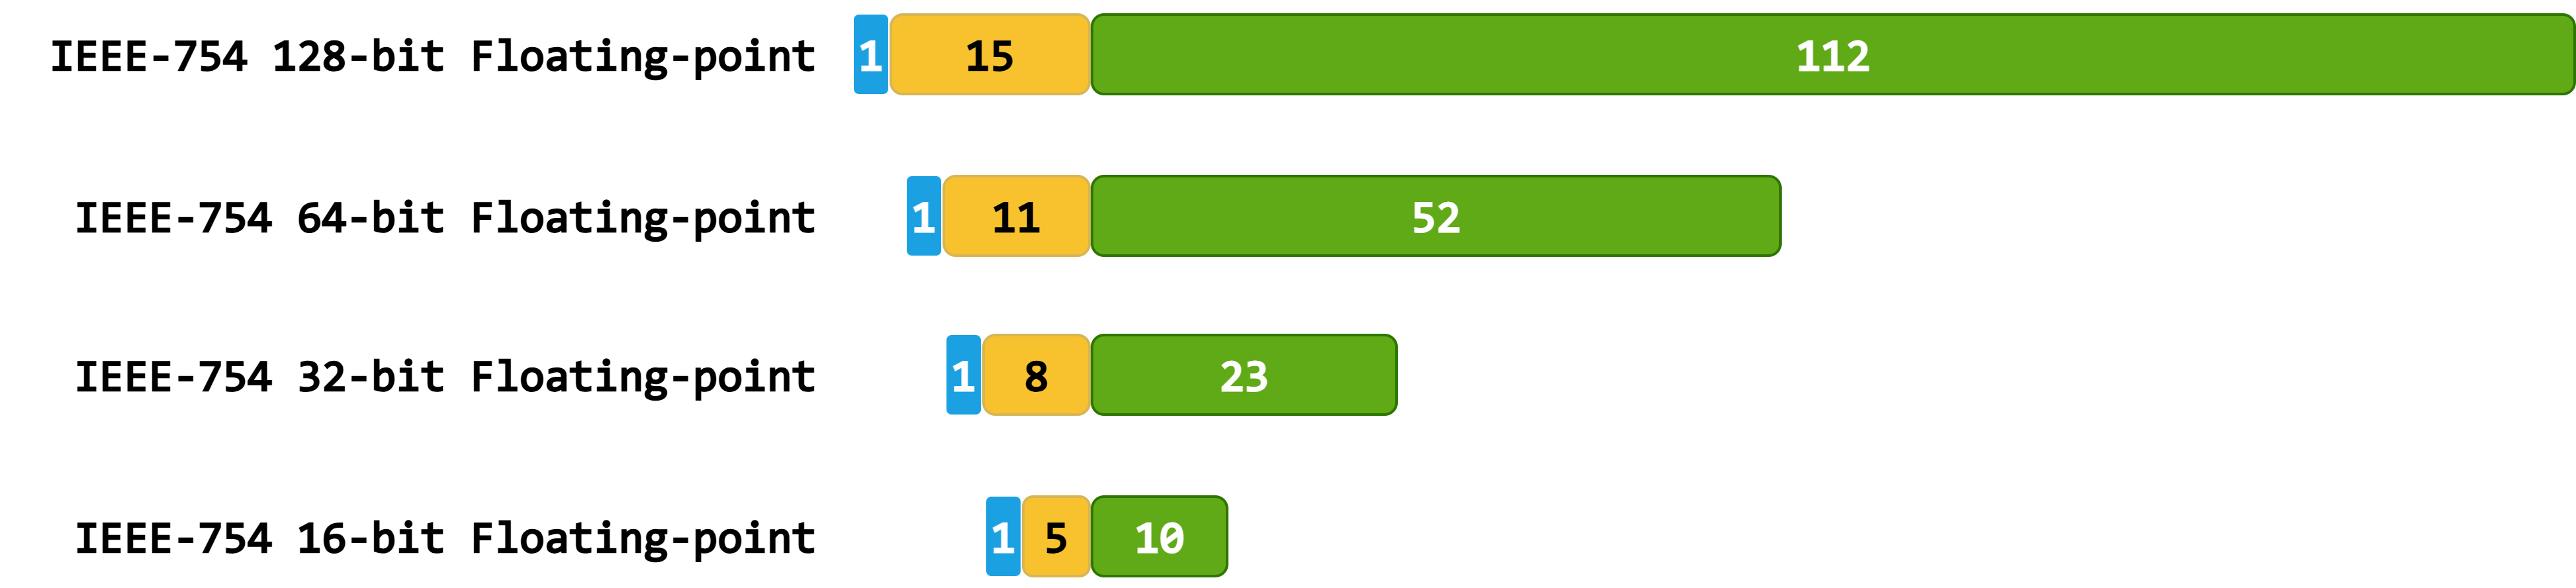
图内文字中文对照
IEEE-754 128-bit Floating-point- IEEE-754 128 位浮点数
IEEE-754 64-bit Floating-point- IEEE-754 64 位浮点数
IEEE-754 32-bit Floating-point- IEEE-754 32 位浮点数
IEEE-754 16-bit Floating-point- IEEE-754 16 位浮点数
正规值的浮点编码所对应的数值按如下方式计算:
对于次正规值,公式修改为:
float其值为7 + 127 = 134 = 10000110,对于double其值为7 + 1023 = 1030 = 10000000110。尾数0.5 = 2^-1用首位为1的二进制值表示。下图展示了的单精度和双精度二进制编码: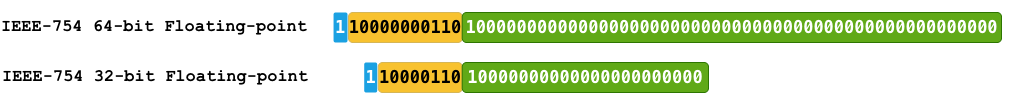
图内文字中文对照
IEEE-754 64-bit Floating-point- IEEE-754 64 位浮点数
IEEE-754 32-bit Floating-point- IEEE-754 32 位浮点数
由于小数字段使用的位数有限,并非所有实数都能被精确表示。例如,分数的数学值的二进制表示为0.10101010...,其二进制小数点后有无限多位。因此,必须先对进行舍入,才能将其表示为精度有限的浮点数。IEEE-754 规定了舍入规则和模式。最常用的模式是舍入到最近值,中间值取偶数,简称舍入到最近值。
5.5.1.2. 正规值与次正规值
任何指数字段既不全为零也不全为一的浮点值都称为正规值。
浮点值的一个重要特征是,最小的可表示正正规数FLT_MIN与零之间存在很大的间隔。这个间隔远大于FLT_MIN与第二小的正规数之间的间隔。
为解决此问题,引入了浮点次正规数,也称为非正规数。次正规浮点值的表示方式是,将指数的所有位设为零,并将有效数中的至少一位设为一。次正规数是 IEEE-754 浮点标准的必需组成部分。
次正规数允许精度逐渐损失,而不是突然向零舍入。但是,次正规数的计算开销更高。因此,不要求严格准确性的应用程序可以选择避免使用次正规数,以提高性能。nvcc编译器允许通过设置-ftz=true选项(刷零)来禁用次正规数,--use_fast_math也包含此选项。
下图以简化的可视化方式展示了单精度下最小正规值和次正规值的编码:
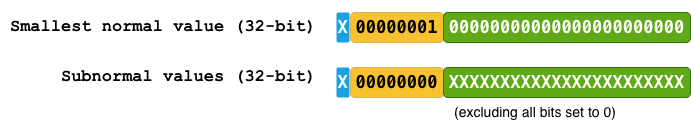
图内文字中文对照
Smallest normal value (32-bit)- 最小正规数值(32 位)
Subnormal values (32-bit)- 次正规数值(32 位)
(excluding all bits set to 0)- (不包括所有位均为 0 的情况)
其中,X同时表示0和1。
5.5.1.3. 特殊值
IEEE-754 标准为浮点数定义了三种特殊值:
零:
数学意义上的零。
请注意,浮点零有两种可能的表示形式:
+0和-0。这与整数零的表示形式不同。+0 == -0的求值结果为true。零的编码将指数和有效数中的所有位都设置为
0。
无穷大:
浮点数遵循饱和算术的行为,在这种算术中,溢出可表示范围的运算会产生
+Infinity或-Infinity。无穷大的编码将指数中的所有位都设置为
1,将有效数中的所有位都设置为0。无穷大值恰好有两种编码。涉及无穷大和有限非零值的算术运算通常会产生无穷大。
Inf * 0.0、Inf - Inf、Inf / Inf和0.0 / 0.0等不定式会产生 NaN。
非数(NaN):
NaN 是一个特殊符号,表示未定义或不可表示的值。常见示例有
0.0 / 0.0、sqrt(-1.0)或+Inf - Inf。NaN 的编码将指数中的所有位都设置为
1,有效数则可以采用除所有位均为 0 以外的任何位模式。共有种可能的编码。任何涉及 NaN 的算术运算都会产生 NaN。
任何涉及 NaN 的有序比较(
<、<=、>、>=、==)都会产生false,包括NaN == NaN(不具有自反性)。无序比较NaN != NaN返回true。NaN 有两种形式:
静默 NaN
qNaN用于传播由无效运算或无效值产生的错误。无效的算术运算通常会产生静默 NaN。其编码将有效数的最高有效位设置为1。信号 NaN
sNaN旨在引发无效运算异常。信号 NaN 通常是显式创建的。其编码将有效数的最高有效位设置为0。静默 NaN 和信号 NaN 的确切位模式由实现定义。CUDA 提供cuda::std::numeric_limits<T>::quiet_NaN和cuda::std::numeric_limits<T>::signaling_NaN常量来获取这些特殊值。
下图以简化的可视化方式展示了特殊值的编码:
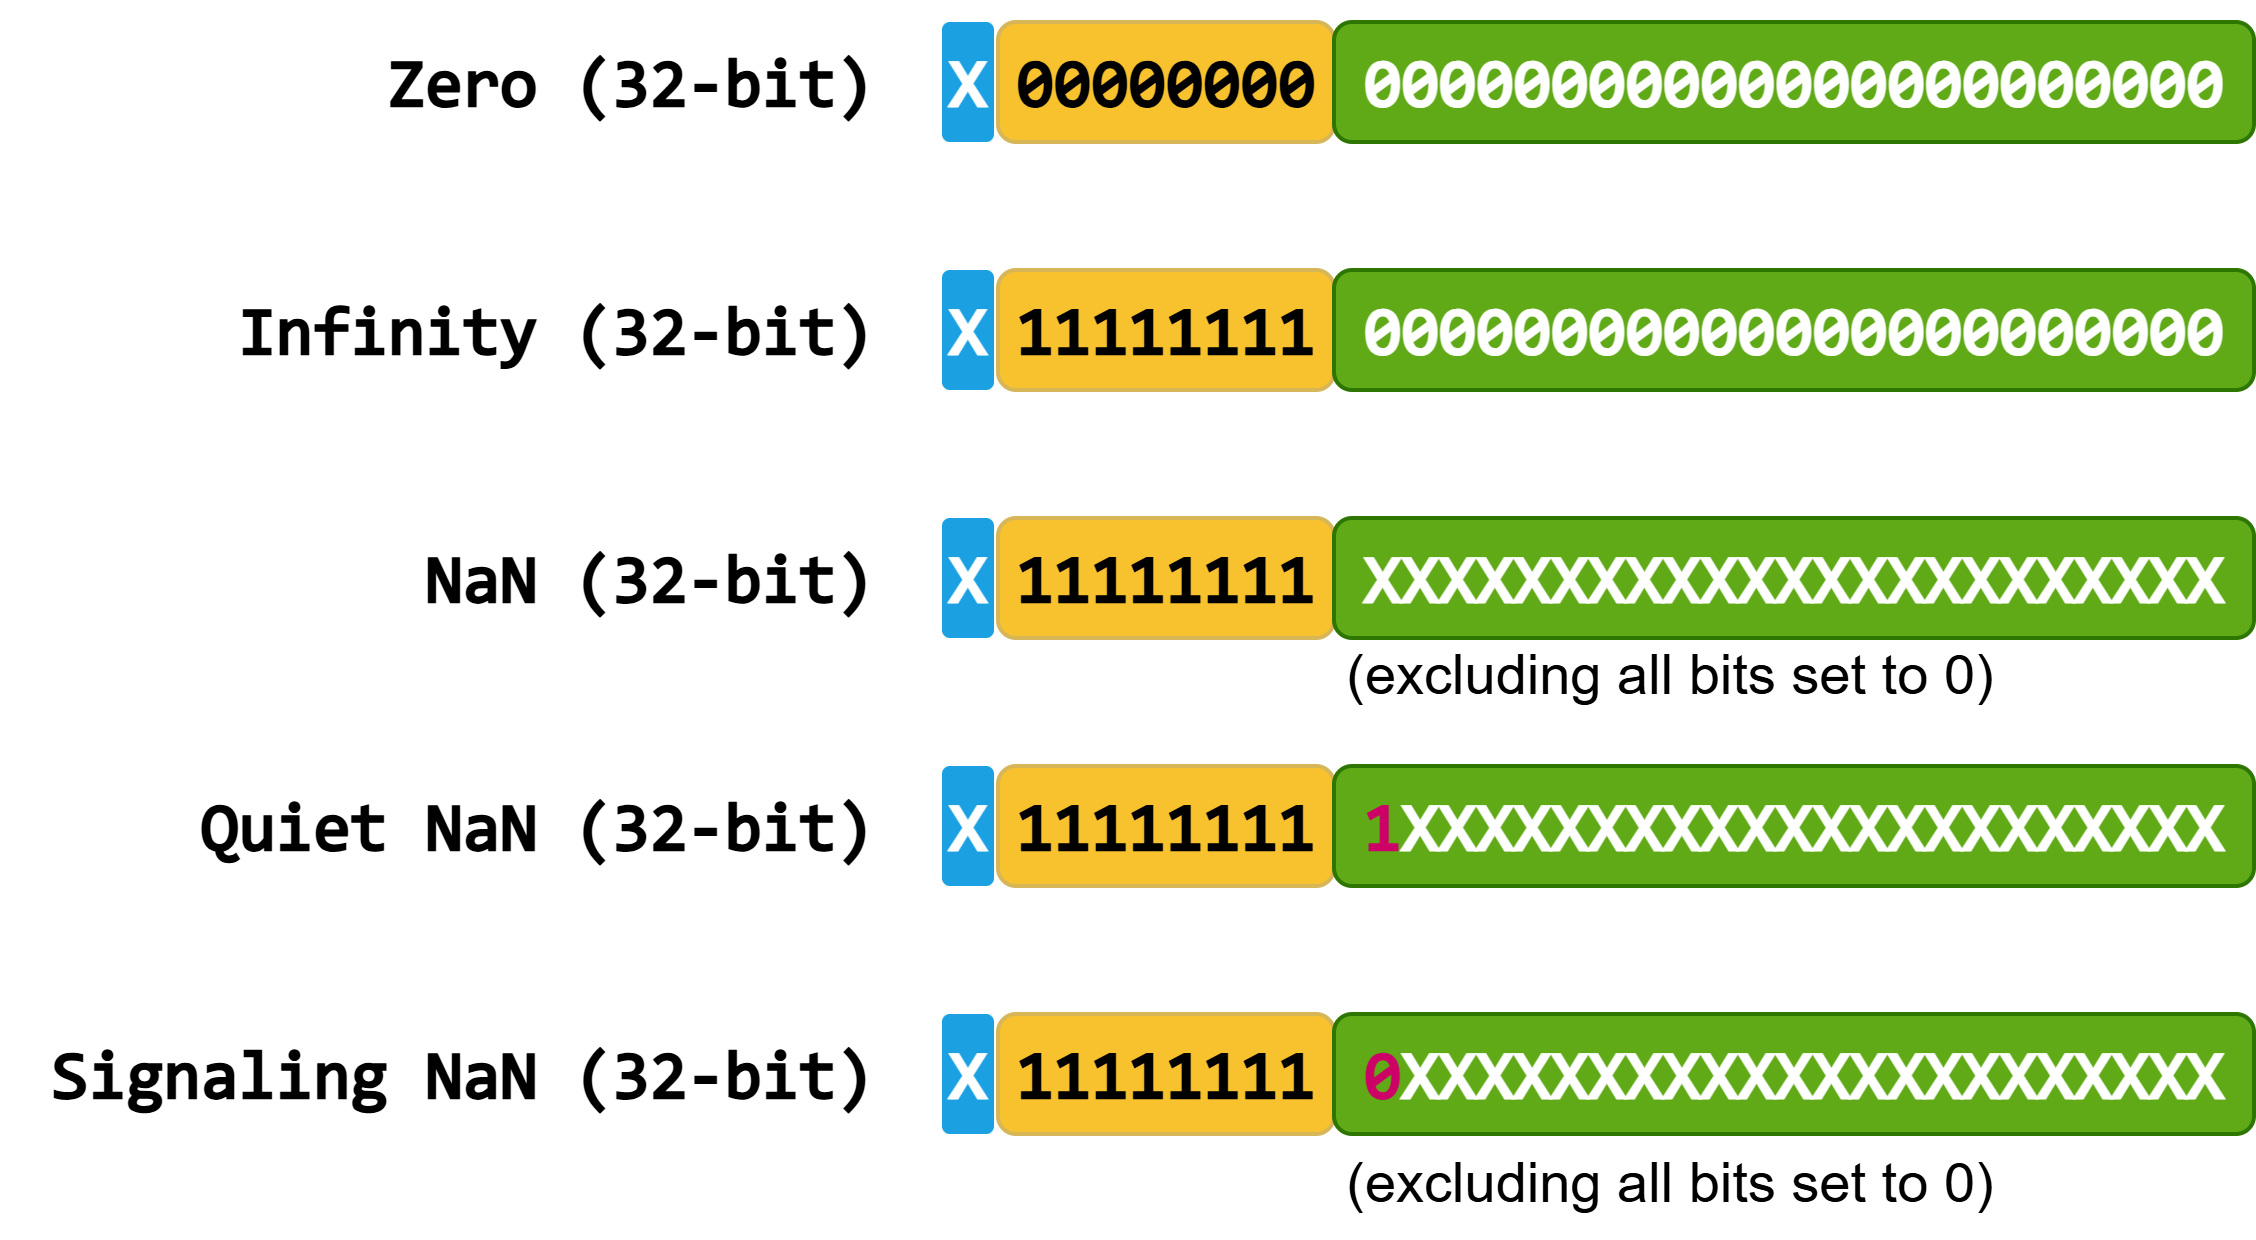
图内文字中文对照
Zero (32-bit)- 零(32 位)
Infinity (32-bit)- 无穷大(32 位)
NaN (32-bit)- 非数值(32 位)
Quiet NaN (32-bit)- 静默非数值(32 位)
Signaling NaN (32-bit)- 信号非数值(32 位)
(excluding all bits set to 0)- (不包括所有位均为 0 的情况)
其中,X同时表示0和1。
5.5.1.4. 结合律
需要注意的是,由于浮点算术的精度有限,数学算术的规则和性质并不直接适用于浮点算术。下面的示例展示了单精度值A、B和C,以及使用不同结合方式计算它们的和所得的精确数学值。
从数学上讲,等于。
令表示对进行一次舍入。按照 IEEE-754,在舍入到最近值模式下使用单精度浮点算术进行相同的计算,可得:
上面还计算了精确的数学结果以供参考。按照 IEEE-754 计算的结果与精确的数学结果不同。此外,和与所对应的结果也互不相同。在此情况下,比更接近正确的数学结果。
这个示例表明,即使所有基本运算都符合 IEEE-754,看似相同的计算也可能产生不同的结果。
5.5.1.5. 融合乘加(FMA)
融合乘加(FMA)运算只需一次舍入即可计算出结果。如果不使用 FMA,计算结果将需要两次舍入:一次用于乘法,一次用于加法。由于 FMA 只进行一次舍入,因此它产生的结果更加准确。
融合乘加运算对 NaN 传播的影响可能与两个独立运算不同。但是,FMA 对 NaN 的处理并非在所有目标平台上都完全相同。当存在多个 NaN 操作数时,不同的实现可能优先选择静默 NaN,也可能传播某个操作数的载荷。此外,当存在多个 NaN 操作数时,IEEE-754 并未严格要求确定性的载荷选择顺序。NaN 也可能出现在中间计算中,例如或,从而产生由实现定义的 NaN 载荷。
为清楚起见,首先考虑一个使用十进制算术的示例,以说明 FMA 运算的工作方式。我们将使用总共五位数的精度来计算,其中小数点后有四位数。
对于,正确的数学结果为。仅使用小数点后四位数时,最接近的数为。
融合乘加运算仅通过一次舍入即可得到正确结果。
另一种方法是分别计算乘法和加法步骤。转化为。最终结果为。
分别对乘法和加法进行舍入,得到的结果偏差为。相应的 FMA 计算误差仅为,其结果最接近正确的数学答案。结果汇总如下:
下面是另一个使用二进制单精度值的示例:
分别计算乘法和加法会导致所有精度位丢失,得到。
相比之下,计算 FMA 可得到与数学值相等的结果。
融合乘加有助于防止减法消去过程中的精度损失。当大小相近、符号相反的量相加时,就会发生减法消去。在这种情况下,许多高位会相互抵消,导致有意义的位数减少。融合乘加在乘法期间计算双倍位宽的乘积。因此,即使在加法期间发生减法消去,乘积中仍有足够的有效位来产生精确的结果。
CUDA 中的融合乘加支持:
CUDA 通过多种方式为float和double两种数据类型提供融合乘加运算:
使用标志
-fmad=true或--use_fast_math编译时的x * y + z。C 标准库函数
fma(x, y, z)和fmaf(x, y, z)。CUDA 数学内建函数
__fmaf_[rd, rn, ru, rz]、__fmaf_ieee_[rd, rn, ru, rz]和__fma_[rd, rn, ru, rz]。CUDA C++ 标准库函数
cuda::std::fma(x, y, z)和cuda::std::fmaf(x, y, z)。
主机平台上的融合乘加支持:
是否使用融合运算取决于该运算在平台上是否可用以及代码的编译方式。在比较 CPU 和 GPU 的结果时,了解主机平台对融合乘加的支持非常重要。
编译器标志和融合乘加硬件支持:
GCC和Clang使用
-mfma,NVC++使用-Mfma,Microsoft Visual Studio使用/fp:contract。具有 AVX2 ISA 的 x86 平台,例如,使用 GCC 或 Clang 并指定
-mavx2标志编译的代码,以及使用 Microsoft Visual Studio 并指定/arch:AVX2编译的代码。具有 Advanced SIMD(Neon)ISA 的 Arm64(AArch64)平台。
C 标准库函数
fma(x, y, z)和fmaf(x, y, z)。C++ 标准库函数
std::fma(x, y, z)和std::fmaf(x, y, z)。CUDA C++ 标准库函数
cuda::std::fma(x, y, z)和cuda::std::fmaf(x, y, z)。
5.5.1.6. 点积示例
考虑求两个短向量和的点积的问题,这两个向量都含有四个元素。
虽然这个运算很容易用数学形式写出,但在软件中实现它有多种选择,可能导致略有不同的结果。这里介绍的所有策略所使用的运算都完全符合 IEEE-754。
示例算法 1:计算点积的最简单方法是对乘积进行顺序求和,并保持乘法和加法分离。
最终结果可以表示为。
示例算法 2:使用融合乘加顺序计算点积。
最终结果可以表示为。
示例算法 3:使用分治策略计算点积。首先,分别求出向量前半部分和后半部分的点积。然后,使用加法合并这些结果。该算法称为“并行算法”,因为这两个子问题彼此独立,可以并行计算。但是,该算法并不要求采用并行实现;它可以用单个线程实现。
最终结果可以表示为。
5.5.1.7. 舍入
IEEE-754 标准要求支持若干运算。这些运算包括加法、减法、乘法、除法、平方根、融合乘加、求余数等算术运算,以及转换、缩放、符号和比较运算。对于给定的格式和舍入模式,可以保证这些运算的结果在该标准的所有实现中都一致。
舍入模式
IEEE-754 标准定义了四种舍入模式:舍入到最近值、向正方向舍入、向负方向舍入和向零舍入。CUDA 支持全部四种模式。默认情况下,运算使用舍入到最近值。可以使用数学内建函数为单个运算选择其他舍入模式。
舍入模式 |
含义 |
|---|---|
|
舍入到最近值,距离相等时取偶数 |
|
向零舍入 |
|
向舍入 |
|
向舍入 |
5.5.1.8. 关于主机/设备计算准确性的说明
浮点计算结果的准确性受多种因素影响。本节总结了在浮点计算中获得可靠结果的重要注意事项。其中一些方面已在前面的章节中作了更详细的介绍。
在比较 CPU 和 GPU 的结果时,这些方面也很重要。必须谨慎解释主机执行与设备执行之间的差异。存在差异并不一定意味着 GPU 的结果不正确,或 GPU 存在问题。
结合律:
有限精度的浮点加法和乘法不满足结合律,因为它们经常产生无法用目标格式直接表示的数学值,因此需要舍入。这些运算的求值顺序会影响舍入误差的累积方式,并且可能显著改变最终结果。
融合乘加:
融合乘加在单次运算中计算,从而获得更高的准确性和更短的执行时间。是否使用它会影响最终结果的准确性。融合乘加依赖硬件支持,可以通过调用相关函数显式启用,也可以通过编译器优化标志隐式启用。
精度:
提高浮点精度可能提高结果的准确性。更高的精度可以减少有效数字的损失,并能够表示更大范围的值。但是,更高精度的类型吞吐量更低,并且会消耗更多寄存器。此外,使用这些类型显式存储输入和输出会增加内存使用量和数据移动量。
编译器标志和优化:
所有主流编译器都提供了多种优化标志,用于控制浮点运算的行为。
GCC(
-O3)、Clang(-O3)、nvcc(-O3)和 Microsoft Visual Studio(/O2)的最高优化级别不会影响浮点语义。但是,内联、循环展开、向量化和公共子表达式消除可能会影响结果。NVC++ 编译器还需要使用标志-Kieee -Mnofma才能获得符合 IEEE-754 的语义。有关影响浮点行为的选项的详细信息,请参阅GCC、Clang、Microsoft Visual Studio 编译器、nvc++和Arm C/C++ 编译器的文档。
另请参阅
nvcc用户手册,了解专门影响 CUDA 设备代码中浮点行为的编译器标志的详细说明:-ftz、-prec-div、-prec-sqrt、-fmad、--use_fast_math。除了这些浮点选项之外,在用户程序的具体情境中验证其他编译器优化的影响也很重要。建议用户通过广泛的测试来验证结果的正确性,并比较启用优化时获得的结果与禁用所有设备代码优化时获得的结果;另请参阅-G编译器标志。
库实现:
在 IEEE-754 标准之外定义的函数不能保证正确舍入,并且依赖由实现定义的行为。因此,结果可能在不同平台之间存在差异,包括主机、设备以及不同设备架构之间。
确定性结果:
充分利用 CUDA 库:
CUDA 数学库、C 标准库数学函数和C++ 标准库数学函数旨在提高开发者实现常用功能时的生产力,特别是浮点数学和数值计算密集型例程。这些功能提供了一致的高级接口,经过优化,并针对各种平台和边界情况进行了广泛测试。建议用户充分利用这些库,避免繁琐的手工重新实现。
5.5.2. 浮点数据类型
CUDA 支持 Bfloat16、半精度、单精度、双精度和四倍精度浮点数据类型。下表汇总了 CUDA 支持的浮点数据类型及其要求。
精度/名称 |
数据类型 |
IEEE-754 |
头文件/内置 |
要求 |
|---|---|---|---|---|
Bfloat16 |
|
❌ |
|
计算能力 8.0 或更高。 |
半精度 |
|
✅ |
|
|
单精度 |
|
✅ |
内置 |
|
双精度 |
|
✅ |
内置 |
|
四倍精度 |
|
✅ |
内置 数学函数使用 |
主机编译器支持且计算能力为 10.0 或更高。 C 或 C++ 中的写法分别为 |
CUDA 还支持TensorFloat-32(TF32)、微缩放(MX)浮点类型以及其他较低精度数值格式,它们并非用于通用计算,而是用于涉及张量核心的专门用途。其中包括 4 位、6 位和 8 位浮点类型。更多详细信息,请参阅CUDA Math API。
下图给出了所支持浮点数据类型的尾数和指数大小。
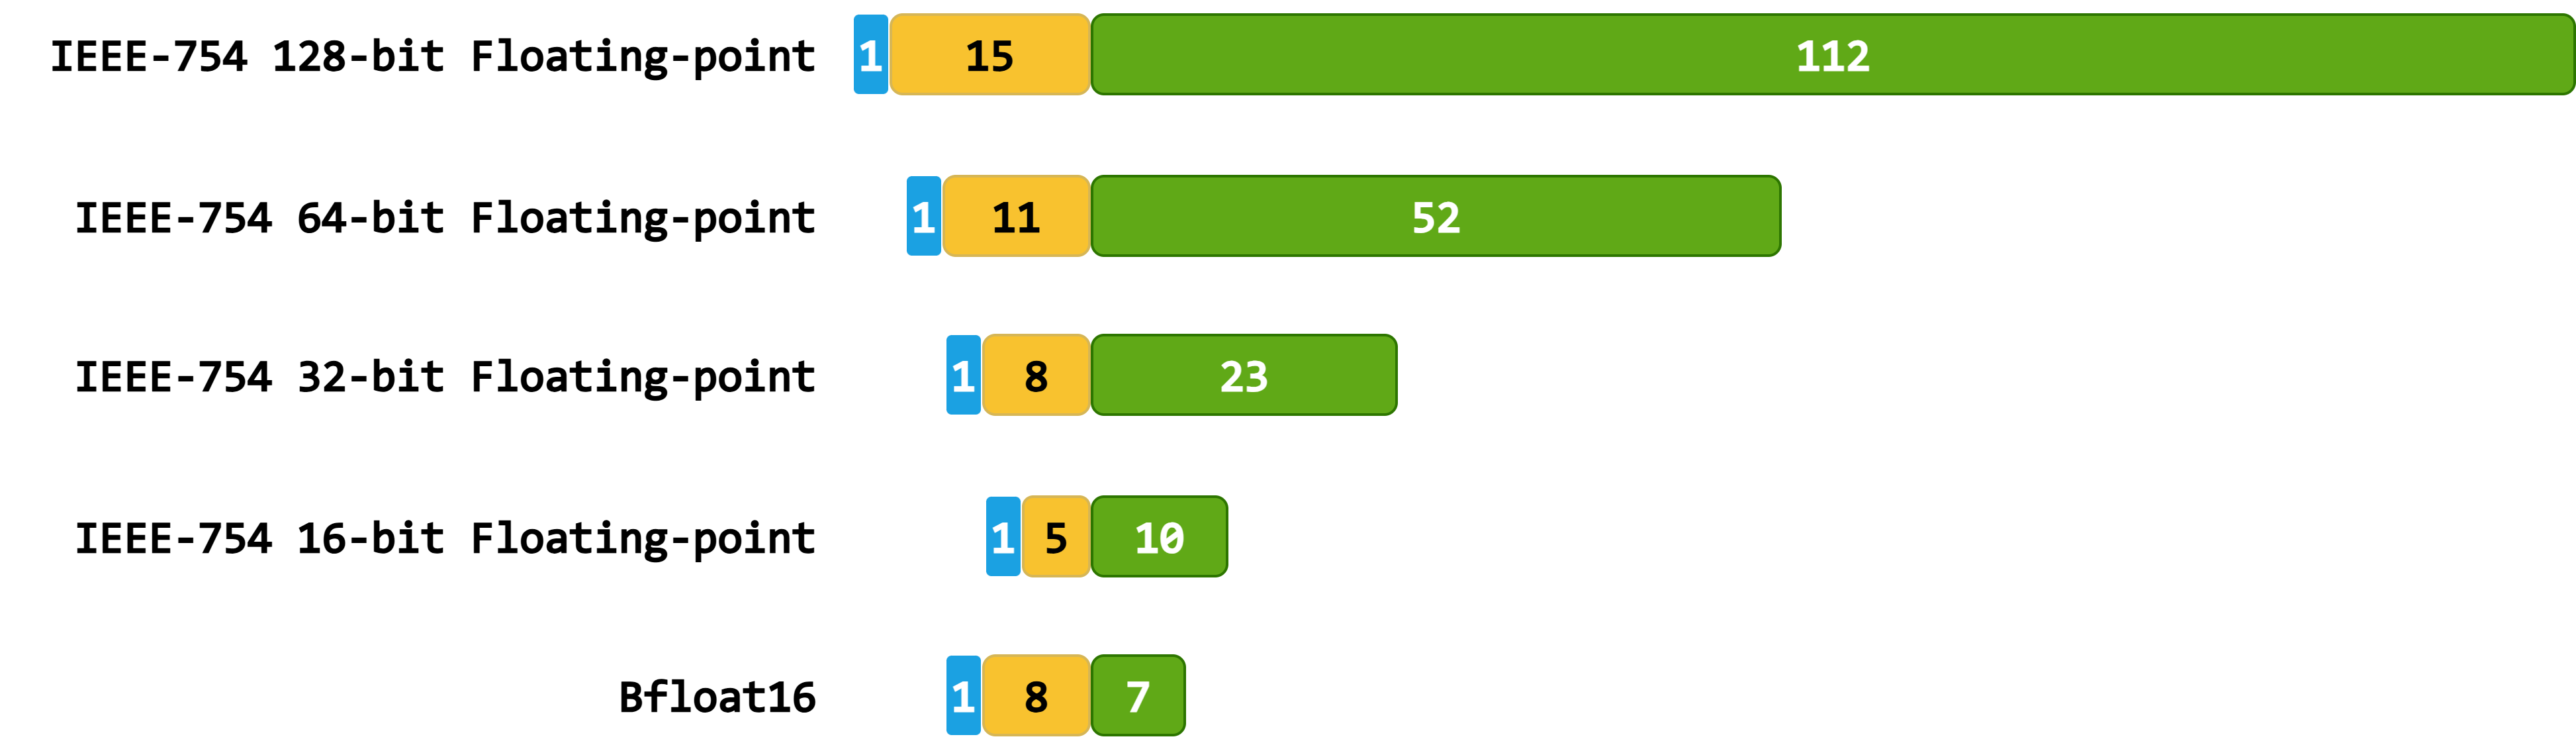
图内文字中文对照
IEEE-754 128-bit Floating-point- IEEE-754 128 位浮点数
IEEE-754 64-bit Floating-point- IEEE-754 64 位浮点数
IEEE-754 32-bit Floating-point- IEEE-754 32 位浮点数
IEEE-754 16-bit Floating-point- IEEE-754 16 位浮点数
下表给出了所支持浮点数据类型的范围。
精度/名称 |
最大值 |
最小正值 |
最小正非正规数 |
机器精度 |
||
|---|---|---|---|---|---|---|
Bfloat16 |
||||||
半精度 |
||||||
单精度 |
||||||
双精度 |
||||||
四倍精度 |
||||||
提示
CUDA C++ Standard Library在<cuda/std/limits>头文件中提供了cuda::std::numeric_limits,用于查询所支持浮点类型的属性和范围,包括微缩放格式(MX)。有关可查询属性的列表,请参阅C++ 参考。
复数支持:
CUDA C++ Standard Library通过
<cuda/std/complex>头文件中的cuda::std::complex类型支持复数。更多详细信息,另请参阅libcu++ 文档。CUDA 还通过
cuComplex.h头文件中的cuComplex和cuDoubleComplex类型提供对复数的基本支持。
5.5.3. CUDA 与 IEEE-754 的符合性
所有 GPU 设备都遵循IEEE 754-2019二进制浮点算术标准,但存在以下限制:
没有可动态配置的舍入模式;不过,大多数运算支持多种固定的 IEEE 舍入模式,可通过特定命名的设备内建函数进行选择。
没有检测浮点异常的机制,因此所有运算的行为都如同 IEEE-754 异常始终被屏蔽一样。如果发生异常事件,则给出 IEEE-754 定义的默认屏蔽响应。因此,尽管支持发信号 NaN
SNaN编码,但它们不会发信号,而是作为静默异常处理。浮点运算可能改变输入 NaN 载荷的位模式。绝对值和取负等运算也可能不符合 IEEE 754 的要求,这可能导致 NaN 的符号以实现定义的方式更新。
为最大限度提高结果的可移植性,建议用户使用nvcc编译器浮点选项的默认设置:-ftz=false、-prec-div=true和-prec-sqrt=true,并且不使用--use_fast_math选项。注意,默认情况下允许浮点表达式的重新结合和收缩,与--fmad=true选项类似。有关这些编译标志的详细说明,另请参阅nvcc用户手册。
当舍入为整数后的值超出目标整数格式的范围时,IEEE-754 和 C/C++ 语言标准都没有明确规定浮点值到整数值的转换。GPU 设备将值钳位到范围内的行为在PTX ISA 转换指令一节中进行了说明。不过,如果超出范围的转换不是直接通过 PTX 指令调用的,编译器优化可能会利用未指定行为条款,从而导致未定义行为,并使 CUDA 程序无效。CUDA Math 文档针对各个函数/内建函数向用户发出警告。例如,请考虑__double2int_rz()指令。这可能与主机编译器和库实现的行为不同。
原子函数对非正规数的行为:
无论编译器标志-ftz如何设置,原子运算对于浮点非正规数都具有以下行为:
全局内存上的原子单精度浮点加法始终在冲零模式下运行,即行为等同于 PTX
add.rn.ftz.f32语义。共享内存上的原子单精度浮点加法始终在支持非正规数的情况下运行,即行为等同于 PTX
add.rn.f32语义。
5.5.4. CUDA 与 C/C++ 的符合性
浮点异常:
与主机实现不同,设备代码中支持的数学运算符和函数既不设置全局errno变量,也不报告浮点异常来指示错误。因此,如果需要错误诊断机制,用户应为这些函数实现额外的输入和输出筛查。
浮点运算中的未定义行为:
数学运算中出现未定义行为的常见情形包括:
传递给数学运算符和函数的参数无效:
使用未初始化的浮点变量。
在浮点变量的生存期之外使用该变量。
有符号整数溢出。
解引用无效指针。
浮点特有的未定义行为:
将浮点值转换为无法表示结果的整数类型属于未定义行为。这也包括 NaN 和无穷大。
用户有责任确保 CUDA 程序的有效性。无效参数可能导致未定义行为,并受到编译器优化的影响。
与整数除以零不同,浮点数除以零不是未定义行为,也不受编译器优化的影响;它属于特定于实现的行为。包括 CUDA 在内,符合IEC-60559(IEEE-754)的 C++ 实现会产生无穷大。注意,无效的浮点运算会产生 NaN,不应将其误解为未定义行为。例如,零除以零以及无穷大除以无穷大。
浮点字面量的可移植性:
C 和 C++ 都允许使用十进制或十六进制记数法表示浮点值。C99和C++17支持十六进制浮点字面量,它以科学记数法表示一个能够用二进制精确表达的实数值。不过,这并不能保证该字面量将映射到目标变量中存储的实际值(请参阅下一段)。相反,十进制浮点字面量可能表示一个无法用二进制表达的数值。
根据C++ 标准规则,十六进制和十进制浮点字面量会舍入为最近的可表示值,该值可能较大,也可能较小,具体以实现定义的方式选择。主机与设备的这种舍入行为可能不同。
float f1 = 0.5f;    // 0.5, '0.5f' is a decimal floating-point literal
float f2 = 0x1p-1f; // 0.5, '0x1p-1f' is a hexadecimal floating-point literal
float f3 = 0.1f;
// f1, f2 are represented as 0 01111110 00000000000000000000000
// f3     is represented as  0 01111011 10011001100110011001101
同一浮点表达式的运行时求值和编译时求值存在以下可移植性问题:
浮点表达式的运行时求值可能受到所选舍入模式、浮点收缩(FMA)和重新结合编译器设置,以及浮点异常的影响。注意,CUDA 不支持浮点异常,并且舍入模式默认设为舍入到最近值,中间值舍入到偶数。可以使用内建函数选择其他舍入模式。
编译器可能对常量表达式使用更高精度的内部表示。
编译器可能执行常量折叠、常量传播和公共子表达式消除等优化,从而导致不同的最终值或比较结果。
C 标准数学库说明:
常用数学函数的主机实现以特定于平台的方式映射到C 标准数学库函数。这些函数由主机编译器和相应的主机libm(如果可用)提供。
主机编译器未提供的函数在
crt/math_functions.h头文件中实现。例如,erfinv()就在其中实现。较不常用的函数,例如
rhypot()和cyl_bessel_i0(),仅在设备代码中可用。
如前所述,数学函数的主机实现和设备实现是独立的。有关这些函数行为的更多详细信息,请参阅主机实现的文档。
5.5.5. 浮点功能的提供方式
CUDA 支持的数学函数通过以下方式提供:
x + y,x - y,x * y,x / y,x++,x--,x += y,x -= y,x *= y,x /= y.支持单精度、双精度和四倍精度类型,分别为
float、double和__float128/_Float128。通过分别包含
<cuda_fp16.h>和<cuda_bf16.h>头文件,还可以支持__half和__nv_bfloat16类型。对
__float128/_Float128类型的支持取决于主机编译器和设备计算能力,请参阅支持的浮点类型表。
它们在主机代码和设备代码中均可用。
它们的行为受
nvcc优化标志的影响。
CUDA C++ Standard Library 数学函数:
通过
<cuda/std/cmath>头文件和cuda::std::命名空间提供 C++<cmath>头文件函数的完整集合。支持 IEEE-754 标准浮点类型
__half、float、double、__float128,以及 Bfloat16__nv_bfloat16。对
__float128的支持取决于主机编译器和设备计算能力,请参阅支持的浮点类型表。
它们在主机代码和设备代码中均可用。
它们通常依赖CUDA Math API 函数。因此,主机代码与设备代码之间的准确度可能不同。
它们的行为受
nvcc优化标志的影响。根据 C++23 和 C++26 标准规范,部分功能也支持用于常量表达式,例如
constexpr函数。
CUDA C Standard Library 数学函数(CUDA Math API):
提供 C
<math.h>头文件函数的一个子集。支持单精度和双精度类型,分别为
float和double。它们在主机代码和设备代码中均可用。
它们不需要额外的头文件。
它们的行为受
nvcc优化标志的影响。
<math.h>头文件的部分功能也可用于__half、__nv_bfloat16和__float128/_Float128类型。这些函数的名称与 C 标准库中的函数名称相似。__half和__nv_bfloat16类型分别需要<cuda_fp16.h>和<cuda_bf16.h>头文件。它们在主机代码和设备代码中的可用性按各个函数分别定义。对
__float128/_Float128类型的支持取决于主机编译器和设备计算能力,请参阅支持的浮点类型表。相关函数需要crt/device_fp128_functions.h头文件,并且仅在设备代码中可用。
它们在主机代码与设备代码中的准确度可能不同。
提供不属于 C/C++ 标准库的数学功能。
主要支持单精度和双精度类型,分别为
float和double。它们在主机代码和设备代码中的可用性按各个函数分别定义。
它们不需要额外的头文件。
它们在主机代码与设备代码中的准确度可能不同。
仅有有限的一组函数支持
__nv_bfloat16、__half和__float128/_Float128。__half和__nv_bfloat16类型分别需要<cuda_fp16.h>和<cuda_bf16.h>头文件。对
__float128/_Float128类型的支持取决于主机编译器和设备计算能力,请参阅支持的浮点类型表。相关函数需要crt/device_fp128_functions.h头文件。它们仅在设备代码中可用。
它们的行为受
nvcc优化标志的影响。
支持单精度和双精度类型,分别为
float和double。它们仅在设备代码中可用。
它们比相应的CUDA Math API 函数更快,但准确度更低。
它们的行为不受
nvcc浮点优化标志-prec-div=false、-prec-sqrt=false和-fmad=true的影响。唯一的例外是-ftz=true,它也包含在-use_fast_math中。
功能 |
支持的类型 |
主机 |
设备 |
受浮点优化标志 |
|---|---|---|---|---|
|
✅ |
✅ |
✅ |
|
|
✅ |
✅ |
✅ |
|
|
||||
|
✅ |
✅ |
✅ |
|
|
按各个函数分别确定 |
|||
|
❌ |
✅ |
||
|
按各个函数分别确定 |
✅ |
||
|
❌ |
✅ |
||
|
❌ |
✅ |
仅受 |
|
*CUDA C++ Standard Library 函数支持对小型浮点类型进行查询,例如numeric_limits<T>、fpclassify()、isfinite()、isnormal()、isinf()和isnan()。
以下各节在适用时提供其中一些函数的准确度信息,使用 ULP 进行量化。有关最低有效位单位(ULP)定义的更多信息,请参阅 Jean-Michel Muller 的论文论 ulp(x) 的定义。
5.5.6. 内置算术运算符
用于单精度、双精度和四倍精度类型的 C/C++ 语言内置运算符,例如x + y、x - y、x * y、x / y、x++、x--以及倒数1 / x,均符合 IEEE-754 标准。使用舍入到最近值,中间值舍入到偶数的舍入模式时,它们保证最大 ULP 误差为零。它们在主机代码和设备代码中均可用。
nvcc编译标志-fmad=true(也包含在--use_fast_math中)允许将浮点乘法和加法/减法收缩为浮点乘加运算,并对单精度类型float的最大 ULP 误差产生以下影响:
x * y + z→ __fmaf_rn(x, y, z):0 ULP
nvcc编译标志-prec-div=false(也包含在--use_fast_math中)对单精度类型float的除法运算符/的最大 ULP 误差有如下影响:
x / y→ __fdividef(x, y):2 ULP1 / x:1 ULP
5.5.7. CUDA C++ 数学标准库函数
CUDA 通过cuda::std::命名空间全面支持C++ 标准库数学函数。这些功能是<cuda/std/cmath>头文件的一部分。它们在主机代码和设备代码中均可用。
以下各节说明与CUDA 数学 API的映射关系,以及各函数在设备上执行时的误差界限。
最大 ULP 误差是指函数返回值与按照舍入到最近值、中间值取偶数的舍入模式得到的相应精度的正确舍入结果之间,以 ULP 为单位的差值的绝对值的最大观测值。
这些误差界限来自广泛但并非穷尽的测试。因此,不保证这些界限。
5.5.7.1. 基本运算
用于基本运算的CUDA 数学 API在主机代码和设备代码中均可用,__float128除外。
以下所有函数的最大 ULP 误差均为零。
|
含义 |
|
|
|
|
|
|---|---|---|---|---|---|---|
的余数,计算方式为 |
N/A |
N/A |
||||
的余数,计算方式为 |
N/A |
N/A |
||||
的余数和商 |
N/A |
N/A |
N/A |
|||
__hfma(x, y, z),仅限设备 |
__hfma(x, y, z),仅限设备 |
|||||
N/A |
N/A |
|||||
由字符串表示得到的 NaN 值 |
N/A |
N/A |
N/A |
* 标记为“N/A”的数学函数不原生支持 CUDA 扩展浮点类型,例如 __half 和 __nv_bfloat16。在这些情况下,通过转换为 float 类型,然后将结果转换回原类型来模拟这些函数。
5.5.7.2. 指数函数
用于指数函数的CUDA 数学 API仅对float和double类型在主机代码和设备代码中均可用。
|
含义 |
|
|
|
|
|
|---|---|---|---|---|---|---|
|
hexp(x) |
hexp(x) |
expf(x) |
exp(x) |
__nv_fp128_exp(x) |
|
|
hexp2(x) |
hexp2(x) |
exp2f(x) |
exp2(x) |
__nv_fp128_exp2(x) |
|
|
|
|
expm1f(x) |
expm1(x) |
__nv_fp128_expm1(x) |
|
|
hlog(x) |
hlog(x) |
logf(x) |
log(x) |
__nv_fp128_log(x) |
|
|
hlog10(x) |
hlog10(x) |
log10f(x) |
log10(x) |
__nv_fp128_log10(x) |
|
|
hlog2(x) |
hlog2(x) |
log2f(x) |
log2(x) |
__nv_fp128_log2(x) |
|
|
|
|
log1pf(x) |
log1p(x) |
__nv_fp128_log1p(x) |
* 标记为“N/A”的数学函数不原生支持 CUDA 扩展浮点类型,例如 __half 和 __nv_bfloat16。在这些情况下,通过转换为 float 类型,然后将结果转换回原类型来模拟这些函数。
5.5.7.3. 幂函数
用于幂函数的CUDA 数学 API仅对float和double类型在主机代码和设备代码中均可用。
|
含义 |
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
powf(x, y) |
pow(x, y) |
__nv_fp128_pow(x, y) |
|
|
hsqrt(x) |
hsqrt(x) |
sqrtf(x) |
sqrt(x) |
__nv_fp128_sqrt(x) |
|
|
|
|
cbrtf(x) |
cbrt(x) |
|
|
|
|
|
hypotf(x, y) |
hypot(x, y) |
__nv_fp128_hypot(x, y) |
* 标记为“N/A”的数学函数不原生支持 CUDA 扩展浮点类型,例如 __half 和 __nv_bfloat16。在这些情况下,通过转换为 float 类型,然后将结果转换回原类型来模拟这些函数。
5.5.7.4. 三角函数
用于三角函数的CUDA 数学 API仅对float和double类型在主机代码和设备代码中均可用。
|
含义 |
|
|
|
|
|
|---|---|---|---|---|---|---|
|
hsin(x) |
hsin(x) |
sinf(x) |
sin(x) |
__nv_fp128_sin(x) |
|
|
hcos(x) |
hcos(x) |
cosf(x) |
cos(x) |
__nv_fp128_cos(x) |
|
|
|
|
tanf(x) |
tan(x) |
__nv_fp128_tan(x) |
|
|
|
|
asinf(x) |
asin(x) |
__nv_fp128_asin(x) |
|
|
|
|
acosf(x) |
acos(x) |
__nv_fp128_acos(x) |
|
|
|
|
atanf(x) |
atan(x) |
__nv_fp128_atan(x) |
|
|
|
|
atan2f(y, x) |
atan2(y, x) |
|
* 标记为“N/A”的数学函数不原生支持 CUDA 扩展浮点类型,例如 __half 和 __nv_bfloat16。在这些情况下,通过转换为 float 类型,然后将结果转换回原类型来模拟这些函数。
5.5.7.5. 双曲函数
用于双曲函数的CUDA 数学 API仅对float和double类型在主机代码和设备代码中均可用。
|
含义 |
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
sinhf(x) |
sinh(x) |
__nv_fp128_sinh(x) |
|
|
|
|
coshf(x) |
cosh(x) |
__nv_fp128_cosh(x) |
|
|
htanh(x) |
htanh(x) |
tanhf(x) |
tanh(x) |
__nv_fp128_tanh(x) |
|
|
|
|
asinhf(x) |
asinh(x) |
__nv_fp128_asinh(x) |
|
|
|
|
acoshf(x) |
acosh(x) |
__nv_fp128_acosh(x) |
|
|
|
|
atanhf(x) |
atanh(x) |
__nv_fp128_atanh(x) |
* 标记为“N/A”的数学函数不原生支持 CUDA 扩展浮点类型,例如 __half 和 __nv_bfloat16。在这些情况下,通过转换为 float 类型,然后将结果转换回原类型来模拟这些函数。
5.5.7.6. 误差函数与伽马函数
用于误差函数与伽马函数的CUDA 数学 API对于float和double类型,在主机代码和设备代码中均可用。
误差函数与伽马函数不原生支持 CUDA 扩展浮点类型,例如__half和__nv_bfloat16。在这些情况下,通过转换为float类型,然后将结果转换回原类型来模拟这些函数。
5.5.7.7. 舍入至最近整数的浮点运算
用于舍入至最近整数的浮点运算的CUDA 数学 API仅对float和double类型在主机代码和设备代码中均可用。
以下所有函数的最大 ULP 误差均为零。
|
含义 |
|
|
|
|
|
|---|---|---|---|---|---|---|
截断为整数 |
||||||
舍入到最近的整数,中间值向远离零的方向舍入 |
N/A |
N/A |
||||
舍入到最近的整数,中间值取偶数 |
N/A |
N/A |
N/A |
|||
舍入到最近的整数,中间值取偶数 |
||||||
舍入到最近的整数,中间值取偶数(返回 |
N/A |
N/A |
N/A |
|||
舍入到最近的整数,中间值取偶数(返回 |
N/A |
N/A |
N/A |
|||
舍入到最近的整数,中间值向远离零的方向舍入(返回 |
N/A |
N/A |
N/A |
|||
舍入到最近的整数,中间值向远离零的方向舍入(返回 |
N/A |
N/A |
N/A |
* 标记为“N/A”的数学函数不原生支持 CUDA 扩展浮点类型,例如 __half 和 __nv_bfloat16。在这些情况下,通过转换为 float 类型,然后将结果转换回原类型来模拟这些函数。
性能注意事项
将单精度或双精度浮点操作数舍入为整数的推荐方法是使用函数rintf()和rint(),而不是roundf()和round()。这是因为roundf()和round()在设备代码中映射为多条指令,而rintf()和rint()映射为一条指令。truncf()、trunc()、ceilf()、ceil()、floorf()和floor()也各自映射为一条指令。
5.5.7.8. 浮点数处理函数
用于浮点数处理函数的CUDA 数学 API在主机代码和设备代码中均可用,__float128除外。
浮点数处理函数不原生支持 CUDA 扩展浮点类型,例如__half和__nv_bfloat16。在这些情况下,通过转换为float类型,然后将结果转换回原类型来模拟这些函数。
以下所有函数的最大 ULP 误差均为零。
|
含义 |
|
|
|
|---|---|---|---|---|
提取尾数和指数 |
||||
提取整数部分和小数部分 |
||||
N/A |
||||
N/A |
||||
N/A |
||||
朝方向的下一个可表示值 |
N/A |
|||
将的符号复制到 |
5.5.7.9. 分类与比较
用于分类与比较函数的CUDA 数学 API在主机代码和设备代码中均可用,__float128除外。
以下所有函数的最大 ULP 误差均为零。
|
含义 |
|
|
|
|
|
|---|---|---|---|---|---|---|
对进行分类 |
N/A |
N/A |
N/A |
N/A |
N/A |
|
检查是否为有限值 |
N/A |
N/A |
N/A |
|||
检查是否为无穷值 |
N/A |
|||||
检查是否为 NaN |
||||||
检查是否为正规数 |
N/A |
N/A |
N/A |
N/A |
N/A |
|
检查符号位是否已置位 |
N/A |
N/A |
N/A |
|||
检查是否 |
N/A |
N/A |
N/A |
|||
检查是否 |
N/A |
N/A |
N/A |
|||
检查是否 |
N/A |
N/A |
N/A |
|||
检查是否 |
N/A |
N/A |
N/A |
|||
检查是否或 |
N/A |
N/A |
N/A |
|||
检查、或两者是否为 NaN |
N/A |
N/A |
N/A |
N/A |
* 标记为“N/A”的数学函数不原生支持 __half 和 __nv_bfloat16 等 CUDA 扩展浮点类型。
5.5.8. 非标准 CUDA 数学函数
CUDA 提供了不属于 C/C++ 标准库、而是作为扩展提供的数学函数。对于单精度和双精度函数,其在主机和设备代码中的可用性按函数分别定义。
本节规定了各函数在设备上执行时的误差界限。
最大 ULP 误差表示函数返回值与按照舍入到最近值、相等时取偶数的舍入模式获得的相应精度的正确舍入结果之间,以 ULP 为单位的差值的绝对值的最大观测值。
误差界限来自广泛但并非穷尽的测试。因此,这些界限不受保证。
含义 |
|
|
|---|---|---|
fdividef(x, y),仅限设备 |
|
|
|
exp10f(x) |
exp10(x) |
|
norm3df(x, y, z),仅限设备 |
norm3d(x, y, z),仅限设备 |
|
norm4df(x, y, z, t),仅限设备 |
norm4d(x, y, z, t),仅限设备 |
|
normf(dim, p),仅限设备 |
norm(dim, p),仅限设备 |
rsqrtf(x) |
rsqrt(x) |
|
rcbrtf(x) |
rcbrt(x) |
|
rhypotf(x, y),仅限设备 |
rhypot(x, y),仅限设备 |
|
rnorm3df(x, y, z),仅限设备 |
rnorm3d(x, y, z),仅限设备 |
|
rnorm4df(x, y, z, t),仅限设备 |
rnorm4d(x, y, z, t),仅限设备 |
|
|
rnormf(dim, p),仅限设备 |
rnorm(dim, p),仅限设备 |
|
cospif(x) |
cospi(x) |
|
sinpif(x) |
sinpi(x) |
|
sincospif(x, sptr, cptr) |
sincospi(x, sptr, cptr) |
|
normcdff(x) |
normcdf(x) |
|
normcdfinvf(x) |
normcdfinv(x) |
|
erfcinvf(x) |
erfcinv(x) |
|
erfcxf(x) |
erfcx(x) |
|
erfinvf(x) |
erfinv(x) |
|
cyl_bessel_i0f(x),仅限设备 |
cyl_bessel_i0(x),仅限设备 |
|
cyl_bessel_i1f(x),仅限设备 |
cyl_bessel_i1(x),仅限设备 |
|
j0f(x) |
j0(x) |
|
j1f(x) |
j1(x) |
|
jnf(n, x) |
jn(n, x) |
|
y0f(x) |
y0(x) |
|
y1f(x) |
y1(x) |
|
ynf(n, x) |
yn(n, x) |
用于__half、__nv_bfloat16和__float128/_Float128的非标准 CUDA 数学函数仅在设备代码中可用。
含义 |
|
|
|
|---|---|---|---|
hrcp(x) |
hrcp(x) |
|
|
|
hexp10(x) |
hexp10(x) |
__nv_fp128_exp10(x) |
hrsqrt(x) |
hrsqrt(x) |
|
|
|
htanh_approx(x) |
htanh_approx(x) |
|
5.5.9. 内建函数
数学内建函数是其对应的CUDA C 标准库数学函数的速度更快、精度更低的版本。
它们使用相同的名称,并加上
__前缀,例如__sinf(x)。它们仅在设备代码中可用。
它们速度更快,因为它们映射到更少的原生指令。
标志
--use_fast_math会自动将相应的CUDA Math API 函数转换为内建函数。受影响函数的完整列表请参见–use_fast_math的影响一节。
5.5.9.1. 基本内建函数
一部分数学内建函数允许指定舍入模式:
带有
_rn后缀的函数使用舍入到最近值、相等时取偶数的舍入模式进行运算。带有
_rz后缀的函数使用向零舍入的舍入模式进行运算。带有
_ru后缀的函数使用向上舍入(朝正无穷方向)的舍入模式进行运算。带有
_rd后缀的函数使用向下舍入(朝负无穷方向)的舍入模式进行运算。
__fadd_[rn,rz,ru,rd]()、__dadd_[rn,rz,ru,rd]()、__fmul_[rn,rz,ru,rd]()和__dmul_[rn,rz,ru,rd]()函数映射到加法和乘法运算,编译器绝不会将这些运算合并为FFMA或DFMA指令。相比之下,由*和+运算符生成的加法和乘法通常会合并为FFMA或DFMA。
下表列出了单精度和双精度浮点内建函数。它们的最大 ULP 误差均为 0,并且均符合 IEEE 标准。
含义 |
|
|
|---|---|---|
5.5.9.2. 仅限单精度的内建函数
下表列出了单精度浮点内建函数及其最大 ULP 误差。
最大 ULP 误差表示函数返回值与按照舍入到最近值、相等时取偶数的舍入模式获得的相应精度的正确舍入结果之间,以 ULP 为单位的差值的绝对值的最大观测值。
误差界限来自广泛但并非穷尽的测试。因此,这些界限不受保证。
函数 |
含义 |
最大 ULP 误差 |
|---|---|---|
当时为 |
||
0 ULP |
||
由 |
||
▪ 当时,绝对误差为 |
||
▪ 当时,绝对误差为 |
||
▪ 当时,绝对误差为 |
||
▪ 当时,绝对误差为 |
||
▪ 当时,绝对误差为 |
||
按分量分别与 |
||
由 |
||
▪ 最大相对误差: |
5.5.9.3. --use_fast_math的影响
nvcc编译器标志--use_fast_math会将在设备代码中调用的一部分CUDA Math API 函数转换为对应的内建函数。注意,CUDA C++ 标准库函数也受此标志影响。有关使用内建函数代替 CUDA Math API 函数所产生影响的更多详细信息,请参见内建函数一节。
一种更稳健的方法是有选择地将数学函数调用替换为内建版本,仅在性能提升值得这样做,并且可以接受精度降低和特殊情况处理方式不同等属性变化的地方进行替换。
设备函数 |
内建函数 |
|---|---|
5.5.10. 参考文献
Jean-Michel Muller。关于 ulp(x) 的定义。INRIA/LIP 研究报告,2005 年。
Nathan Whitehead、Alex Fit-Florea。精度与性能:NVIDIA GPU 的浮点运算及 IEEE 754 合规性。Nvidia 报告,2011 年。
David Goldberg。每位计算机科学家都应了解的浮点算术知识。《ACM 计算综述》,1991 年 3 月。
David Monniaux。验证浮点计算时的陷阱。《ACM 编程语言与系统汇刊》,2008 年 5 月。
Peter Dinda、Conor Hetland。开发者理解 IEEE 浮点数吗?。IEEE 国际并行与分布式处理研讨会(IPDPS),2018 年。